日志保留几份和保留几天是两件事:轮转数值的四个误读|洹拓科技
一、切不切与留多少是两套数值
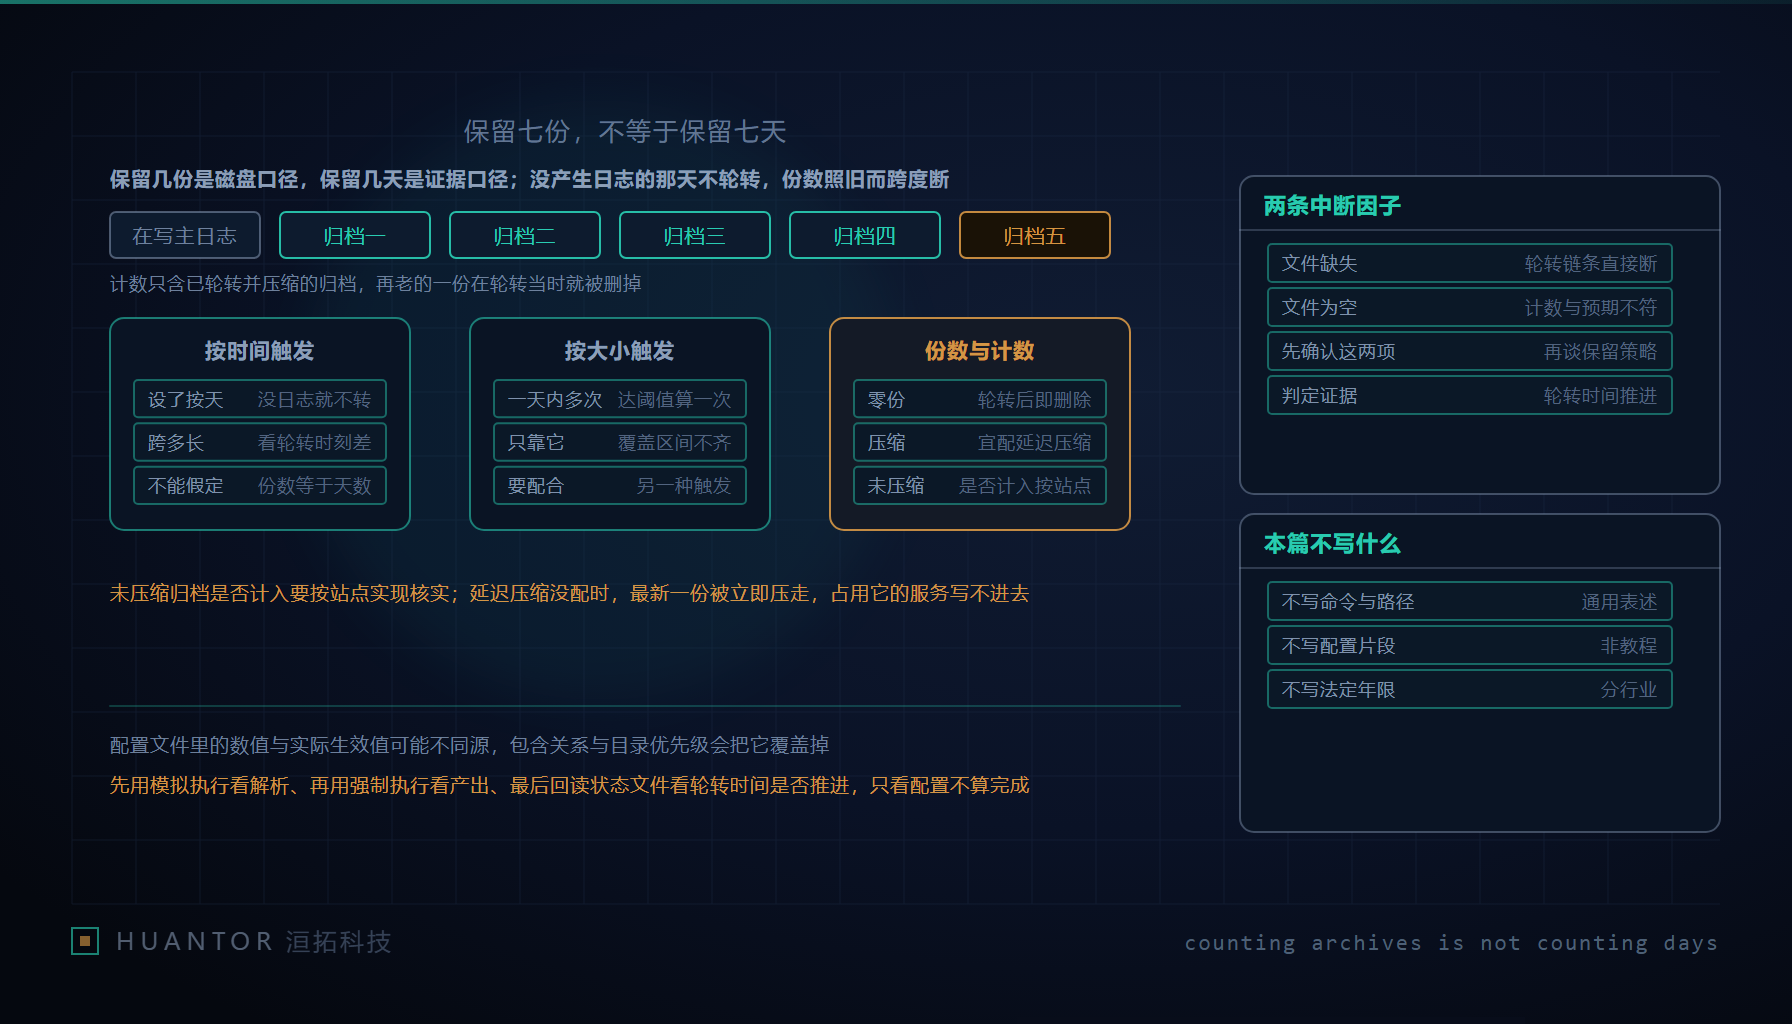
日志轮转这件事上有两组彼此独立的数值。第一组决定什么时候切一刀,有三种口径:按时间切、按大小切、两条一起用取先到者。第二组决定切完留几份,也就是历史归档的保留数量。组外还有一个不占名额的隐含项:当前正在写的那份主日志,它永远不计入保留数量。
最容易出的错,是拿第二组去回答第一组的问题。保留 5 份写在那里,读的人会顺手补一句“等于留了 5 天”。这句话只在写入速率平稳时成立。日志的写入速率从来不平稳:一次集中的批量任务、一轮调试期临时放开的详细输出、一个刚接入的新服务,都能让同样的 5 份归档实际覆盖的时间跨度差出一个量级,紧凑的时候只装得下几天,松散的时候把一整个观察期都压在里头。反过来,一段长期空闲的服务可能好些天才写出不到一个归档的量。
所以要谈“这份日志实际覆盖了多长时间”,不能靠换算,只能靠回查。状态文件里每条日志都带有一个末次轮转时间,把它和归档序列自身的落盘时间放在一起看,相邻两份的时间差就是这段归档的覆盖区间。差值离散度大,说明按时间切这条口径已经名存实亡;差值稳定,才可以说保留多少份大致等于覆盖多少个周期。这个回算动作应当进基线核查,而不是等合规问询时现找。
二、四个误读各自混掉了什么
四个误读不是四个知识盲区,而是四处口径串线。先用一张表把它们各自混掉的两件事写清楚,后面几节再逐条展开对应的处理。
| 误读 | 把哪两件事当成一件 | 要分开看的两样 |
|---|---|---|
| 认为保留几份就是保留几天 | 保留数量与切分周期 | 归档件数、由末次轮转时间回算出的覆盖区间 |
| 设了按天切就以为每天都有归档 | 调度周期与写入事实 | 调度是否执行、该周期内是否真的产生日志 |
| 认为按大小切就能一天切多次 | 阈值达到与触发次数 | 单位时间写入量、单个周期内的触发次数 |
| 认为改完数值就算生效 | 配置项与链条完整性 | 目标数值、会中断链条的那两项容忍设置 |
第二行值得多说一句。按时间切这条口径,判的是到点了没有,不是有没有内容可切。某天服务没有产生日志,轮转就不会产出新归档,序列里就少一格。于是保留 7 份在这种服务上对应的实际时长会明显长于名义上的周期数。这不是配置写错,是口径本身如此,只有回算覆盖区间才能发现,而且发现之后往往要改的是说法而不是数值:对外答复里写“覆盖若干个完整周期,实际区间见回算结果”,比直接写份数诚实得多。
第三行的麻烦方向相反。写入量涨得极快时,一个周期内早就越过了大小阈值,但触发仍按单个周期一次来处理,于是主日志越写越大,要等到下一次轮转才被切走。这一类要靠另一条触发口径配合,光把保留数量加大没有用,反而会让磁盘曲线看起来更危险。
三、置零、主日志与未压缩归档三处计数偏差
保留数量设为 0 的语义是不保留任何旧归档:切完一刀,旧内容随即删除。这个值不是不能设,而是要看清它落在哪类日志上,因为一旦置零,丢失的不是空间而是证据的可得性——事发之后想回查那一段,磁盘上已经没有任何副本。
我们把日志分成两类来定这条规矩。允许置零的,是内容可从别处重建、或本身不承载事实认定的运行期输出,例如调试期临时放开的详细日志、监控体系里另有一份的采集记录。不允许置零的,是这件事只在日志里留下过痕迹的那一类:安全审计、权限变更、资金与凭证相关的操作流水。后一类被置零,等于把证据保留寄托在别的系统上,而那个系统并不为这条链路的完整性负责,出问题时也说不出它覆盖到哪一刻。
第二处偏差来自统计口径本身:保留数量只统计已经轮转并且压缩过的归档,当前主日志不在其中。配置写着 5,实际留在磁盘上的内容覆盖的是“5 个归档加一整段正在写的主日志”。这个差在最坏情况下不小——主日志体积完全可能是单个归档的好几倍。向审计或客户答复覆盖时长时漏掉这一段,就会低估;反过来,估算磁盘水位时把它当成可忽略项,又会高估剩余空间。
第三处偏差是未压缩的归档算不算一份。不同实现不一致:有的按压缩后的形态计数,有的只要文件还在序列里就计入。这一项不能凭直觉,只能在自己的环境里跑一次模拟执行确认,并把结论写进运维基线。否则同一套配置在不同人手里交接一次,答案变一次,而所有人都以为自己在按规矩办事。
四、延迟压缩与文件占用:只在轮转那一次暴露
启用了压缩,就要同时确认是否配置了延迟压缩。原因是两个动作会撞在同一时刻:一边是刚切走的文件被立刻压成归档,一边是某些服务仍然握着原文件的写入句柄继续写。句柄还在,文件形态已经变了,后续写入的结果就落在大家预期的位置之外。
这类问题的表现形态很有特点。平时看不出异常,日志照常写、磁盘照常涨,直到轮转真正触发的那一次才暴露——服务侧丢了一段输出,或者归档里缺了一角。因为触发频率低,它躲得过日常巡检,也躲得过只看容量趋势的告警。所以“配置了压缩但没配延迟压缩”这一条要单独进核查表,判定方式不是读配置文本,而是在模拟执行里看它把哪些文件列为会被立即处理的那一份。
顺带说一句,模拟执行本身不改动文件,因此也可以用它来确认保留数值到底有没有被识别——包括这个数值写在服务专属位置还是全局位置、两处同时存在时实际读到的是哪一份。这类确认成本低,适合作为变更单里的固定一步。
五、先排两条中断因子,再走三段验证
在谈任何保留策略之前,先把链条会不会中断排掉。最容易导致中断的情形有两种:日志文件缺失,以及日志文件为空。默认行为下,遇到这两种情形轮转链条就停在那里,后面的归档既不产出也不删除,保留数量与预期自然对不上,而且对不上的方向是“你以为还在,其实早断了”。
排查顺序我们固定成三步。第一步看状态文件里的末次轮转时间有没有推进;没有推进,才往下走。第二步查这条日志的路径与文件是否真的存在、是否为空,尤其是被别的清理流程移走或截断过的情况。第三步看这两项容忍是否显式配置过。判定证据始终是时间有没有推进,不是配置里有没有那一项——写没写进文件,不等于轮到它执行。
验证分三段,一段比一段贵。第一段是调试模式下的模拟执行:不实际改动文件,能确认数值是否被识别、哪些文件会受影响、归档会被排进哪个序列。第二段是强制立即执行一次,看真实产出,此时磁盘占用会临时上涨,要安排在有余量的时段做。第三段是回读状态文件,确认末次轮转时间确实推进到这一次。三段各管一件事,缺一段就有一个盲区:第一段管解析,第二段管产出,第三段管是否真的落进调度。
只看配置文件不算完成,原因有两条。一是同一个数值可以落在全局位置也可以落在服务专属位置,两处同时存在时文件里的值不一定就是生效值;二是包含关系与目录优先级会让实际读到的那份配置不是你以为的那一份。所以核验的落点始终是回读到了什么,而不是写了什么。这对我们做交付的提醒很直接:把保留策略交给客户时,验收项要写成回查动作,不能写成一段配置文本。
六、运维口径与合规口径分列,再谈两条实现路线
按份数保留是磁盘治理,按时间保留是证据治理。两套口径的目标、单位、失败模式和核验方式都不一样,混在一张表里去谈,一定会有一方不满意。
| 对比项 | 运维口径 | 合规口径 |
|---|---|---|
| 目标 | 控磁盘占用 | 满足留存期要求 |
| 单位 | 份 | 天 |
| 失败模式 | 磁盘打满,服务写不进去 | 证据不足,查不到事发那一段 |
| 核验方式 | 容量趋势与归档体积变化 | 由末次轮转时间差值回算覆盖区间 |
| 责任方 | 值班与容量管理 | 审计与业务责任人 |
两套都要满足时,实现路线有两条,选哪条取决于服务能否承受双份开销。一条是按时间为主、容量兜底:以覆盖时长为设计目标,先用回算确认归档序列够长,再按峰值速率把保留数量抬到能容纳这段时间的值,并预先写清磁盘接近上限时的处置顺序。另一条是双策略分目录:把承载证据的那部分单独放进一套只按时间、不做激进清理的目录,运行期噪声放进另一套按容量收缩的目录,两套各自有独立的容忍配置与核验记录。
第二条路线在我们的交付里更常见,因为它把“谁在乎这份日志”这件事写进了目录结构,交接时不必再解释口径。但要提防一点:分了目录不等于分清了口径,两条链路的末次轮转时间要各自可查,否则又回到拿份数充天数的老问题。
轮转配置里真正难的不是数值本身,而是把它读成一份可核查的承诺:留了几份、实际覆盖多久、链条有没有断、需要回查的那一段还在不在。洹拓把这类配置踩过的坑归成一句话——先算覆盖区间,再谈满不满足留存要求;算不出区间的时候,任何一份答复都只是把份数念得更好听一些。