
链路在异步那一跳断了:断链成因与采样的代价|洹拓科技
一、断链不是一件事,是四类事
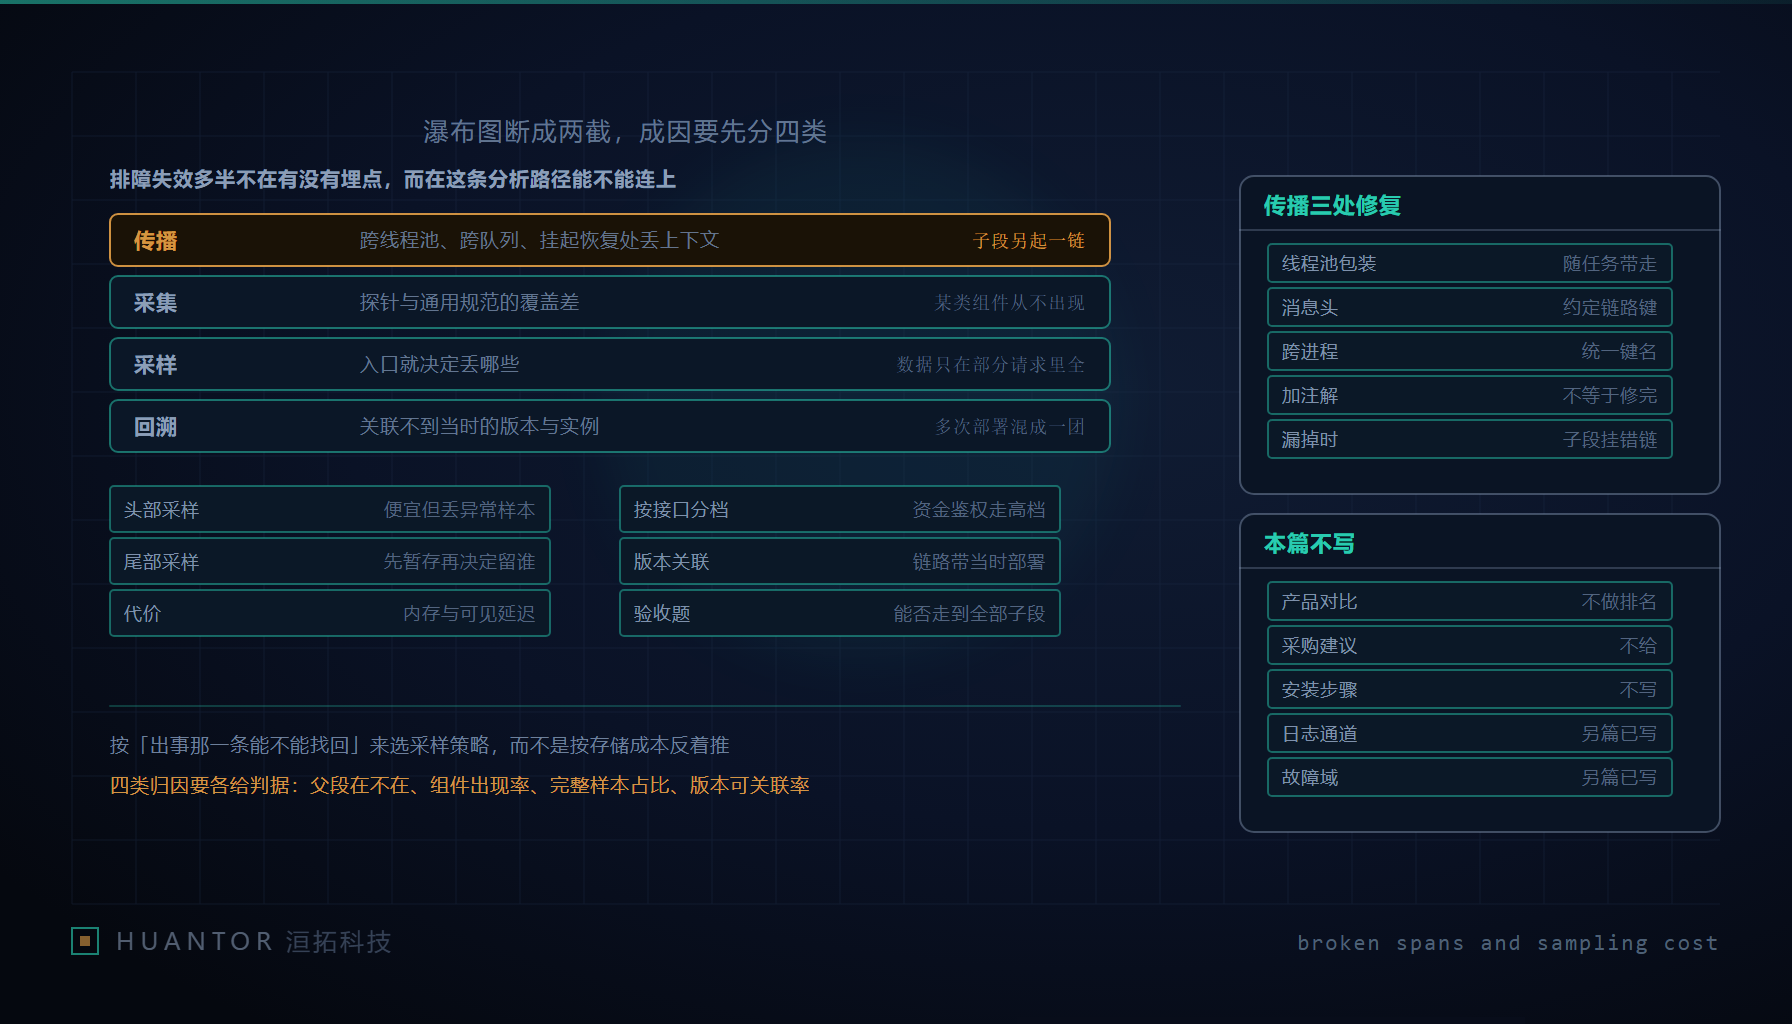
排障时最常见的画面,是链路瀑布图断成两截:上游那一截清清楚楚,下游那一截自成一条没有来路的链路,中间空着。多数团队的第一反应是补埋点,补完发现图还是断的。因为断链根本不是一件事,而是四类事:传播、采集、采样、回溯,每一类的判据与处理路径都不一样。
- 传播类:父段在,子段却挂到了别的调用链上,或者独立成一条没有父亲的链路;
- 采集类:某一类组件在所有链路里都不出现,缺失是整齐划一的;
- 采样类:数据存在,但只在一部分请求里是完整的,同一条链路可能只有半截;
- 回溯类:链路完整,却关联不到那次调用对应的镜像版本与实例。
一篇微服务可观测性文章把这归因到链路数据模型本身:一次调用与其中各段的父子关系才是链路的骨架,而排障失效的原因往往不在“有没有埋点”,而在探针与通用采集规范之间的覆盖差异,以及从瀑布图下钻、依赖拓扑到资源联动的分析路径能不能连上。落到分诊纪律上,就是先看断口形态、归好类,再走对应处置。拿“再加一个采集端”去救采样类断链,只会多出一份照样看不见故障样本的数据。可观测性预算怎么花,取决于四类问题各占多少,而不是图上哪里最难看。
二、传播类:上下文在跨线程那一跳丢
链路能被串起来,靠的是调用上下文一路随请求走:一次请求进来,系统里生成或接续一个链路标识,之后每一段工作都挂在这个标识下面。断点通常出现在三段没人盯着的地方。
- 跨线程池:任务被提交进线程池,真正执行它的线程不继承提交方的上下文,于是子段要么找不到父亲,要么认领了别的链路;
- 跨消息队列:消息体里装了业务字段,链路键没进消息头,消费端从消息里读不出“这是谁的下游”;
- 协程与异步函数:执行在挂起与恢复之间换了载体,上下文在挂起点丢一次,恢复之后的所有子段都成了孤儿。
修复不是“加个注解”就完事,有三处必须成套覆盖。第一处是包装线程池:任务提交时拍下上下文快照、执行前恢复、完成后清理,做成基础设施层的统一封装,而不是散落在各处的手写样板。第二处是消息头字段约定:哪类链路键写进消息的哪个字段,生产端与消费端按同一份约定走,并把约定写进接口文档。第三处是跨进程统一键名:不同语言、不同进程之间要认同一套键的名字,一个服务写下的键另一个服务不认,链路的连通就只能碰运气。这三处缺一处,断点就会从缺的那一处冒出来。判据也简单:盯“无父链路”的数量,它在上涨,说明传播这一类还有洞。
三、采集类与回溯类:整段缺失与认不出是谁
采集类问题的形态是覆盖差异:探针与通用采集规范之间总有缝隙,某些自研的连接池、小众的远程调用框架、批处理作业,可能整体不在采集端的识别范围里。判据是按组件类型看,而不是按请求看:这类组件在任何一条链路里都不出现,缺失整齐划一,那是采集问题,不是业务没走到。处理上有两条:对分析路径上的关键段落,按统一约定手工补上缺失的段;同时在文档里写明哪些组件本来就不可见,防止把“图上没有”读成“没发生”。
回溯类是容器环境独有的麻烦。实例与版本随部署滚动,一次线上故障过去之后,图里的服务名对应的早已不是出事那一刻的那一版。两个具体症状:同一服务名下叠了好几次部署,在拓扑图里混成一团,分不清慢的是哪个版本;扩容缩容之后,子段落在已经不存在的实例上,点进去什么都没有。处置办法是让链路数据带上部署版本与实例标识,让回溯视图按版本聚合:查历史故障时先锁定当时的版本,再看它名下的实例。这要求链路的元数据与发布流水线对齐,属于平台侧的职责,不该摊到业务代码里。
四、头部采样与尾部采样:省存储与保故障的取舍
全量链路的存储与处理开销,多数系统扛不住,所以要有采样。两种策略的代价完全不同。
头部采样在请求进入系统的那一刻决定留不留,之后不再反悔。它省掉暂存成本,采集与处理压力按采样率等比下降。弱点也直接:它按概率抽样,不认异常。低频路径上的错误,连同它身后完整的因果链,会被一起丢掉。排障时你看得见的那条链路里,恰好没有出事的那一条。
尾部采样反过来:先把全量数据暂存一段时间,等调用结束、结果可知了再决定留哪些,出错或超时的链路全留,健康的按比例抽。它保住的正是“出事那一条看得见”。代价是暂存期的内存占用,以及数据从产生到可见之间多出来的一段延迟:故障发生的那一刻,图可能还不完整。
选型的问题只有一个:出事那一条能不能找回。按这个标准,交易与资金类系统几乎没有悬念。尾部采样还有一道容易被忽略的前提:判定要靠错误标记沿链路传上来,如果传播本身断了,尾部也收不到“这里出过事”的信号,等于白留。采样与传播不是并列的两件事,前者站在后者的肩膀上。
五、采样档位要按接口分类写明
采样率不该是全局一个数。我们按接口分类定档位:涉及资金、鉴权、下单的关键路径走高档位,接近全量留存;普通查询、报表拉取走低档位,保住趋势就够。档位要连同含义一起写进文档:高是什么概念、低是什么概念、谁有权调、调整依据什么。责任落到人头上,采样档位才是可治理的配置,而不是没人敢碰的暗档。
三个常见的坑值得点名。一是一刀切:一个采样率管所有接口,关键故障样本的保留概率被普通流量稀释。二是档位只有平台团队知道:业务方不知道哪条链路可能被丢,出了事第一时间怀疑系统坏了。三是改档位不留记录:复盘时无法回答“那条故障请求当时有没有可能被采到”,这个问题没有答案,归因就会滑向猜测。档位不必频繁调整,但每次调整必须可回溯,调档记录本身也是链路数据的一部分。
六、用一次真实故障做验收
链路体系的验收题不该是“埋点覆盖率”这种数字游戏,而是一次真实的走通:拿一个失败请求,从它出发,能不能一路走到它的全部下游子段。走通一次,四类问题一起体检;走不通,把断点按四类分别归因,统计各型占比,先治占比最大的那一型。
| 成因类别 | 表现 | 判据 | 处置 |
| 传播 | 子段挂错链路,或独立成无父链路 | 盯无父链路的数量,看它是否随发布上涨 | 包装线程池、消息头字段约定、跨进程统一键名三处成套覆盖 |
| 采集 | 某类组件在所有链路里都不出现 | 缺失按组件类型整齐划一,而非随机分布 | 关键段按约定手工补段,文档写明不可见范围 |
| 采样 | 数据存在,但只在部分请求里完整 | 同一路径的链路时有时无,缺失与流量比例对应 | 关键接口走高档位,尾部采样按错误与延迟留样 |
| 回溯 | 链路有,关联不到对应的镜像版本与实例 | 同一服务名下多次部署混成一团 | 链路带部署版本与实例标识,回溯视图按版本聚合 |
在洹拓给客户做云服务可观测性交付时,我们把这张表和“一个失败请求走通全下游”的实测当作验收项:先归因、再补链路、后调采样档位,顺序不能反。链路数据模型里一次调用与各段的父子关系,平时看不见摸不着,只有断过一次才知道它值多少。埋点有没有从来不是问题,出事那一条链路能不能完整找回来,才是。