
会话开了没关:同一会话标识的请求被排成一条队|洹拓科技
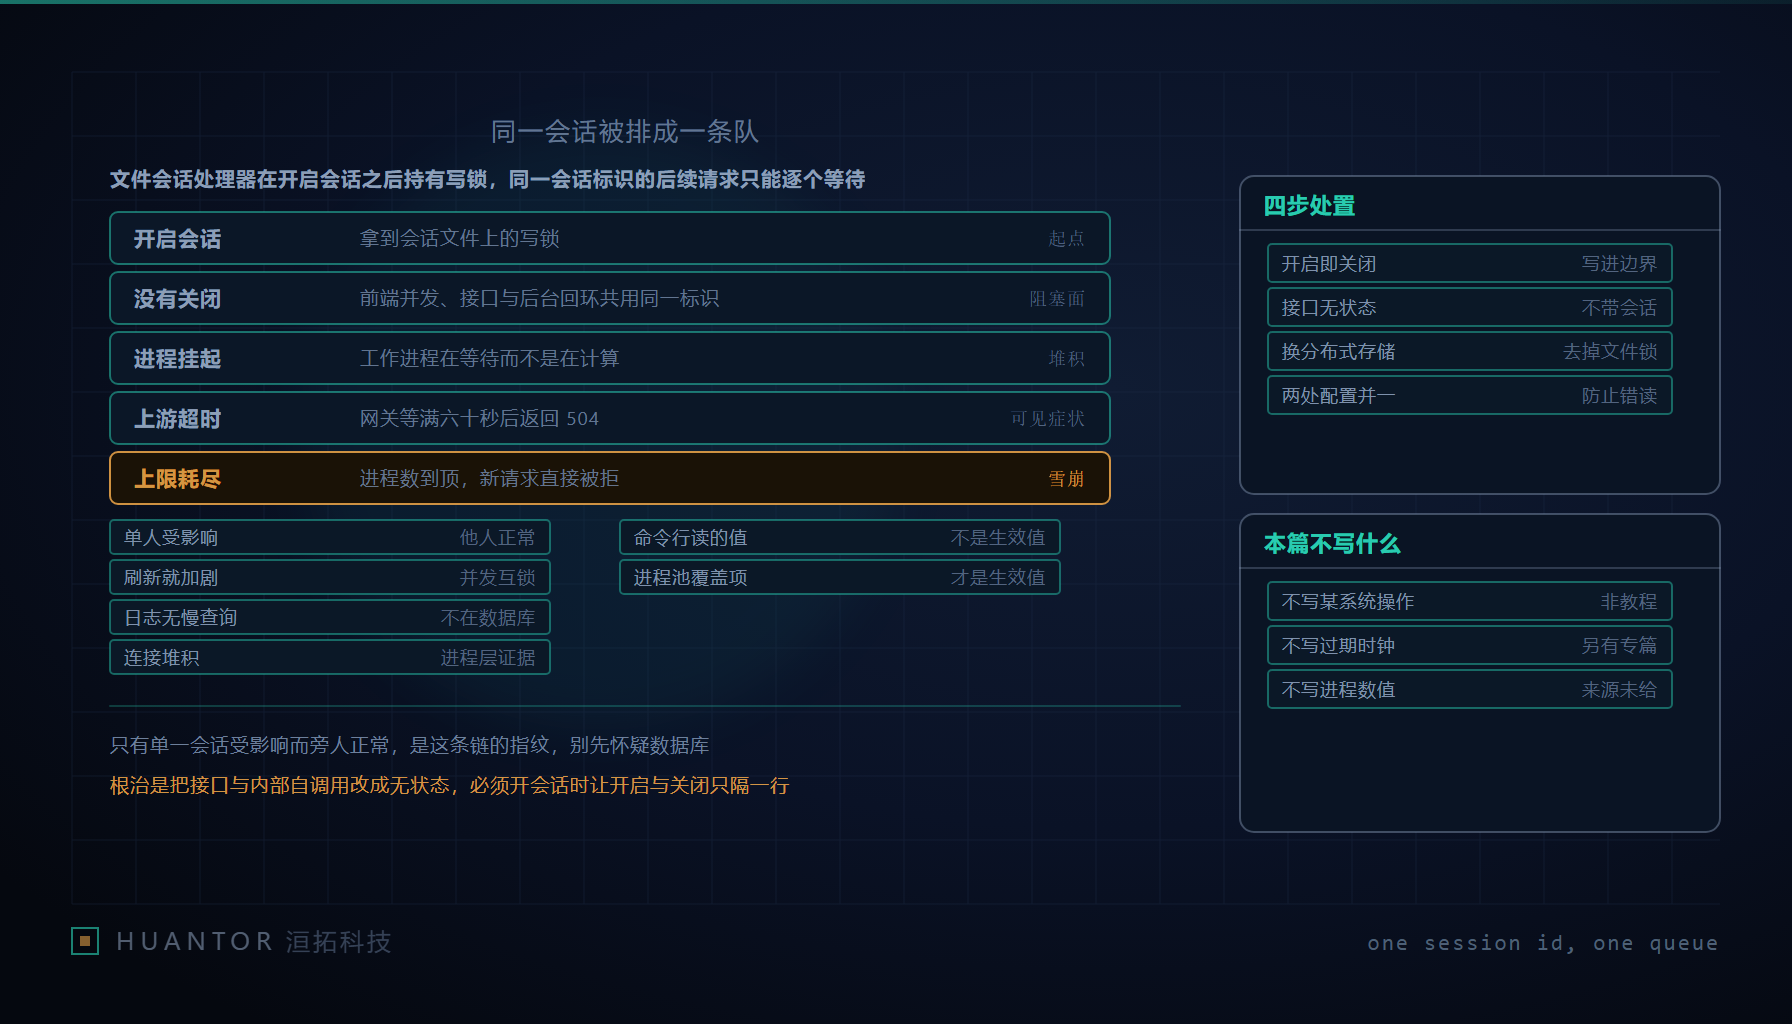
一、把 504 的因果从超时值扭到串行
网关返回 504,运维的第一反应几乎都一样:把上游读超时从默认的六十秒往上调,再重启一次服务。症状会缓解一阵,然后回来,而且回来的时候更难看。这个方向从一开始就把因果搞反了。超时的数值只是队列最终撞上的那堵墙,不是排队的原因。真正在排队的是同一个会话标识下的请求。
一次页面加载并不是一笔请求。主文档、页面里并发发出的好几个接口调用、可能还有后台任务自己回调本机的一次请求,它们用的是浏览器里同一个会话标识。会话一旦被开启,后面这些请求就不是并发处理,而是一个接一个地等同一个对象释放。等待的时间累加起来,很容易超过上游读超时,于是网关侧看到的是 504,而不是某个慢查询或者某个下游挂掉。用户多点一下、页面多并发几个请求,就把自己锁死了:并发的请求越多,自我制造的队列越长,排在末尾的那几个就越接近超时。所以洹拓接到这类工单时,第一件要纠正的判断是,别急着动超时值,先去看这些请求是不是共用了一个会话标识。
二、文件会话处理器的写锁如何把并发排成一条队
要理解为什么是串行,得看清楚文件型会话处理器的行为。这类处理器在开启会话时,会对会话对应的那个文件加写锁,这把锁在整个请求处理期间一直被持有,直到脚本结束或者被显式关闭。关键点在于,锁是按会话标识来组织的,不是按这次请求是否要写会话内容来组织的。也就是说,哪怕后一个请求只是读一下会话里的某个状态,它也得等前一个请求把锁放开。
这把锁一旦和慢操作叠加,杀伤力就显出来了。如果开启会话的那个请求里还包含一次外部调用、一段耗时较长的处理,那么写锁会一直握着不放,同会话的第二个请求整段时间都被挂起。挂起的请求不消耗 CPU,但它占着一个工作进程。工作进程被这些只在等锁的请求一点点吃满,就是后面雪崩的伏笔。把会话尽早关闭,本质上是把锁的持有时长从整个请求压缩到取数那一段,这是这条链上成本最低的止血动作。
三、三类被阻塞请求的共性:它们用的是同一个会话标识
现场里被这条链拖住的请求,通常归为三类。把它们并排放,共性一目了然。
- 前端页面并发发出的多个接口调用,它们天然带同一个会话标识。
- 走某类内容管理系统自带 REST 接口的请求。接口路径本来不该进入有状态会话,但它在初始化、加载、注册这几类钩子里开了会话,于是每一次接口调用都排队。
- 由计划任务、页面预览、自动更新触发的本机回环请求。这类请求看起来和服务态会话毫无关系,恰恰是它最容易把锁长时间占住。
第三类需要多说一句,因为它是归因时最容易被漏掉的一环。内容管理系统的计划任务或自动更新,会用 HTTP 的方式回调自己的本机端口,发起一次回环请求;这次请求沿用了站点当时的会话上下文,带上了同一个会话标识,因而和真实用户的接口调用落在同一把锁上。而更新、安装这类任务往往耗时很长,写锁握得久,把本该毫秒级返回的接口压在后面。用户那边点一下没反应、再点一下转圈,服务端却是本机自己在等自己。判断这个看起来和业务无关的后台调用为什么会拖住接口,答案就是它带了会话标识。
四、现场判据:只有单一会话受影响是这条链的指纹
文件写锁是按会话标识分的,这决定了它有一个非常干净的指纹:只有单一用户、单一浏览器会话受影响,别人访问同一个页面一切正常。抓住这条指纹,就能把它和另外两类常见故障分开。
| 现象形态 | 对应层面 | 一条判据 |
|---|---|---|
| 只有个别会话卡,换一个人访问正常 | 会话写锁串行 | 用一个全新的无痕会话去复现,复现不出来 |
| 全站普遍变慢,谁访问都慢 | 数据库或缓存 | 与具体会话无关,看慢查询与缓存命中 |
| 依赖某个外部服务的请求成批失败 | 下游依赖 | 看该服务自身健康状态,与其他会话同态 |
实操上,我们让报障方在另一个无痕窗口里走同样的操作:无痕会话没有沿用出问题的那个会话标识,不排队,接口就正常返回;而回到出问题的会话,多开几个并发请求立刻触发 504。这一组对照能很快把全局慢查询、下游挂了这两个方向排除掉,因为它们不会只对单一会话生效。反过来,如果你观察到同一台机器上所有人都慢,那基本不是这条链,别在会话配置上浪费时间。
五、配置来源要查两处:命令行与进程池不是一回事
排查里最容易翻车的一步,是在错误的地方看配置,然后在错误的地方改。命令行里跑的会话诊断,读出来的是命令行环境的配置;而 Web 侧真正生效的会话处理器,是由进程池配置里的 php_admin_value[session.save_handler] 决定的。两者的取值可以完全不同。更要命的是,进程池里这一项的优先级很高,它会覆盖掉全局声明的值。
这就解释了改了但没生效这个高频困惑:你在命令行配置或某个全局文件里把处理器改成了想要的值,可是进程池用 php_admin_value 把会话处理器又钉回了旧值,Web 请求走的仍是那条会加文件写锁的路径。后果是你对着命令行确认明明已经改过来了,现场却纹丝不动。教训是把两处当成两个独立的核对对象:一处是命令行给出的默认值,一处是每个进程池各自钉死的覆盖值,任何一项以进程池为准。而且不同进程池可以各自设置,改了一个不代表改了全部,这一点在有多站点、多池的机器上尤其要逐池确认。
六、无状态化是设计约束,两级放大是后果
治本的方向有两条,一条管根因,一条管并发上限被击穿之后的局面。
根因侧,把无状态当成接口和内部自调用的硬约束。对外提供接口的路径、以及计划任务发起的回环调用,不该开启有状态会话;确有需要才短暂读取会话身份的,也要遵循开启、取数、立即关闭的边界,绝不能在关闭会话之前去做任何外部调用或耗时处理。落到检查项上就三问:每一处会话开启后面,是不是紧跟了对应的关闭;关闭有没有排在慢操作之前;回环请求是不是被剥掉了会话标识。生产环境更彻底的做法是把会话处理器换成基于内存的分布式方案,它不按文件加写锁,从机制上消掉串行。
后果侧要看清雪崩是怎么两级放大的。第一级是等待时间吃满工作进程:每一个卡在锁上的请求,最多会把上游读超时的六十秒耗完,这段时间它占着一个工作进程不放。第二级是进程上限被击穿:当这些只在等锁的请求把可用工作进程堆到上限,后面来的请求,包括那些根本没用会话、本该正常处理的请求,也会被直接拒绝。这就是为什么单用户的问题最后演变成整站不可用。也正因为如此,重启只是止血:重启把工作进程清空、把锁释放,症状退下去,但只要有会话并发再次发生,队列会立刻重新长出来。事后要能归因,必须留下这几样观测数据:故障区间内的工作进程数量与每个进程在做什么、监听端口上的连接占用、跟随的服务日志里 504 的时间戳,以及最关键的一条,那些挂起的进程等的是不是同一个会话标识。有了这条对应关系,才能把超时太小的错误结论彻底钉死成同会话被串行。具体上限该给多大,取决于机器和业务,这里只谈等待时间与进程上限相互叠加的关系,不给数值。