
解析器认不出前缀时,按本地名兜底但要知道丢了什么|洹拓科技
一、故障现场:字段在文档里,取出来却是空对象
对接一类返回信封报文的服务时,这个现场出现频率很高:抓下来的文档里明明有目标节点,肉眼能找到,打印整棵结构树时它也在,但用属性方式直接访问,拿到的是一个空对象;换成另一种写法,值又出来了。
先把机制说清楚,因为它决定了后面所有处置的正确性。这类文档里常常多种前缀与声明并存,一层套一层,每层各自声明自己用的别名。解析器在把文档转成可编程访问的结构时,对带前缀的命名空间处理得比较敏感:同一段文本,因为前缀落在哪一层、声明在哪个节点上不同,转出来的成员名就可能不一样,甚至被折叠到解析器内部另有一套命名规则的位置上。于是属性式访问那条路,赌的是“文档里的别名恰好和解析器生成的成员名对得上”。对端把别名改掉,或者换了一个把声明提升到根节点的版本,这条路当场断掉。
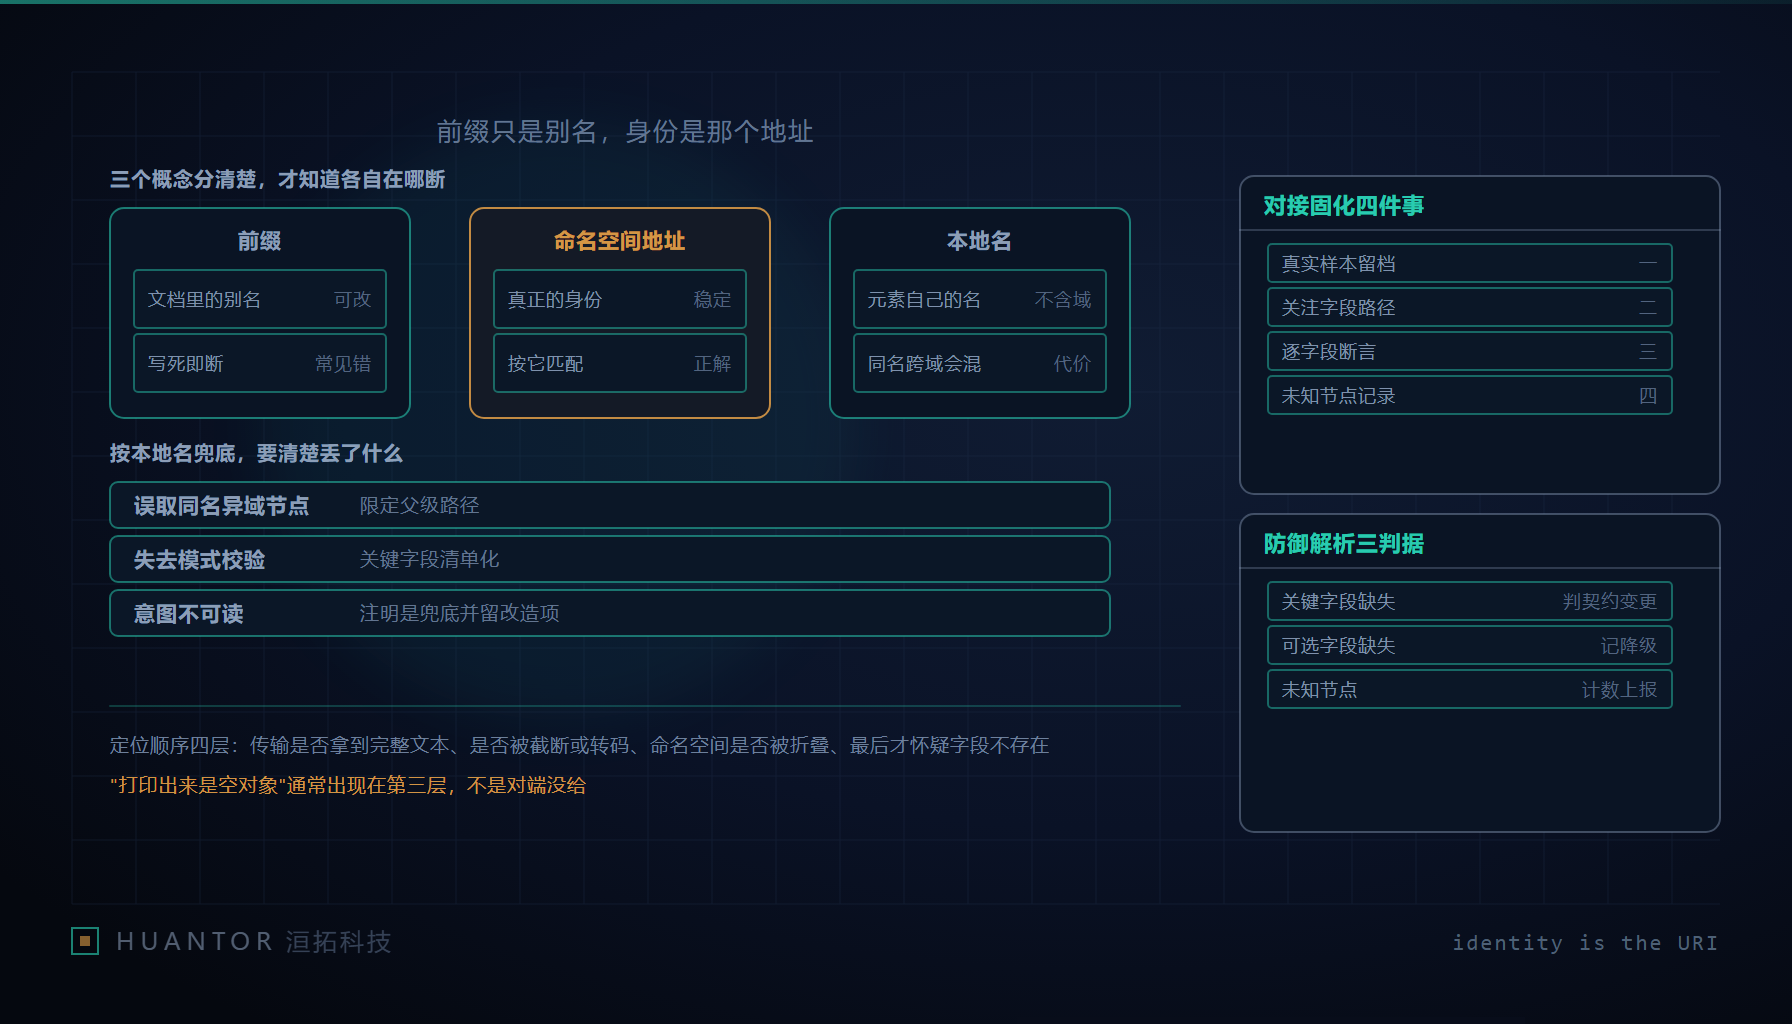
这里最关键的一句话是:前缀只是文档里的一次临时别名,它不是数据的一部分。同一个命名空间在这份文档里叫甲、在那份里叫乙,含义完全相同;反过来,同一个别名在不同父节点下可以指向不同的命名空间。把代码写在前缀上,等于把一个身份认定建立在别人的书写习惯上。
二、三层概念要分开讲,各给一个失效场景
对接这类文档,洹拓内部有一条硬性要求:团队里必须能不加思考地把三层分开说。下面这三个失效场景,就是三个各写错一层的真实故障。
| 层 | 它是什么 | 它的可变性 | 典型误用与失效场景 |
|---|---|---|---|
| 前缀 | 文档内部的一段临时别名,指向某个 URI | 完全可变,对端可以在任何一份文档里改名 | 代码按前缀拼接访问路径。对端一次无关痛痒的改名,取不到值,本地什么测试都发现不了 |
| URI | 命名空间的身份,真正决定两个节点是不是同一个域 | 由契约定义,不应随文档变化 | 把 URI 当成字符串前缀比对,漏掉与尾斜杠、大小写相关的差异,判成两个域 |
| 本地名 | 元素在该域内部自己的名字 | 由契约定义 | 以为本地名全局唯一,于是按本地名取值,跨域同名节点被一起命中 |
失效场景各举一个。前缀层的失效,就是第一小节那个现场:同一份语义的文档,因为前缀改名,属性式访问取到空对象。URI 层的失效通常出在对接多方时:两个版本写得很像的 URI,实际是两个域,模式校验、类型解释全都跟着错。本地名层的失效最常见,也最隐蔽——它通常不报错,而是拿到对的值或者拿到错的值,全看这份文档里恰好有几个同名节点。
三、属性式访问为什么会必然歧义
把属性式访问的问题说透,需要看清它在依赖什么。属性式访问的形态是“沿着结构树的名字一路点下去”,每一个点号后面都是一个字符串,而这个字符串是从文档的名字类信息里派生出来的。也就是说,它把三层信息混在了一条路径上:路径里既有用来定位层级的元素名,又隐含了对前缀与命名空间的假定。一旦文档里有多个命名空间的元素参与构造,而不同域的元素共享同一个本地名,这条路径就在几个含义不同的候选里选了一个。
歧义的来源不是解析器不智能,是问题本身欠定。仅凭“本地名相同”这一条信息,无法确定你要哪一个域里的节点;把信息补齐要靠命名空间的 URI 加上下文路径。属性式访问把 URI 这一维省略掉了,因此它不是偶尔失败,而是在同名跨域出现时必然失败。
四、按本地名兜底救回了什么,丢掉了什么
对接现场需要立刻恢复服务时,通常先救。可用的兜底是一条只匹配本地名的查询:忽略前缀这一层,凡是本地名对得上的节点就取出来。这条路确实能把值取到,而且对不含前缀声明的文档同样有效,所以它在两类文档上都可用。
但要清楚它丢掉了什么,代价一共三条,每条都要有对应的防护,否则它会以另一种形式回来。
- 同名跨域节点被误取。按本地名匹配,本质上是把匹配条件放宽了一维,放宽的那一维正好是身份那一维。防护:把查询限定在具体的父级路径之下,先用结构位置把候选范围收窄,再在收窄后的范围里按本地名取。
- 失去模式校验能力。按本地名取值意味着不再核对节点属于哪个域,那么文档结构是否偏离契约这件事就没人管了。防护:把这份文档关注的字段列成关键字段清单,在解析阶段逐条断言存在且非空。这条防护的实质是把本该由匹配条件承担的检查搬到断言层,代价没有消失,只是换了位置,但换到我们这边来是可读、可测、可回归的。
- 意图不可读。后续接手的人,无法判断这段代码是本来就该忽略命名空间,还是当时的临时兜底。防护:在代码里明确标注这是兜底写法,并留下改造项。
五、正解是按 URI 匹配,长期做法有两种
兜底能救场,但它不该变成常态。长期做法是把 URI 与前缀彻底解耦,两种写法都成立。
第一种是注册前缀再查询:在解析或查询之前,先把契约里的 URI 与一个我们自己规定的别名注册进去,后续查询用我们的别名走。注意这里的方向,注册是“我定一个别名指向 URI”,而不是“我猜文档里用了哪个别名”。这样代码就只依赖 URI,文档里的前缀怎么写都不影响取值。
第二种是在解析环节把 URI 与前缀的映射固定下来,让程序内部一律按 URI 组织信息,前缀只在读取那一步被消化掉。它的代价是要多一层配置或者一小段预处理。
两条路选哪条,只看一件事:解析器提供的能力里哪一条更容易被约束住、更容易在评审时被看懂,就选哪条。两种做法的判定标准是同一个:代码不依赖文档中的前缀写法。如果一段解析代码对端改了前缀就跑不通,那它就没有做对。
六、对接要固化四件事,再加一份契约快照
按“结构是否可达”分层的定位顺序值得贴在墙上。空对象这个现象,通常出现在第三层,但它常常被误判到第四层,于是有人去改字段名,这是最典型的浪费。
- 传输层:先确认拿到的是完整文本,而不是被截断或被中断的响应。这一步只看长度与起止。
- 编码层:再确认文本有没有在中转时被改写、做过编码转换。这一步比对原始字节。
- 命名空间层:然后确认结构确实存在,只是被解析器折叠或以前缀派生的方式改了名。这一步用忽略前缀的查询验证可达性。
- 字段层:最后才怀疑字段真的不存在。
对接侧要固化的四件事,每一件都有归属:保存一份对端真实样本,入库并纳入版本管理,按对端分目录;列出关注字段的路径清单,写清每个字段的路径、类型与所属 URI;逐字段做存在性与类型断言,断言的失败信息里带上字段标识与实际节点位置;对不认识的节点做计数并记录,而不是静默忽略。第四条最容易被省掉,但它是契约漂移的第一批信号来源。
防御性解析的三个判据按字段的关键程度分档:关键字段缺失就判定为契约变更,直接报错终止;可选字段缺失记为降级;未知节点做计数并上报。这套分档比“全都容忍”更安全。
最后给一条治理建议,也是洹拓在对接类交付里会随代码一起交出的一件东西:这类对接要有一份契约快照文件,真实样本、关注字段清单、逐字段断言三项放在同一份文件里,与解析代码放在同一个测试目标下。对端改名的那一刻,回归测试会第一时间红在这里,而不是等对账发现差异。