
连接数远没到上限却报超时:三次握手之后还排着一条队|洹拓科技
一、连接数指标正常,超时却是真的
这类现场的第一组事实是互相矛盾的:应用侧报“连接超时”,服务端的连接数监控却稳稳停在远低于上限的位置,容量告警一条都没触发。于是排查很容易往网络方向走,链路正常;再往服务端进程走,进程活着、工作线程没打满、错误日志干净。矛盾的解法在计数点上。服务端那个“连接数”指标统计的是应用已经取走并建立会话的连接;而三次握手已经完成、连接已经躺在内核队列里等应用取走的那一部分,根本没能进入这个计数。
换句话说,握手完成与连接被取走之间还排着一条队。这条队有长度上限,超出上限之后新到的完成连接会被丢弃,客户端只会重复它没被应答的那一步,等到的结果是一次建连超时。洹拓在做后台服务的容量类交付时,会把这条队列单独列为一个容量对象来谈,而不是混在“最大连接数”里报给客户,原因就在下一节。
二、生效值是三层取最小
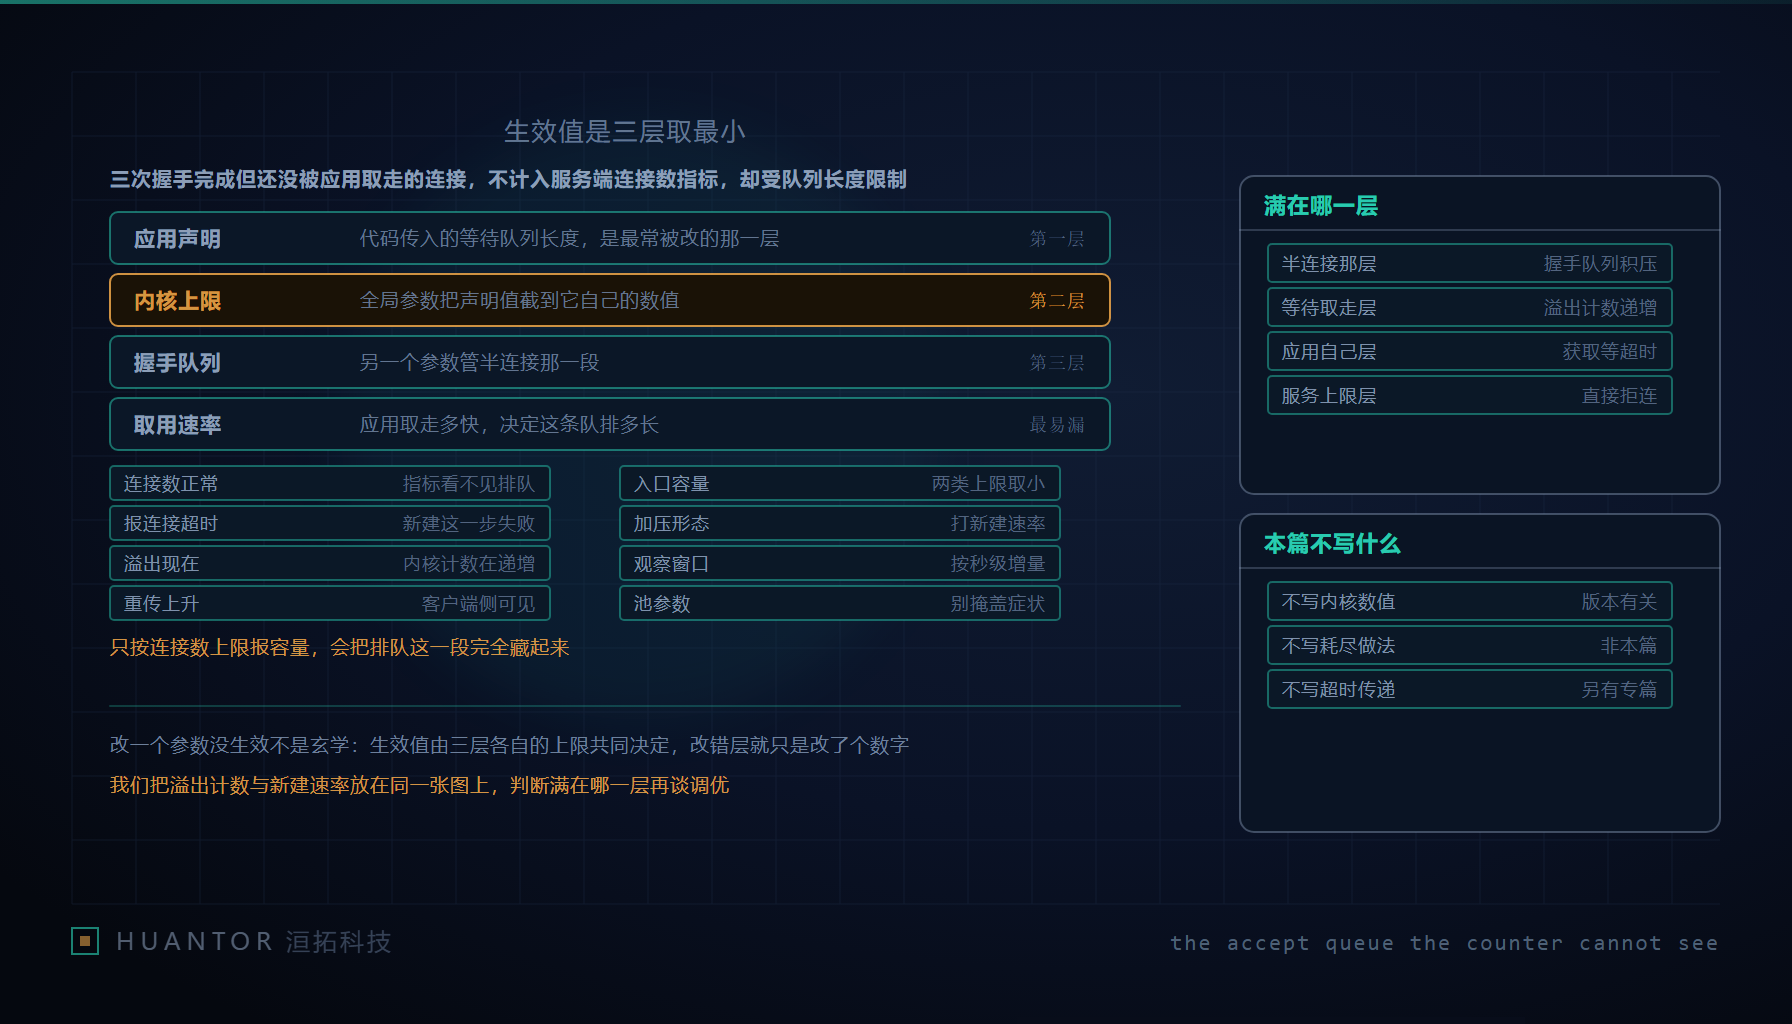
队列长度不是配置里的那一个数。真正生效的上限,由三层里最小的那一个决定:应用声明的 backlog 值、内核层的 somaxconn 上限、以及握手阶段的 tcp_max_syn_backlog。
三层管的段落不同。tcp_max_syn_backlog 管的是握手还没完成的那批连接,即收到第一个同步报文、还没等到最后确认的这一段;backlog 与 somaxconn 管的是握手已经完成、等待应用取走的这一段,其中 backlog 是应用自己声明的意愿,somaxconn 是内核给出的天花板,应用声明值再大也会被截断到天花板。
| 层 | 管的是哪一段 | 值由谁定 | 这一层满了的形态 |
|---|---|---|---|
| tcp_max_syn_backlog | 已收同步报文、握手未完成 | 内核参数 | 客户端反复建连仍完不成,握手阶段重传增多 |
| backlog | 握手已完成、等待应用取走 | 应用声明 | 队列满后新完成的连接被丢弃,服务端无错误日志 |
| somaxconn | 同上,作为内核天花板 | 内核参数 | 把应用声明值截断,导致声明大值只生效到上限 |
取最小这条规则带来的直接后果是:只改一个大参数不会有任何变化。应用声明的 backlog 很小时,内核天花板再宽也不会放宽结果;反过来内核天花板压着时,应用传再大的值也只生效到天花板。“改了一个参数为什么没生效”这件事写成算式就不神秘了,生效值等于三层里的最小值,动任何非最小项都不改变结果。所以我们要求变更单同时记录三层的现场值,并明确标出当时真正起作用的是哪一层,否则参数变更的验收无从判断。
三、为什么服务端指标看不见这条队
计数发生在取走之后,这是隐形的根因。要看见这条队,观察对象要换成三类量:队列的溢出计数、连接相关的重传、以及客户端侧的失败形态。
溢出计数是第一个要看的量,队列满时它按次累加,是对这条队最直接的度量,但它是个累计值,看绝对值意义不大,要看它在观察窗口里的增量。重传是第二个:连接在队列里被丢弃时,客户端只会重复它没被应答的那一步,于是重传率上抬而服务端一片安静。第三个是客户端侧的失败形态,值得单独拆开:连接超时(建连这一步没完成)与读超时(连上了但这笔请求没回)是两类问题,前者指向握手与队列这一段,后者指向应用处理这一段,把它们合成一个“超时”指标是最常见的归因错误。
服务端连接数指标本身没有错,只是它统计的是一段已经过去的对象。把它当成容量依据,等于用店内登记人数推断门口队伍长度。
四、三种溢出形态分别对应哪一层满了
三类症状指向三层不同的满,分诊的价值在于修复动作完全不同。
握手层满,表现为客户端始终完不成建连,服务端连接日志干净,半连接侧的计数与重传一起上抬,修复方向在握手这一段的能力。等待被取走那一层满,表现为建连成功率随并发上抬而下降、队列溢出计数开始增长,而应用日志里没有任何错误;这一层的根因通常在应用侧取连接的速度跟不上进来的速度。第三种最容易被误判成前两种:应用自己的线程或连接池获取超时——连接在内核里已经躺着、也已经被取走了,但业务线程从池里拿不到可用连接,等到获取超时才报错,看起来却和队列溢出一样。
区分靠时间线对齐就能做:把队列溢出增量、服务端已建立会话数、应用侧池等待时长三条曲线画在同一条时间轴上。溢出计数涨而会话数不涨,指向队列层;会话数涨、池等待时长同步涨,指向应用层;两条都不涨而客户端持续超时,回头查握手层。
五、连接池的三个参数会把症状掩盖成什么
连接池参数与内核参数必须一起调,因为池的三个参数各自会把这条队的症状改写成另一种样子。
池上限定得比入口并发小,队列再深也没用:连接堆在队列里等着被取走,溢出计数上涨,客户看到的结论却是“池不够”。获取超时定得过长,一笔请求会安静地排队,错误被推迟到很晚才出现,出现时已经和根因隔了几层调用,归因极难;定得过短,池本来够用却报获取失败,症状与队列溢出长得一模一样,很容易被误当成容量不足去加机器。最小空闲留得太少,突发流量到来时的第一批连接要现场建立,而建连这一步恰好要经过前面那条队,等于在最容易堵的路径上又加了一次必经。
配合调优的顺序是:先定池上限与服务端可维持会话数、入口并发之间的关系,再定获取超时,池等待时间必须短于上游给这一笔请求预留的处理余地,宁可快速失败也不要让请求死等;最小空闲则按突发时段的建连速率留,让流量尖峰落在池里而不是落在队列里。这里不重复超时预算逐层传递那条线,只强调一点:池参数与内核参数不能交给两拨人分别改,改完必须互相对账。
六、容量口径要改,加压要压在建连速率上
评审入口容量时只报“连接数上限”会误导客户。真实的入口容量是两类容量的最小值:一类是服务端能同时维持多少会话;另一类是队列长度乘取用速率得到的那一段,也就是握手完成后应用每秒能取走多少、队列能容纳多长的积压。第二类几乎总被漏掉,因为它不是静态配置值,而是队列深度与取用速率共同决定的动态量。会话数上限很宽而取用速率很低时,客户实际买到的是一个会周期性丢连接的入口,监控上却处处正常。
给这条队做验收,加压要打到新连接建立速率上,而不是并发查询数。保持并发查询数不变、把长连接池撑满,队列里根本不会积压,压测会给出漂亮而无效的结果。正确的做法是持续以较高频率新建短连接,让取走这一段真的排起队来,再看溢出计数是否开始增长。
观察窗口要按秒级溢出增量看,不能用分钟级平均。队列填满与排空可以在很短的时间窗内完成一次来回,分钟平均会把这段峰值抹平成一条看似正常的曲线,这也是这类问题长期在监控里“看不见”的原因。我们要的交付证据是三件:三层各自的现场生效值、加压期间的秒级溢出增量、应用侧池等待时长曲线,三者在同一时间轴上能互相解释,这条队列才算被验证过,参数变更也才算做完。