
一条插入卡了三秒:自增锁的释放时机由一个参数决定|洹拓科技
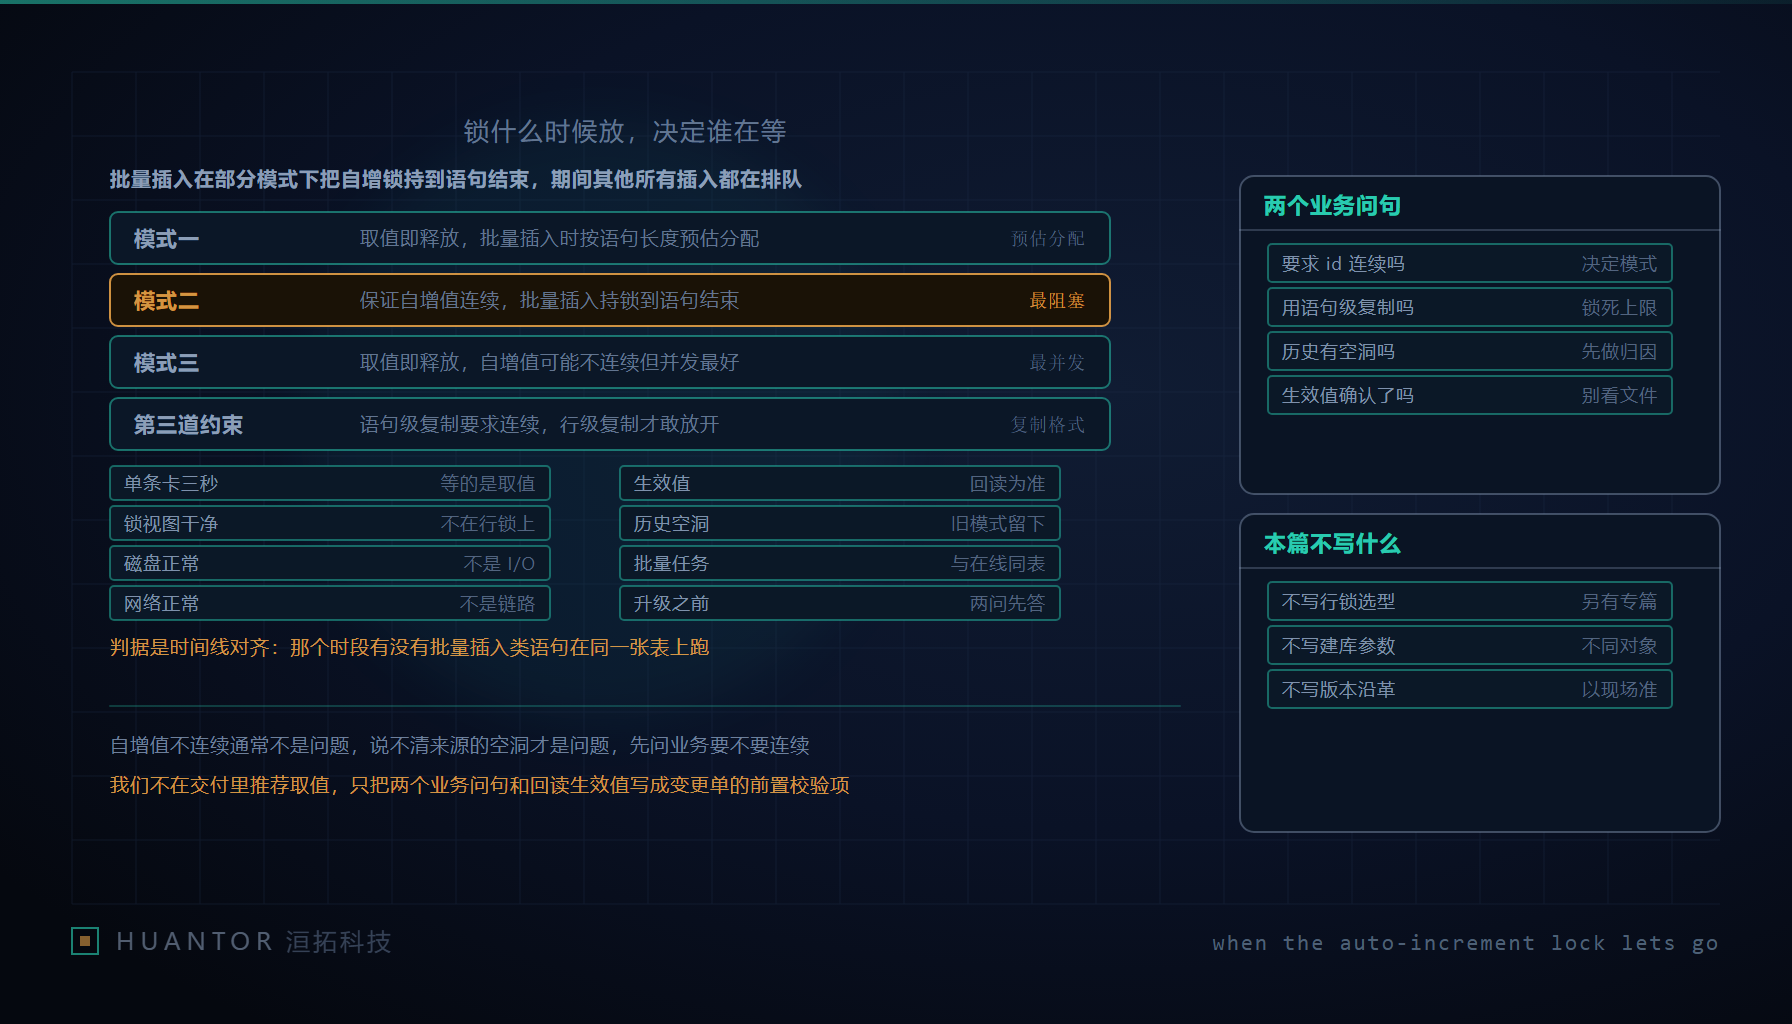
一、锁等待视图正常,一条插入还是卡了三秒
现场给出的信息很矛盾:单条插入卡了三秒,锁等待视图里查不到冲突,磁盘 I/O 正常,网络正常,也没有别的可疑语句。这种组合通常会把人引向“环境抖动”一类无法证伪的解释,然后不了了之。
被漏掉的是一把不按表组织、也不按行组织的锁:自增锁。它保护的对象是这张表上下一个自增值的分配权,而不是任何一行数据。因此在按行锁与表锁组织的锁等待视图里,它往往不表现为一次可以归因的等待。持有它的语句还在跑,其它插入就只能排队;排到的那条既没和谁争同一行,也没在等磁盘,只是在等同一个号码的分配。三秒这个数字来自观察,机制却能把它解释得通:批量插入在部分模式下会把自增锁一直持到语句结束,期间所有插入全部阻塞,一个都不例外。这正是“由一个参数决定”的含义——同一条语句,参数不同,等待的人就多或不多了。
二、三种模式的差别就是释放时机
这个参数只有三种取值,差别可以压成一句话:锁在什么时候放。
| 模式 | 释放时机 | 并发批量插入是否互等 | 自增值连续性 |
|---|---|---|---|
| 传统 | 持到语句结束才放 | 会互等,插入之间基本串行 | 连续,且同一语句内不重复 |
| 折中 | 事先知道行数的简单插入取完即放;行数事先不知道的批量插入仍持到语句结束 | 有批量插入在跑时,其余插入被顶到它结束 | 同一语句内连续 |
| 并发(常见叫法是模式 2) | 每次只取一个值,取值即放 | 不互等 | 不保证连续,可能交错 |
按这三档判断就够了:要不要在语句期间持锁、批量在跑时别人要不要等、号码会不会跳。传统那一档用串行换连续;并发那一档用连续换吞吐;折中那一档只在能预先算出行数时才兑现并发收益,一旦语句形态变成“跑完才知道插了多少行”,它就退化成持到语句结束。很多人以为自己选的是并发方案,实际语句形态让它按传统方式在执行,这是最常见的错配。
三、归因依据是语句类型与时长对齐时间线
既然锁等待视图、I/O 与网络都正常,判断依据就不能再往“谁锁了谁”上找,而要往语句形态与执行时长上找。三件事对齐就能定:卡住时刻前后,同一张表上有没有正在执行的批量类语句;那条语句跑了多久,与卡住的时长是不是同一个量级;卡住的语句本身是不是插入。
批量类语句要按一类来认,不按名字来认:一次装很多行的插入、插入…select 这类行数事先无法确定的形式、批量装载语句,都属于会在部分模式下把自增锁持到语句结束的那一类。它们在锁等待视图里常常只表现为一条正在运行的语句,在慢日志里表现为一次不短的执行。反过来,如果卡住的语句不是插入,或者同表上根本没有批量类语句在跑,这条假设就该被否掉,不要为了自洽去硬凑一个解释。
留证据的方式是在应用侧的数据访问层把语句形态、开始时间、结束时间与影响行数记成一等字段,而不是只留一张耗时直方图。这类现场能复盘的唯一条件,是时间线可对齐。
四、连续性是业务约束,不是技术洁癖
自增值连续不连续本身不是对错问题,要看有没有人依赖它。
依赖的场景大致三类:导出对账,用一段主键区间圈定一批数据,空洞会让区间边界失去含义;按主键回查,外部系统只存了这个号,中间少一个就找不到对应记录;把主键当“第几笔”的序号给人读,一旦不连续就成了口径问题。不依赖的场景同样清楚:主键只用于唯一性约束与索引定位,业务序号另有字段,这种表选并发那一档毫无负担。
区分点也别写错:不连续往往不是问题,不可解释的空洞才是问题。并发模式造成的不连续是可以说明的——号码按批次预取,用完或失败时剩下的号就跳过去了。但回滚掉的事务、唯一键冲突导致失败的批次,同样会在自增序列上留下缺口,而且这些缺口在所有模式下都会出现。两类缺口混在一起时,别人问“这一段号为什么没有”,答不出来就会变成复盘里的口头嫌疑。把空洞按成因分类核一次,比把参数改回传统更能解决问题,因为改回传统并不能消除回滚造成的缺口。
五、复制格式是第三道约束
选模式时容易被忽略的第三道约束是复制格式,它的因果链是这样:语句级复制把原始语句本身传给回放方,回放要得到与主库一致的结果,同一批次分到的自增值就必须连续且可预期,按语句持有锁正好提供了这个前提。这时选并发那一档,主库上并发的两条批量插入可能交错取号,回放按原语句顺序执行就会得到不同的号码分配,主从数据不一致。行级复制传的是变化之后的行数据,主键已经定在记录里,回放不需要重新取号,连续性这道约束随之消失,才敢把锁的持有时间压到最短。
因此这条要写成升级与迁移时的前置检查项,而不是事后发现:先确认二进制日志是语句级、行级还是混合,再确认有没有从库、从库下游还有没有别的消费者在读同一份日志。只改模式不改复制格式,等于把一致性问题换成一点性能收益;把复制格式改成行级,也不意味着可以省掉对历史空洞的检查,这两件事各自独立。
六、检查顺序与给客户的两句问法
洹拓交付这类问题时按固定顺序做三件事。
第一,确认当前生效值而不是配置文件值。配置文件里的写法可能被启动参数覆盖,也可能与实例实际加载的来源不一致,具体默认值取决于版本与部署方式,所以只有现场查到的生效值可信。第二,确认历史数据是不是已经在旧的模式下形成空洞:比较最大自增值与实际行数的差额走势,再抽查断号区间的创建时间分布。如果空洞早就存在,它是历史形成的,不该记在这次变更的账上。第三,确认批量任务与在线写入是不是同一张表:批量同步、补数、归档回写这类任务,只要与在线下单落在同一张自增表上,就具备了互相阻塞的条件;落在不同表就与这条链无关。判断要把任务清单摊开对着表名核,不能靠“应该不是一张表”。
给客户的建议不要写成推荐值,写成两道业务问句。第一问:业务是否要求主键连续——导出对账用不用主键区间、外部系统会不会按主键找记录、有没有人把这个号当序号读。第二问:是否使用语句级复制——只要答案是肯定的,并发那一档就先不要选。两个答案决定选择,而不是“哪个模式更好”。把这两个答案记进交付文档,比只记一个参数值有用:将来加从库、改日志格式、上新同步任务时,这两条就是复评的入口。