
一个全局参数管不住逐层分布:定标要两侧夹逼|洹拓科技
一、分布差异巨大时,一个全局值为什么会破
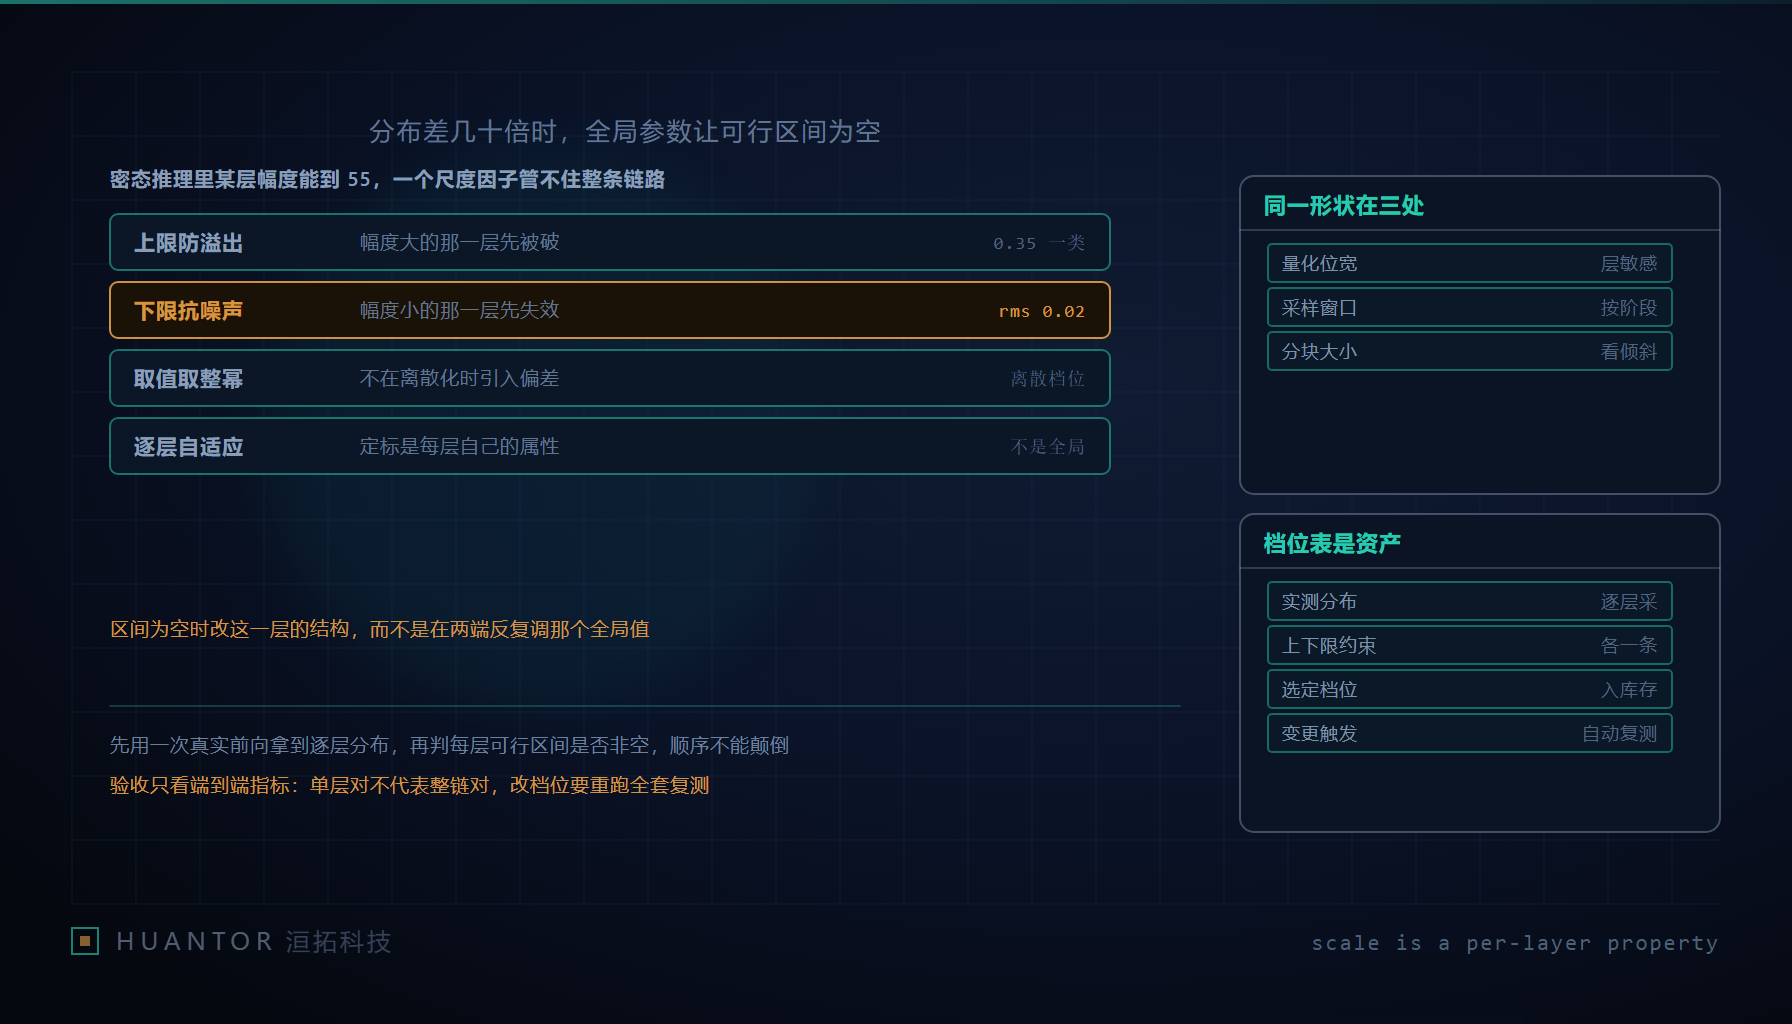
先写清楚这件事的来处。在 CKKS 这类同态加密方案下做大模型密文推理,公开技术系列给出的根因是一条很朴素的事实:各层中间值的分布差异巨大,同系列文章里举例某层的幅度达到 55,这只是公开文章给出的量级,不是本篇的判断依据。差异一旦到这个程度,固定尺度因子就同时在两头挨打:幅度大的那一层把上限撑破,发生溢出;幅度小的那一层被压到噪声里,信噪比不足。失败形态不是只有一头的,这是它容易被误判的地方,因为改任何一个全局值,看起来都只是把故障从一头搬到另一头。
做法因此是逐层选取尺度因子,而取值限定为 2 的幂。这里有个容易读漏的点:限定为 2 的幂不是数学上的讲究,而是一条工程判断。2 的幂在二进制里只挪动指数位,不在离散化时引入额外的尾数偏差,也就是说,档位本身不参与误差的产生。反过来,如果允许连续取值,每一次落档都要做一次舍入,误差与档位互相纠缠,最后没人能分清某层的精度损失是分布造成的还是取整造成的。还有一层理由更贴近交付:离散档位是可以列成表、可以入库、可以在复测时逐条对照的;一个手调出来的连续值只是某位工程师某一次调参的残留,换了人、换了模型版本就找不回来。
所以定标在这类实现里是每一层各自的属性,不是一个全局参数。
二、两侧夹逼:上限管溢出,下限管噪声
诊断动作是可验收的,而且顺序不能反。第一步,用一次真实前向拿到逐层的幅度分布,注意是逐层,不是只看首末两层。首末层的读数骗人得很:入口分布往往被前置的归一化收拾得很整齐,出口又被后续算子重新拉平,中间几层的离群幅度恰好藏在两端看不到的位置。第二步,对每一层分别求可行区间是否非空:上限由该层的溢出边界决定,也就是数值不能越过表示范围;下限由噪声预算决定,也就是信号不能被放大到淹没误差。
公开文章给出的量级是上限不超过 0.35 一类、下限不低于 0.02 一类,同样只是公开文章给出的量级,不是本篇的判断依据。本篇要看的是这个结构:约束必须同时有上限和下限。只有上限的实现会一路放大,直到某天在某个客户的数据分布上撞到噪声墙;只有下限的实现会保守压小,精度在离线测试里看着尚可,端到端指标一路掉。两端都在,中间才有一个区间可言;两端不相交,区间就是空集。空集不是调得不好,是不存在可调和的值,这一点是整个判断的枢纽。
三、可行区间为空时的三种处置与判定顺序
某一层算出下限高于上限时,处置有顺序,顺序体现的是成本而不是偏好。
第一种,改这一层数值范围的来源。这是最该先试的一步,因为它改变的是分布本身而不是拟合分布的那个数。可以动的地方是结构性的位置:归一化放在哪一段、残差分支怎么接、跳连上有没有把两路幅度直接相加。这类改动往往能让那一层的幅度整体降下来,让区间由空变非空,而代价是一次重测。
第二种,把约束拆给相邻层。一层的溢出边界不一定要由这层独自承担,可以让上游少放大一点、下游多吸收一点,把紧约束分给两侧。这一种要谨慎用,因为它会把原本独立的逐层判断重新耦合起来,拆完之后必须回头复算被拆到的那几层,否则只是把空集挪到了别处。
第三种,接受精度损失,并做端到端复测。当前两种都动不了,就只能承认这一层的分布就是不适合当前表示范围,接受它的误差,再用完整任务上的指标确认损失是否可容忍。
要写明一个最常见的错误动作:在两端反复调那个全局值。区间为空时,任何全局值都至少违反一侧,反复调只是在决定哪一头破;而总误差会在两端之间来回摆动,看上去反而像在收敛。遇到“调了几轮,报错换了类别”这种情形,正确结论是判定为空集,而不是再试一轮。
四、同一判据在三处常见场景里也成立
把这件事从密文推理里拔出来,它是一条通用范式:当一个参数要为一串分布差异巨大的多级中间态负责时,可行区间会为空。三处我们天天在写的代码就是它的实例。
推理量化里的位宽与缩放,是层敏感的。激活的离群值并不均匀散布,而是集中在少数几层,用一套全局缩放去套所有层,结果就是那几层把范围撑爆、其余层被压得过粗而丢细节。判据一句话:把逐层量化误差按层排开,如果最大那几层的误差远高于中位数层,全局缩放已经失效。
可观测性里的采样率与分桶窗口,是阶段敏感的。启动、加载、推理、回写这几个阶段的变化速度不同,一个全局窗口必然顾此失彼:调细了,长阶段的时序点淹没存储;调粗了,短阶段的尖峰被平均掉。判据是一句对照:同一条链路上最陡的那一段与最平的那一段,能不能共用一个桶宽而不丢任何一个的拐点。
批处理里的分块与缓冲区大小,是分布敏感的。数据一旦倾斜,全局分块就由最坏的那一段决定,其余全部陪着等。判据也很直白:如果分块耗时分布里,尾部时长与中位数时长相差数倍且差值来自少数批次,分块参数就该按批次类别分档而不是全局设一个。
三处的共同点只有一个:参数的正确单位是逐段、逐层,不是全局。顺带一句更硬的连带事实——逐层约束一旦立起来,它会反过来改写算子的实现方式。公开文章里就有这样一步:密态场景下某些比较类运算不可用,于是改用定标把数值先压进可用区间,再用六次多项式去逼近指数与倒数,那也仍属公开文章给出的做法细节,本篇不展开。约束不是加在实现外面的一个旋钮,它会往里长。
五、验收只能是端到端复测,不能是单层数值
这类约束会连带决定能跑多深、跑多少层,因为每往下一层都要在新的档位上重算误差是否还在预算内,精度与代价最终折成的是可支持的规模。由此推出验收的形态:不能是“某一层的数值对不对”,而必须是完整任务上的指标复测。
单层的数值判据只能证明该层自洽,它证明不了误差会怎样跨层累积,也证明不了上游那一层为了把范围让出来所付的代价是否在下游被放大。所以逐层自适应做完之后必须重跑全套评测,而不是抽几层看看。抽取式验证在这种场景里格外危险,因为故障点通常就藏在没被抽到的那层,而分布采集本身也是分层的,抽样等于按自己的猜测重新选了一遍层。
一张定标表是把这件事接住的最低形态。我们内部的模板长这样,字段可以增,顺序不建议改:
| 层或阶段 | 实测分布 | 上限约束 | 下限约束 | 选定档位 | 复测项 |
|---|---|---|---|---|---|
| 逐层填写,一层一行 | 一次真实前向得到的幅度区间,注明数据来源的输入集 | 由表示范围推出,写清是否含余量 | 由噪声预算推出,写清预算归属 | 从离散档位表里取的那一档 | 该层关联的端到端指标名与基线读数 |
六、把我们自己的“全局超参”习惯改掉
回到交付纪律。做模型服务时,“一套全局超参跑所有层、所有客户、所有数据分布”是一种很舒服的习惯,因为参数少、改动快、解释起来一句话就完。上面这条判据说明它省掉的不是工作量而是风险,而且风险会落在最不起眼的那一层。把它改成分档的最小实现只有四步:一次前向采集逐层或逐场景的分布;按离散档位表取值,档位表外不允许有值;结果与所用档位一起入库,出问题时能查到当时用的是哪一档;档位表变更时自动触发端到端复测,复测不过就禁止合入。
这四步里最容易被省掉的是入库那一步,因为它不影响上线,只影响三个月后的解释能力。要明确一句资产归属:定标脚本与档位表是版本化资产,不是工程师的手调记录。脚本进仓库、档位表进配置版本、每次前向的分布快照留档,三者版本对齐才谈得上可复现;散落在个人笔记与临时脚本里的档位,等于没有档位。给客户交付时同理,洹拓科技这边的验收口径是把分布快照、档位表版本号与端到端复测结果三件一起交,缺任何一件都算未完成,而不是等客户在某个数据分布上撞出溢出再回来查。
还有一条边界要写清楚,免得这件事被讲过头:逐层定标解决的是数值表示与噪声预算的匹配问题,密态计算解决的是数据在谁手里可见的问题,两者都不是对方的替代品,密态这条路不能拿来声称等价于可信执行环境给出的隔离强度。
最后留一句可以复述的原则:参数的正确单位是逐层,不是全局。当分布差异很大时,一个全局值不是简洁而是妥协,而这个妥协通常在最不起眼的那一层暴露。