
两万部剧被判同质化:相似要落到可比对的字段|洹拓科技
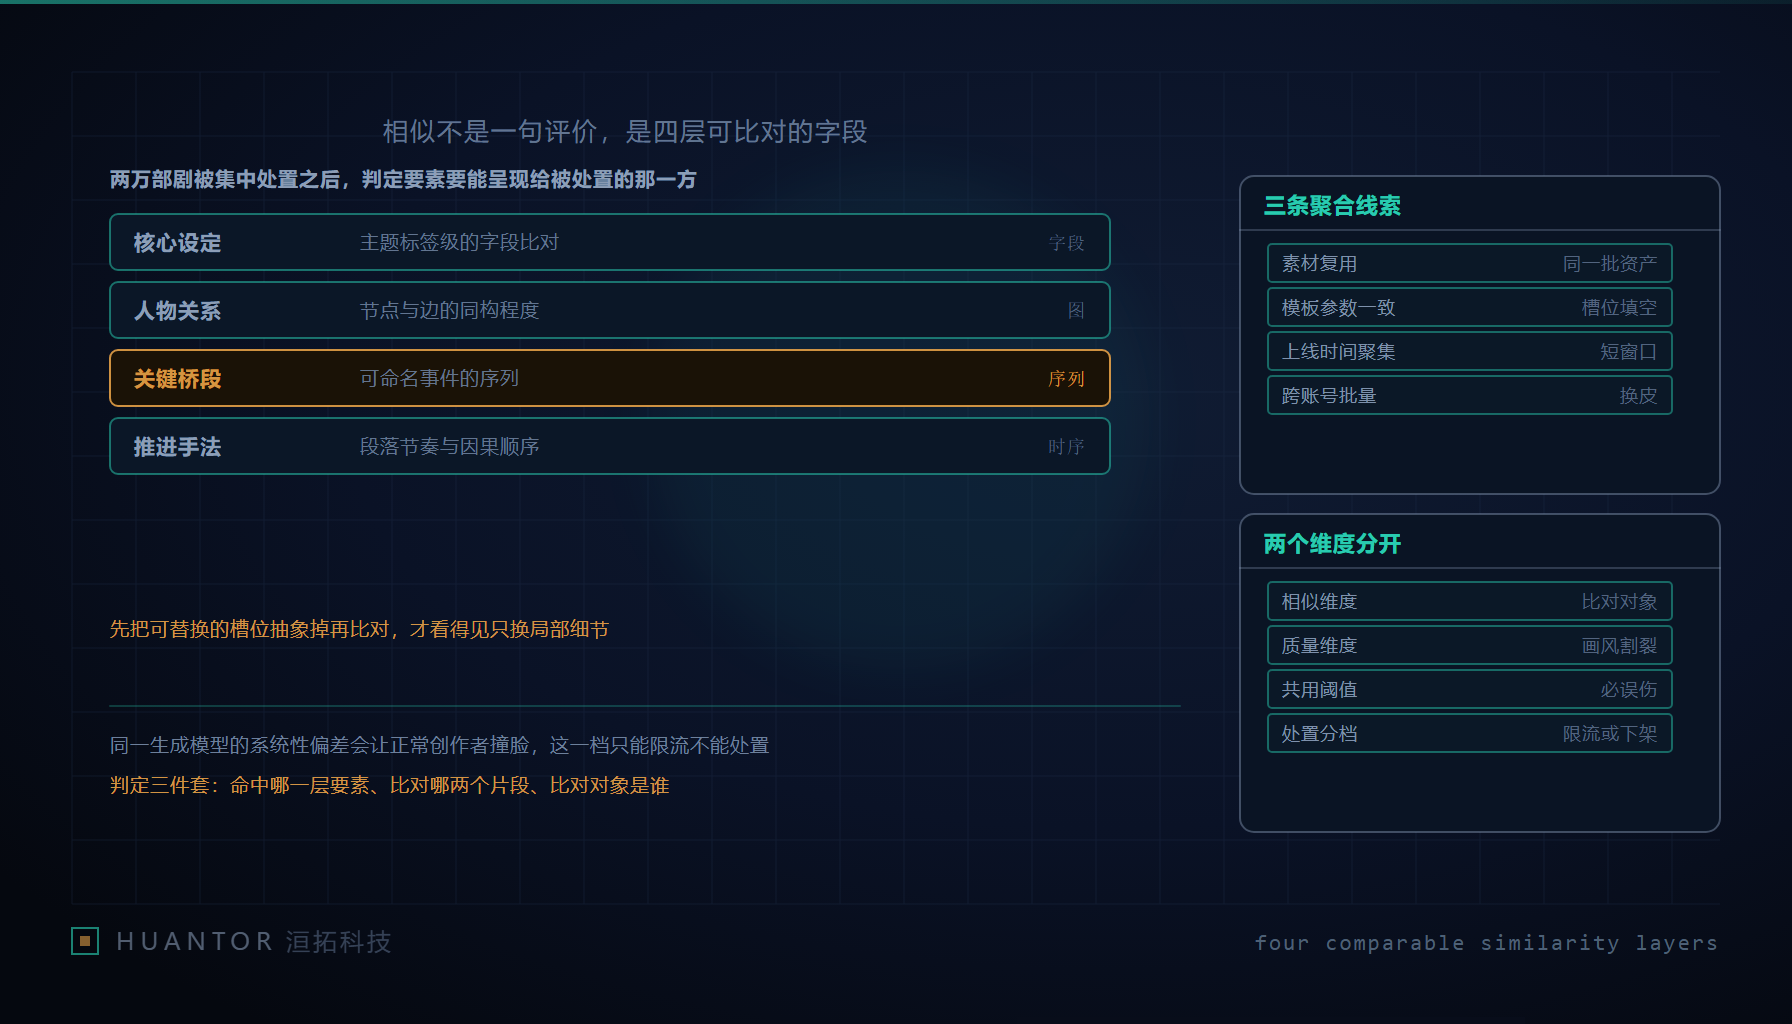
一、公告里的四层相似要素,是四个抽取目标
一家短剧平台(公开报道为红果短剧)发布关于持续加强低质和同质化内容治理的公告,把重点治理方向写成两件事:过度情绪渲染,以及对微短剧剧情结构、核心设定、关键桥段、人物关系与视听表达要素的同质化使用。公告列了三类场景,刻意渲染矛盾、剧情内容同质化、人物素材同质化,并给出集中处置的部数为 20426 部。这个数量来自公开报道与平台公告,只用来交代事件的规模关系,不是本篇的判断依据;本篇要谈的是公告里那四层要素怎么变成可比对的字段。
四层要素的抽取对象根本不是一回事,这一点决定了度量方式不能混用。核心设定接近一段主题标签,可以拆成身份、处境、目标与阻力这样的结构化字段,比对的是字段集合的重合程度。人物关系接近一张图,节点是角色、边是关系类型,比对的是节点与边的同构程度,而不是文案相似度。关键桥段是一串可命名事件,重男轻女的家里来了律师、婚礼现场被揭穿,这类事件有名字、有先后,所以要比事件序列,而不是把整段剧情压成向量算余弦相似。推进手法是段落的节奏与因果顺序,反转出现在第几段、信息释放是倒叙还是顺序、冲突靠什么接续,这些是顺序敏感的,向量相似会把节奏完全不同的两部剧拉近。
这四层不能共用一个相似度分数。分数只有一个读数时,设定像但桥段不同的作品,和桥段逐条照搬的作品,会拿到同一个结论;处置方说不清依据,创作方也看不出该改哪里。分层的另一个作用是判据不同:结构层的相似比文字层的相似更难用改写来消除,因此命中权重应当更高。
| 比对对象 | 抽取方式 | 度量选择 | 会被什么绕过 |
|---|---|---|---|
| 核心设定 | 拆成身份、处境、目标、阻力的标签集合 | 标签集合的重合度 | 换一组标签措辞,设定内核不动 |
| 人物关系 | 抽成角色节点与关系边的图 | 子图同构与节点边类型一致程度 | 增删边缘角色,主干关系照搬 |
| 关键桥段 | 识别可命名事件并保留出现顺序 | 事件序列的顺序比对 | 打乱桥段顺序、调换出场先后 |
| 推进手法 | 统计反转位置与因果链长度 | 顺序敏感的分布差异 | 改时长与段落切分,不改推进逻辑 |
二、差异归一化:先把可替换的槽位抽象掉
公告对第二类的描述里有一句很关键的话,仅靠局部细节替换制造差异。对应的实现就是差异归一化:比对之前先把可替换的槽位抽象掉,只留下结构本身。
- 职业:把具体职业归到同一类社会角色,判断冲突是否由这一角色的处境产生。
- 地名:城市名与场景名一律抽象,只保留场景类型与空间关系。
- 亲属称谓:爷爷、外公、舅舅这类称谓归一,看的是辈分与亲疏结构。
- 道具:合同、存折、戒指这类承担剧情功能的物件抽象为功能位。
- 季节:天气与节庆背景抽象掉,不参与差异计算。
槽位表的松紧是这套方法唯一真正要调的东西。槽位选得太宽,抽象过头,题材本不相同的剧会被并成一家,误伤正常原创;槽位选得太窄,归一化几乎不起作用,局部替换照样能制造出可读的差异,批量换皮就从缝里过去了。实操上的判据不是拍脑袋定一个粒度,而是拿已知被判同质的样本回测:同一模板的换皮样本被拉得越近,说明抽象够;跨题材样本的读数没有上升,说明抽象没有过头。
三、批量换皮要靠三条聚合线索
跨剧集、跨账号批量换皮这件事,判定要点在聚合线索上,不在单部内容里。同质化本身是一个关系属性:一部剧无法与自己相似。单部判定必然不准,因为它只能在内容质量上给结论,而公告第二类场景说的是多部之间的关系。
三条聚合线索要分开取数。
素材复用,看的是同一批生成参数或同一套美术资产。落地时按素材指纹来查:美术资产、片头与转场取感知哈希,生成侧留存参数与来源标记,同一指纹跨剧集出现,就是同一批生产的直接证据。
模板参数一致性,看的是同一固定结构下的槽位填空。把每部剧的结构写成签名,场次数、反转位置、时长切分、冲突触发点各在第几段,签名一致而槽位填法不同的两部剧,比任何文字相似度的结论都硬。
发布节奏聚集,看的是同一批账号在很窄的窗口内成批上线。这里要聚合的是账号注册批次、发布间隔分布与剧集上线的密集程度,单部剧的发布时间不说明问题,一批账号在同样的间隔里推同样的结构才说明问题。
三条线索命中两条以上,处置对象就该从一部剧改为一组剧加一组账号。只按单部内容出结论,删完这一批,下一批换一套槽位填法又能上线。
四、人物素材同质化要先分清两种成因
第三类场景说的是批量套用同一人脸模型与五官模板,导致不同作品、不同角色在脸型、五官、妆造和整体辨识度上高度相似。这里混着两种成因完全不同的情况,处置前必须分层。
第一种是同一生成模型的系统性偏差。同一个模型出片,脸型自然趋同,这是模型输出分布的性质,跟创作者是否想抄没有关系。拿辨识度阈值去判这一类,会把用同一款工具的正常创作者一并扫进去。这一类只能限流或者提示整改,不能作为处置结论,因为它无法归因到某个具体行为。
第二种是刻意套用同一人脸模板,可以归因到参数与素材来源。判据有三条:生成来源标记是否指向同一份产出;跨账号的素材指纹是否相同;模板参数能否被复现,即按留存参数重跑能否得到同一张脸。三条里复现能力最强,能复现就能说明这不是巧合。
阈值也要分档,不能用一个数。第一档是模型同源导致的轻度趋同,只做提示与限流;第二档是指纹相同但角色妆造有别,走整改并留复核;第三档是模板参数可复现且跨账号、跨剧集成批出现,才进入处置。三档的差别不在相似度大小,而在能否把原因归到一个可指认的行为上。
五、相似与质量是两套判定,不能共用阈值
另一家平台(公开报道为抖音集团)的短剧创作者中心发布了针对画风割裂、粗制滥造类低质剧的治理公告;公开报道提到这类动作的背景是内容供给快速增长与生成技术在短剧创作里加速应用。这两份公告经常被读成一件事,实际是两个维度。
画风割裂、粗制滥造说的是质量维度,判据在单部作品内部,画面是否统一、声画是否对齐、剪辑是否完整,都不需要跟别的剧比。同质化说的是相似维度,判据在两部以上作品之间。共用一套阈值的后果很直接:质量模型会把风格差异当成低质,一批本来就在做差异化的尝试被误判;相似模型又看不见制作粗糙,真正该限流的粗制内容反而放过去。
分开建模还要分开处置。质量问题的处置对象是这部作品本身,手段是限流、要求重剪或者下架,判据是一次实测;相似问题的处置对象是一组作品与一组账号,手段是合并处置加生产端约束,判据是比对记录。申诉时能出示的东西也不同,前者出示质量实测,后者出示比对对象与命中层级。
六、判定三件套与我们交付前的自查表
处置要能扛申诉,就必须把判定的三件套一起呈现:命中的是哪一层要素,比对的是哪两个片段,比对对象是谁。三件套缺一件,判定就退回成一句评价,只能靠人把两部剧重看一遍再下结论,被申诉方也拿不出可以反驳的具体位置。落到记录格式上,每条处置记录至少带三个字段,命中层级写明是设定、关系、桥段还是手法;片段定位到具体段落与时长位置,能回放;比对对象写成作品标识加版本号,让被处置方能查到自己哪一部。
这条要求对我们自己的交付同样成立。给客户做批量内容生成,同一套模板跨账号发布是很常见的做法,公告列出的三类场景应当直接变成乙方交付前的自查项,而不是等平台来判。
| 自查项 | 怎么查 | 查出来不合格时先改什么 |
|---|---|---|
| 槽位是否只剩局部替换 | 对同批产出做归一化比对,看结构签名是否一致 | 改结构与推进顺序,不是改名词 |
| 素材指纹是否复用 | 美术与语音资产取指纹,查跨账号复用情况 | 换资产库来源,保留可区分的资产标识 |
| 发布节奏是否聚集 | 汇总各账号的发布间隔分布与上线密集程度 | 拆分发号与节奏,避免同窗口成批上线 |
| 生成参数是否可复现 | 留存参数与来源标记,抽查能否复现 | 补齐来源标记,把参数纳进版本管理 |
洹拓把这张表放在发布流程之前而不是事后抽检,原因很实际:GEO 与 AIGC 交付的价值在于内容能被检索和引用,而被判同质化的批量内容不会留下任何可索引的价值,量做大了也是零。自查表跑完还有一件收尾的事,把每一次判定的输入、参数与结论按批次归档,交付给对方时能同时出示结构差异说明。相似要落到可比对的字段,原创也一样,只有落到字段上,才谈得上证明。