
测试里加轮询,最容易把重试写成并发|洹拓科技
一、轮询是一组参数,不是一句“再等等”
自动化测试代码里,轮询是应对异步结果的常用手法:提交之后被测系统要过一阵才能到达预期状态,于是每隔一会儿读一次,直到状态符合或等不动为止。写随意了,它退化成“多等一会儿”;写对了,它是一组必须写死的参数:谁发起下一轮;最多几轮;间隔可不可变;失败之后留下什么结论和证据。
在按命令链调度的那类前端自动化测试框架里,还藏着一条容易被忽略的约束:所有命令必须显式地链式返回,整个用例的执行模型是一条沿链推进的队列。把业务代码里原生的异步递归习惯直接搬进测试代码,想要的重试就会被写成没想要的并发——用例同时挂起多轮请求打向被测系统。最直接的后果是被测系统被自己的测试拖慢,日志里回头看却像系统超时。先把范围钉死:本篇只谈自动化测试代码内部的轮询实现;生产系统的高可用轮询不在讨论范围内,那是另一套约束。
二、三种写法怎么把重试写成并发
一份把轮询状态原因等失败的代码拆开看,失控通常出在三处,每一处都有普遍性。
第一处,把原始响应对象直接返回。框架的命令队列期待的是可链式消费的对象,链路里某一步返回了裸的原生响应,后面的命令就接不上去,框架会直接报错,提示同步写法与异步写法混到了一起。修法是显式把响应包装成可链式对象再交回链路,而不是把包装步骤省掉。
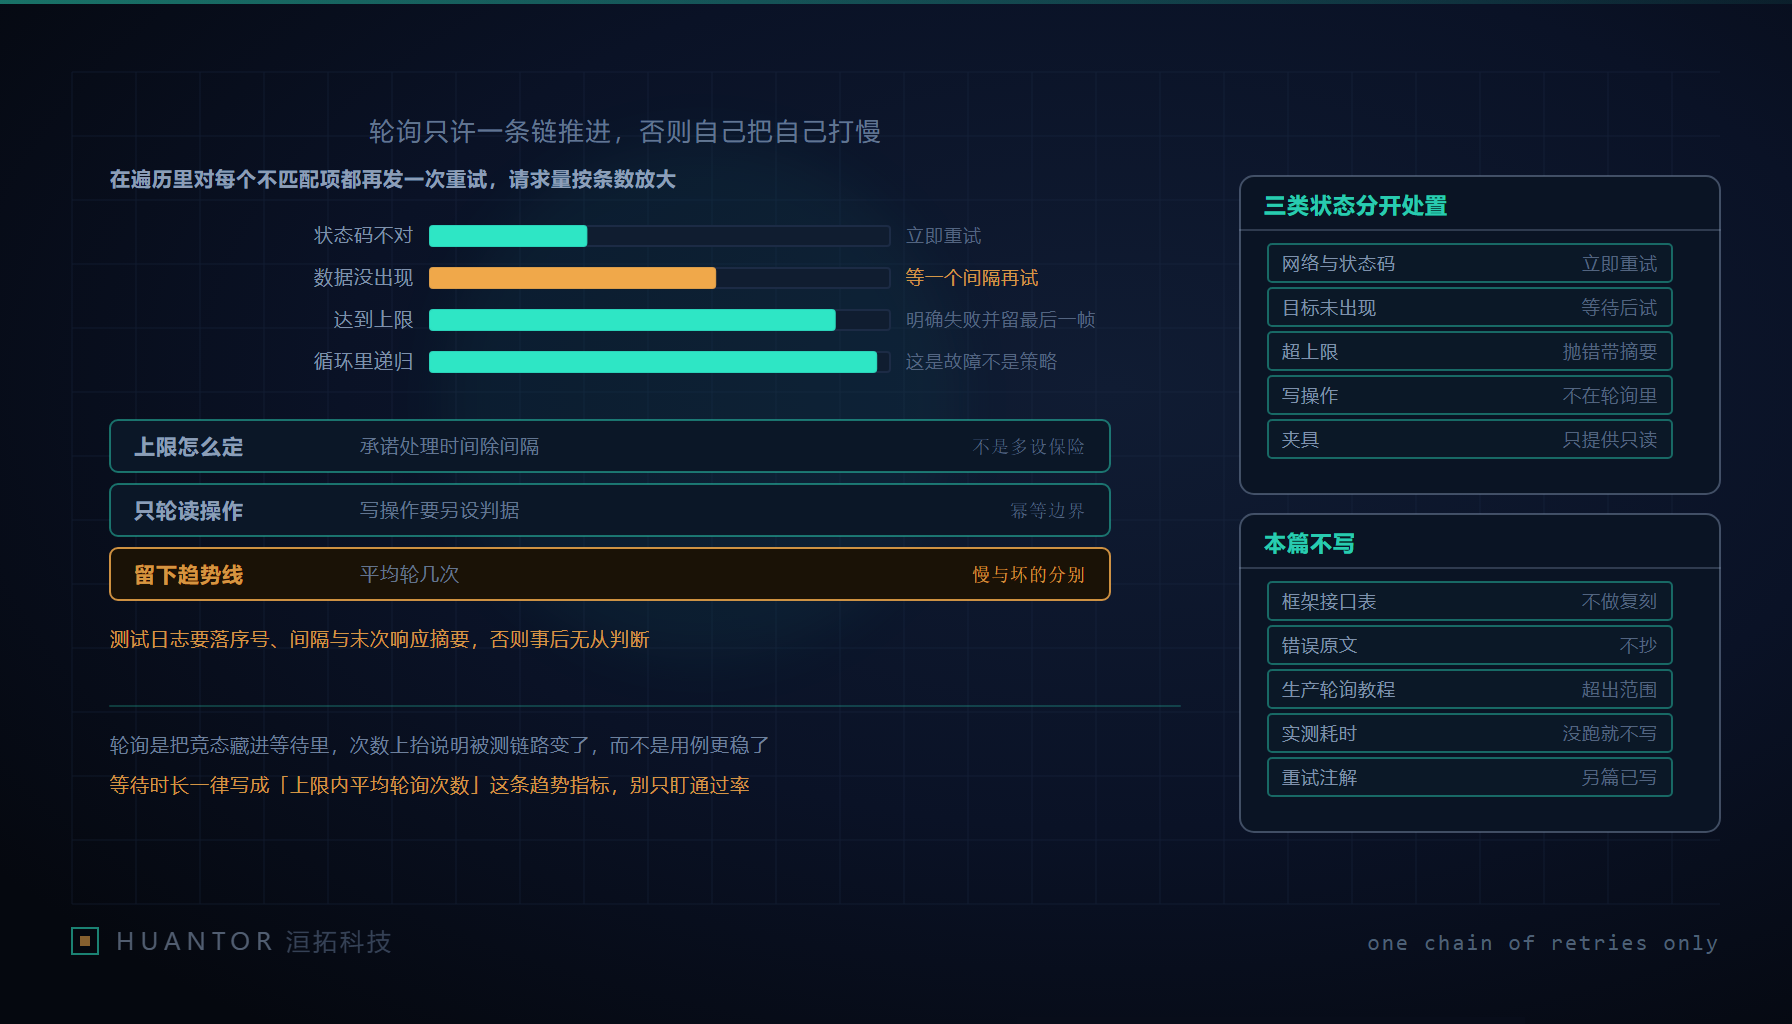
第二处,在循环里反复递归。遍历一个列表找匹配项时,如果对每一个不匹配的项都再调用一次轮询函数,几路递归就同时挂起了:本来是顺序等一件事,变成了并行发好几路请求。请求量按列表条数放大——每个不匹配项都带来一整套轮询,被测系统在瞬间被自己的测试压上强度。这一处的迷惑性在于,日志里只会看到“接口响应变慢了”,看不到放慢的原因正是测试代码自己发起的流量,于是一次普通的用例超时被诊断成了性能问题。
第三处,递归调用没有被包进框架的命令调度。原生异步函数里的自调用脱离了当前执行上下文:它内部的请求与等待不再受命令队列排序,和前后命令之间的时序关系无法解释,等待一会儿生效一会儿不生效,全凭运气。
三处病根同源:测试代码在这类框架里的执行模型是单链排队,原生异步递归的模型是多路竞速,后者不做改造塞进前者,重试语义整个变形。
三、单链推进与状态分档
正确的轮询写法,第一件事是确立单链推进:重试只能有一条执行链,下一次轮询由上一轮的结论决定,并且由框架的调度命令发起,绝不由原生函数自调用。上一轮拿到不匹配的状态码,下一轮立即重试、不做等待;上一轮发现目标数据还没出现,下一轮按固定间隔等待之后再试;同时轮询函数要携带当前尝试次数与最大次数往前走,上限的判定才有落脚点。
第二件事是给状态分档,三类状态的处置与结论写法各不相同。
| 状态类别 | 处置 | 失败时的结论写法 |
|---|---|---|
| 接口返回的状态码不符合预期 | 立即重试,不等待 | 记录最后一次拿到的状态码与所在的尝试序号 |
| 状态码正常但目标数据未出现 | 按固定间隔等待后再试 | 记录等待的轮数与最后一帧响应摘要 |
| 达到最大尝试次数 | 停止轮询,抛出明确错误 | 写明上限内未达预期,附最后一帧完整状态 |
配套还有一条请求设置:把请求配置成不因非成功状态码自动失败,把判定权交给自定义的重试逻辑。否则框架的默认行为会在第一类状态那里直接掐断用例,轮询根本走不到第二轮,排查时看到的失败点和真实原因隔着一层。
结论的写法和处置同样重要。超出最大次数如果只在报告里留一句“超时”,谁也分不出是被测系统真慢了还是用例写坏了。把第几次尝试、什么状态、最后一帧响应体随错误一起交回来,失败分诊就从考古变成了核对。
四、上限从业务承诺反推,幂等划清读写边界
最大次数与间隔的设定,不该是“多设几次更保险”的仪式。我们推的定法是反推:用业务侧对那个异步环节承诺的处理时间,除以等待间隔,得出次数的量级;间隔本身按目标状态可能变化的节奏来定,状态只会慢慢变的环节不必盯得密。这样定出来的上限让用例的失败点和业务的违约点对齐——用例报失败,意味着承诺的时间真的被超出了,而不是测试人员的耐心先耗尽了。反过来,上限含糊的用例失败只能得出“没等到”三个字,对定责毫无贡献。这类推导规则,连同间隔与次数的取值理由,要写进测试代码的评审清单。
另一条必须划清的边界是幂等:轮询的对象只能是读操作。读状态可以反复查,重复发起不产生副作用,这是上面所有处置成立的前提。一旦链路里夹进了写操作,比如提交一次申请、重试一单交易,判定体系整个换掉:重复提交是否被对方幂等消化、部分成功之后的重试以什么为依据,都要另设规则,不能复用面向读的轮询逻辑。测试代码里这类混用比想象中常见——一段“等结果”的代码被顺手写成“不成就再提交一次直到成功”,被测系统里顺带积下一堆脏数据,后续用例的失败因此又长又歪,追根溯源要花比写对多得多的时间。
五、日志与趋势指标:把竞态从等待里拎出来
轮询还有一层容易被低估的副作用:它把竞态藏进了等待。有轮询兜底,用例几乎不再按时序报错,看上去很稳定;可竞态没有消失,只是被“再试一次”盖住了。被测系统一慢、状态一到得早,用例的失败形态反而变得古怪难猜。
配套的治理动作有两件。第一件,每次尝试的序号、实际间隔、最后一次响应摘要都要落到测试日志里。缺了这些数据,事后分不出“当时系统慢”和“用例本身坏”,每一轮复盘都退化成猜谜。第二件,给轮询配一条趋势指标:上限之内的平均轮询次数。这个数是被测链路的生命体征——次数持续上抬,说明链路在变慢或者在变得不稳定,调查应该从曲线抬头开始,而不是从用例红掉开始;次数突然掉下来,也要警惕是不是有人把异步环节抄了近道,让轮询失去了存在的理由。洹拓把这条曲线纳入用例稳定性的例行回顾,因为它比任何一次全绿的运行结果都更有信息量:全绿只描述跑的那一刻,曲线描述这段时间被测链路一直在怎么变。
六、验收一段轮询代码的三张判断题
评审别人测试代码里的轮询实现,不必逐行读完,问三件事就够。
- 链是不是单条:任一轮的结论出来之后,下一轮经什么机制发起?若在遍历里挂着递归调用,它已经是多路并发的形态,退回重写;
- 上限有没有来历:最大次数乘以间隔,对应业务承诺里的哪个时间?答不出来、或者说“默认就是这个数”的,退回补依据;
- 失败留没留话:只看错误信息,能否说出卡在哪一类状态、最后观测到了什么?只写“超时”两个字的,退回补结论。
这三道题不依赖某个框架的接口清单,换到其他按队列调度用例的执行器上照样成立。轮询的本质,是用有纪律的等待换用例的时序稳定;纪律一旦破口,等待本身就成了套件里最大的不稳定源。把单链、分档、反推的上限和只读边界写死,再加日志与趋势两条腿,测试里的轮询才配叫稳定性手段,而不是把自己变成压力测试的开关。