
Shuffle 有三条写路径,走哪条由三个条件同时决定|洹拓科技
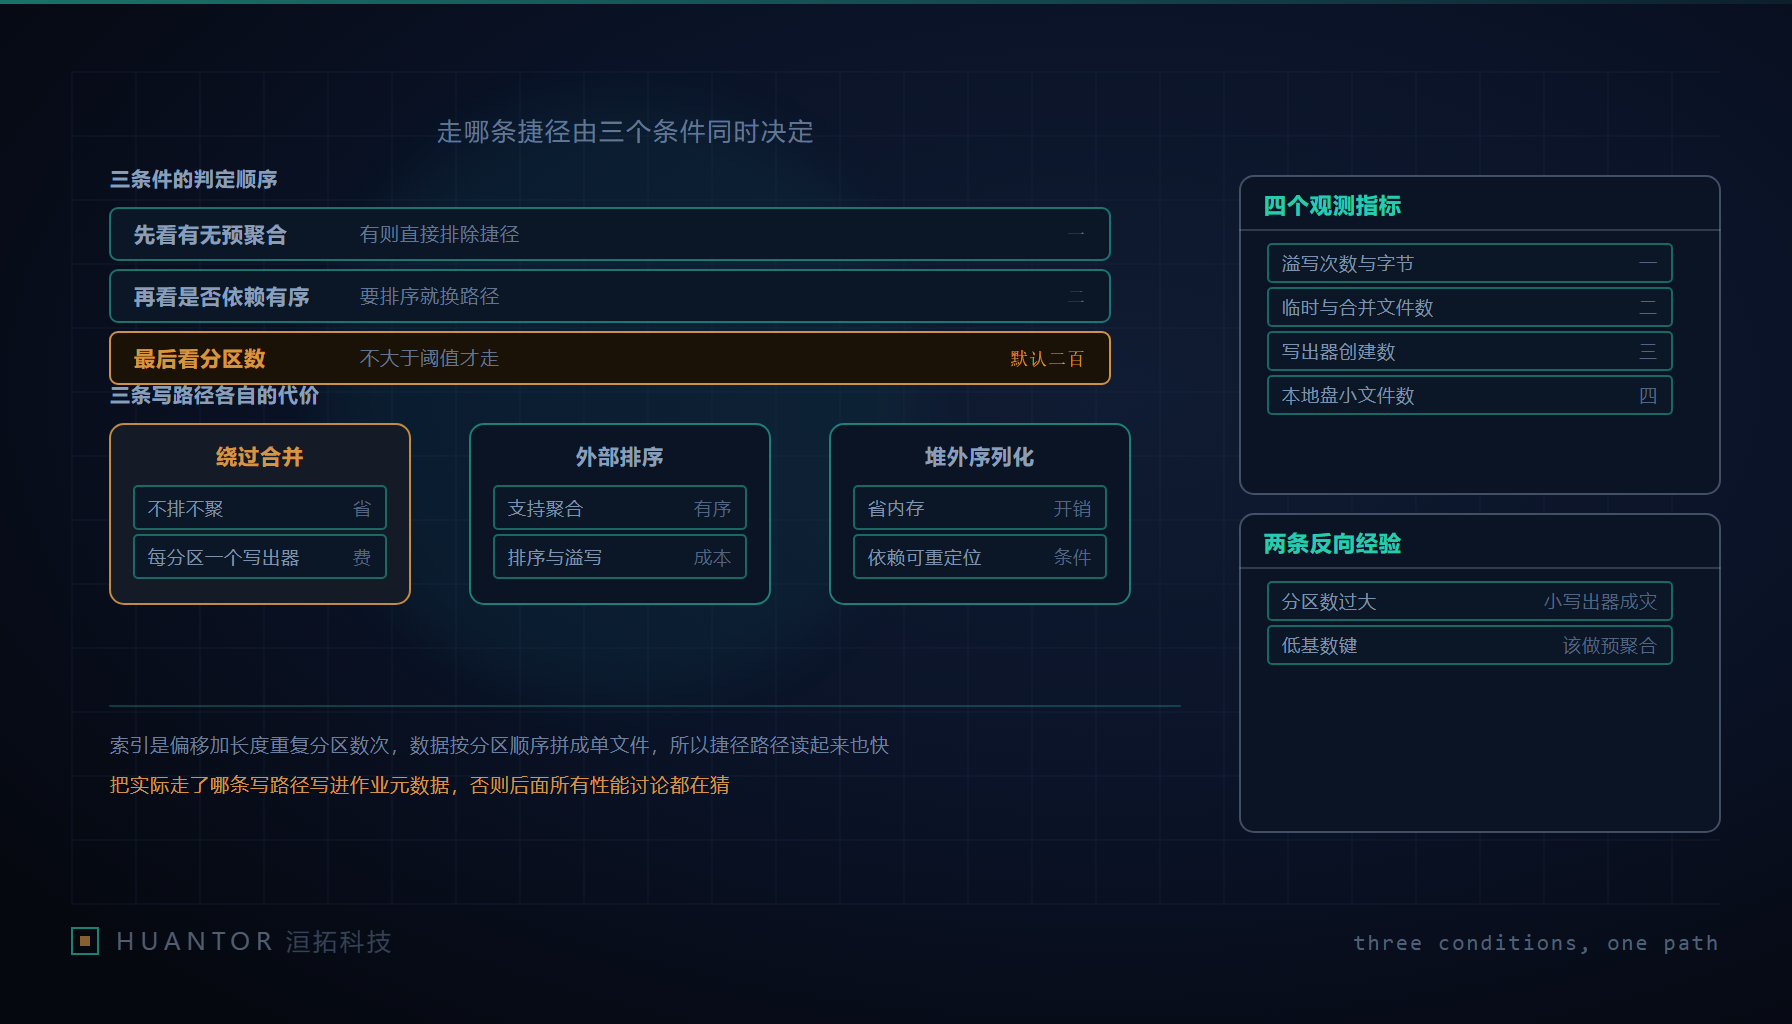
一、三条写路径,各自的适用条件与代价
在这类批处理引擎里,Shuffle 管理器写出 map 侧结果时不是一条路径配三套参数,而是实打实有三条路径,收益与代价完全不同。
第一条是绕过合并的路径。它不排序、不聚合,写完按分区顺序拼接落盘,省掉的是外部排序器的全部开销。它的适用条件极窄,代价藏在写出方式里:必须为每个分区各开一个写出器,分区数一大,内存缓冲和文件句柄同时线性上升。
第二条是普通外部排序器的路径。先在内存里排,装不下就溢写到磁盘再归并。它是功能最全的一条,map 端聚合与按键有序都靠它完成,代价就是排序器本身,以及溢写与归并产生的额外读写量。
第三条是堆外的序列化写入路径。按二进制行布局直接写,省掉堆内缓冲与序列化开销,代价是它对键能否被安全重定位有前提要求,前提不成立时根本不会选它。
| 路径 | 换来什么 | 付出什么 | 一眼能看出的特征 |
|---|---|---|---|
| 绕过合并 | 不建排序器、不溢写、不归并 | 与分区数同量的写出器,句柄与缓冲随分区数放大 | 落盘是一条数据文件加一条索引文件 |
| 外部排序器 | 支持 map 端聚合与按键有序 | 排序器开销与溢写读写量 | 溢写字节数随数据量增长 |
| 堆外序列化写入 | 省堆内内存与序列化成本 | 依赖键可被安全重定位的前提 | 堆内占用低,堆外分配上升 |
三条之间性能差别很大,所以“我的作业到底走了哪条”必须变成一个可判定的问题,而不是靠猜。
二、三问的顺序不能换,前两问问功能,第三问才问资源
能否走绕过合并这条捷径,由三个条件按与的关系共同决定:map 端没有预聚合、没有定义键排序、分区数不大于一个阈值,该阈值默认值是 200。三条里任何一条不成立就换路径。判定顺序建议固定下来。
第一问,这个作业有没有 map 端聚合需求。带按键归约语义的那类算子,例如 reduceByKey 这一族,会直接把捷径排除,因为它要求 map 端先把同键的数据合起来。
第二问,有没有依赖键有序。一旦声明了按键排序的要求,捷径同样不成立。
第三问,分区数是否不大于阈值。
顺序之所以固定,是因为前两问是“这个功能要不要”的问题,第三问才是“资源能不能兜住”的问题。如果先问资源,工程师就会为了凑进阈值而去动语义,那是事故的前奏。三问全过,作业会生成一个绕过式的句柄,写出时按分区数创建同样数量的分区写出器,整个过程既不排序也不聚合。
有时第二问是可以自己创造的。如果你的排序要求只是想让下游某一段能顺序读取,那就不要在 Shuffle 上声明全局键序,把数据落到下游之后再做一次显式排序。什么时候值得:排序范围只覆盖某个分区或者一个小结果集,而全局键序会把整个写路径拖进排序器。什么时候不值得:顺序本身就是业务结论的一部分,比如对外提供的排名与对账顺序,这时放宽需求省下的开销迟早要以另一种形式赔回去。
三、阈值不是性能参数,而是资源保护参数
捷径省掉的和代价付掉的,是同一件事的两面。省掉的是排序器的全部开销;付掉的是写出器数量与分区数相等。分区数 200,就意味着同一时刻要维持两百个打开的写出器和各自的缓冲区。阈值存在的原因,正是这个代价会随分区数线性放大,而不是因为捷径在某个规模上突然变慢。
想把阈值调大,要同时核算三件事:任务槽的内存,因为所有写出器缓冲的总和不能超过单个任务的可用内存;系统的最大打开文件数,因为每个写出器占一个句柄,还要给数据文件、索引文件和日志留余量;本地盘的小文件数量,因为文件是按任务与分区两个维度相乘的。
给一条能写在评审表里的测算方法:用分区数乘以单个写出器的缓冲上限,得到写出器侧的内存下界,再和任务槽内存比;用分区数加上该作业同时打开的其他文件数,和系统最大打开文件数比。这两个比值里只要有一个越线,就先别动阈值,先改分区数。阈值调大只是把保护线往后挪,资源需求不会因为挪线而消失。
四、索引文件的形状,解释了为什么捷径连读都快
提交阶段做两件事:取各分区的长度,按分区顺序拼接成单一数据文件;索引文件按“偏移量 8 字节加长度 8 字节”重复 N 次的形式记录。
这两个结构各有各的含义。索引是定长记录的连续数组,要读第 K 个分区不需要遍历,一次算术就能算出偏移,索引查找只发生一次。数据文件按分区顺序拼接,意味着下游读一个分区就是一段连续区间,读多个分区也是顺序向前,而不是随机跳。这解释了为什么这条路径不只写得快、读起来也快:省掉的排序开销在写侧,而本来会出现在读侧的随机访问被文件形状消解了。
工程推论有两条。其一,任何把中间结果拆成大量小文件的替代方案,都会把随机读的代价重新加回读侧,捷径的收益被吃掉一大半。其二,判断一个作业是不是真走了捷径,看落盘文件数就能猜个大概:一条数据文件加一条索引文件的是它,几百条碎片文件就不是它。
五、四个观测指标,每个异常指向一条被误选的路径
第一个是溢写次数与溢写字节数。捷径路径上它应该是零。一旦非零,说明实际走的是排序器那条,对应第一问或第二问被触发,这时要查的是作业语义而不是内存配置,加内存不会让它回到捷径上。
第二个是临时文件与合并后文件的数量与体积。数量对不上分区数,或者合并后的文件体积远小于平均值,指向写出侧被拆碎,多半是分区数与阈值不匹配。
第三个是单个 map 任务的写出器创建数。这是捷径是否真正命中的直接证据:命中时它等于分区数。如果它远小于分区数而产物文件又多,说明走的是别的路径。
第四个是本地盘的 inode 使用量与小文件计数。捷径路径下每个 map 任务产出一份数据加一份索引,任务数一大,文件数量会先于容量把 inode 耗尽。这一项异常通常意味着并发任务数与分区数同时偏高,两个维度要一起收。
| 指标异常 | 最可能的误选 | 先查什么 |
|---|---|---|
| 溢写非零 | 以为走捷径,实际在排序器上 | 聚合与排序语义声明 |
| 产物文件数与分区数不符 | 路径切换与分区设置冲突 | 分区数与写出器创建数 |
| 写出器数远小于分区数 | 走了合并或排序路径 | 阈值条件与键序声明 |
| inode 与碎文件激增 | 捷径命中但分区数与任务数过大 | 分区数、并发任务数 |
六、两条反向经验,加一条给平台的建议
第一条反向经验:分区数设得过大时,捷径路径反而更差。它不排序不聚合,但每个分区都要一个写出器,分区数上万以后,句柄与缓冲的开销会把省下的排序成本全赔回去,还额外制造大量极小的分区段。分区数要按数据量和并行需求来定,不能指望捷径来兜住乱设的分区。
第二条反向经验:map 端聚合在低基数键上会显著减少下游数据量。这时应该老老实实走排序器那条,让聚合先把体量压下来,下游读取和 Shuffle 输出总量都跟着变小。为了追求捷径而放弃 map 端聚合,在键基数低的情形下是明确的负收益。
最后一条给做平台的人:把“这个作业实际走了哪条写路径”作为作业元数据记录下来,并暴露到界面上。这一项决定了后续所有性能讨论的前提,因为同一个参数在两条路径上的含义完全不同:调大分区数,在捷径上意味着更多句柄,在排序器上意味着更多溢写轮次。缺这一项时,任何调参都是在猜测。落地上很轻,作业结束时写三个字段就够,路径标识、写出器数量、索引记录数,这三个值能覆盖绝大多数争论。洹拓在给数据平台做交付时把这三项列进作业画像,原因不是它们好看,而是没有这三项,就没法回答客户那句“改参数那一次为什么没有效果”。