
依赖已经启动不等于依赖已经就绪:编排里的三种等待条件|洹拓科技
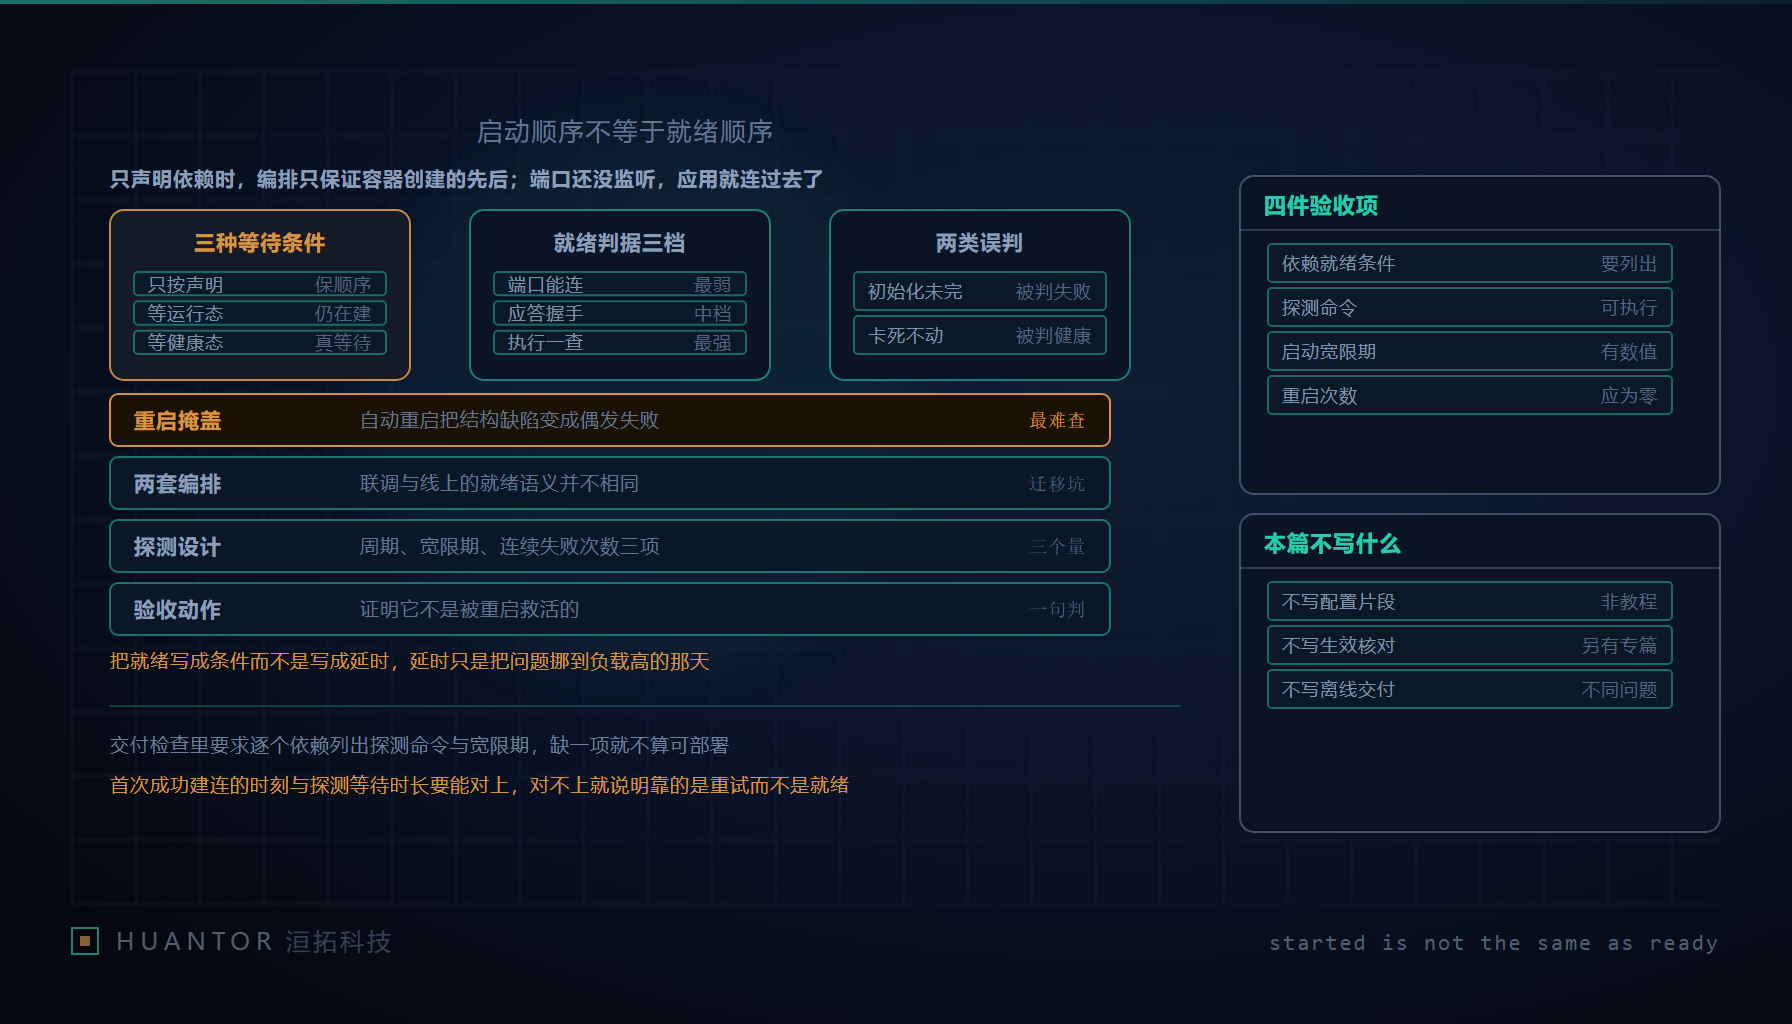
一、连接被拒不是网络问题,是依赖还没就绪
本地一键把整栈拉起来,应用容器报连接被拒绝,第一反应去查网络、查端口映射、查防火墙。这些多数时候都没错,错的是时序:应用去连的那一下,数据库还没准备好接受连接。根子在编排里只声明了依赖关系,也就是“先把数据库容器起起来、再起应用容器”,但声明依赖从来不等于等待就绪。数据库进程被拉起来、容器进入运行状态,和它真正在端口上监听、能应答握手,是三件之间有时间间隔的事。应用连得比它快一步,就被拒。这一篇要把“启动顺序”和“依赖就绪”这两件事彻底分开,因为它们在我们交付里被混用的频率实在太高。分不开的原因也很朴素:健康检查、就绪探针这些机制本身都不难配,真正难的是肯承认“已经启动”和“可以服务”之间确实隔着一段不确定的时间,并愿意为这段时间留出等待。愿意等,才算把依赖这件事处理完;只是排好起来的先后,等于没处理。
二、三种等待条件语义不同,第二种对数据库毫无意义
编排能给出的等待强度大致是三级,做成对照最清楚。
| 等待条件 | 编排实际保证的事 | 对数据库这类依赖够不够 |
|---|---|---|
| 只按声明的依赖顺序起 | 先起依赖、再起应用 | 不够,依赖进程刚被拉起,端口还没开始监听 |
| 等依赖容器进入运行态 | 依赖容器状态变为运行中 | 对数据库几乎无意义,容器在跑不等于能连 |
| 等依赖的健康检查通过 | 依赖探测返回成功,才放行应用 | 够,但前提是探测的判据本身选对了 |
要点在中间那一行。对数据库这类依赖,“等容器进入运行态”几乎没有价值:容器状态变成运行中,只说明那个进程被 fork 出来了,不代表它的监听端口已经就绪、建库或恢复脚本已经跑完。真正把等待做实的是第三级——给依赖配置健康检查,把应用侧的等待条件从“按顺序起”改成语义更高的“按健康状态等待”,让编排去读探测结果,探测成功才放行应用。这中间的差别,就是“先把它起来”和“把它起好”的差别。
三、就绪判据分三层,最弱的一层会给出假绿
健康检查能不能算“真等待”,取决于它探到哪一层。判据由弱到强是三层,一次比一次贵,也一次比一次可信。
- 端口能连上:传输层握手成功就算通过。
- 能应答协议握手:按数据库协议完成一次握手,证明服务在听、并且会说这套协议。
- 能执行一条最小查询:真正下一次最简单的查询并拿到返回,证明它不仅活着,还能干活。
最弱那层之所以危险,是因为它会假绿。数据库进程可能已经在监听端口,但还在做崩溃恢复、还在执行初始化脚本、还没准备好接受业务查询;这时端口探测已经返回成功,编排把应用放行,应用一连就撞上那个还没就绪的内部状态。端口能连只能证明“有人在听”,证明不了“听的人能办事”。我们倾向把判据定在“能应答握手”这一层,能用一条最小查询更稳,但要评估探测本身给数据库带来的额外负担——握手层是成本与可信度之间比较均衡的一档。还要提醒一句,判据定得越靠近“能干活”,探测对数据库的真实压力就越大,一条高频的最小查询本身也会变成一类负载。选定判据之后,探测频率要和它的开销放在一起权衡,而不是不假思索地挑最强那一层,否则健康检查自己就成了新的瓶颈来源。
四、健康检查自己也会误判:周期、宽限期与失败次数
给数据库加健康检查不是设了就完,它自身有两个方向的误判。
一类是“还没初始化完就被判失败”。如果探测周期太密、启动宽限期太短,而数据库冷启动本来就要跑一段恢复或初始化,健康检查会在它真正就绪之前连续判失败,应用要么永远等不到放行,要么被编排反复处理。另一类是“初始化卡死却被判健康”。如果单次探测超时给得过宽、连续失败次数的阈值定得太松,一个卡在半启动、端口能连但查询永远不返回的实例,很可能被算成健康。设计时要把这几个旋钮当作一组来看:探测间隔、启动宽限期(给冷启动留的免判窗口)、单次探测超时、连续失败多少次才改状态。它们共同决定了健康状态到底可不可信。宽限期尤其关键——数据库的启动宽限期必须覆盖它最慢的一次正常初始化,否则健康检查就是在和自己的恢复过程抢跑,把没病的人判成有病。
五、重启策略是掩盖机制:把一次顺序缺陷洗成偶发失败
现场里最坑的一种,是这个问题看起来“自愈”了。应用容器连不上就退出,重启策略把它拉起来,第二次起来时数据库刚好已经就绪,连上了。一轮观察下来,你看到的是“偶发一次连接失败,重启一下就好”,健康检查没配、等待条件没改,这些实打实的缺陷被重启掩盖掉了。这就是为什么“用重启来修复”要明令禁止:自动重启把一个确定存在的依赖顺序缺陷,翻译成了低概率、难复现的现象,观察期内看不到持续报错,因为每次缺陷都被重启救活。要证明“是被重启救活的”而不是问题真的消失,就去比对应用的首次失败与容器重启事件是不是成对出现,再看重启那一次是否恰好落在数据库进入健康之后。只要“失败、重启、成功”这个序列能稳定复现,缺陷就没被修好,只是被藏起来了。需要说清楚的是,重启策略本身是合理的兜底,进程在异常退出之后确实该被拉起来;问题只在于它太容易让人把“被拉起来之后连上了”误读成“这个问题不存在”。把掩盖和容错这两件事分开,靠的还是上一条那种把失败事件与重启事件配对来看的功夫,而不是凭一次复现成功的运气。
六、本地与线上就绪语义不同,验收要留一条时间指标
对洹拓来说,交付面上还有一层不一致要提前堵住。本地一键起的是这一套编排,线上跑的是另一套编排系统,两者对“依赖就绪”的默认语义并不相同:本地没配健康检查也许靠运气能过,线上有它自己的一套就绪探针规则;本地配了等待条件,换到线上也未必按同一判据生效。所以迁移检查里要专门有一条,核对两侧的就绪判据是否等价——探的是不是同一层、宽限期和失败阈值对不对得上,而不是假设“本地过了线上就一定过”。把这类“上线才暴露”的差异压回联调阶段,靠的正是这条对照。
验收动作要落到一个可量的指标上:在应用侧记录首次成功建连的时刻,与编排探测所等待时长之间的关系。等待条件配置对了,首次成功建连应当紧跟在依赖进入健康之后、几乎不需要重试;如果记录显示应用是在若干次连接被拒之后、或是在一次容器重启之后才建连成功,那就是掩盖在起作用,真等待并没有生效。这条指标既是交付验收项,也是防止后续变更把等待条件改回去的一道哨。