
多人同时说话还能听准:目标说话人识别怎么验收|洹拓科技
一、这是两段系统,指标必须分开测
据公开报道,某公司发布并开源了一款定位工业级的目标说话人语音识别模型,针对的是“鸡尾酒会”问题:现有语音识别已能以较高精度转写一个人讲的话,但说话人数增加、语音重叠时性能急剧下降。报道没有给出具体指标与可承载的说话人数上限,我们不做猜测;“工业级”这个词,在我们这里只解释为对噪声、信道与长期运行的要求,而不是对精度等级的宣称。
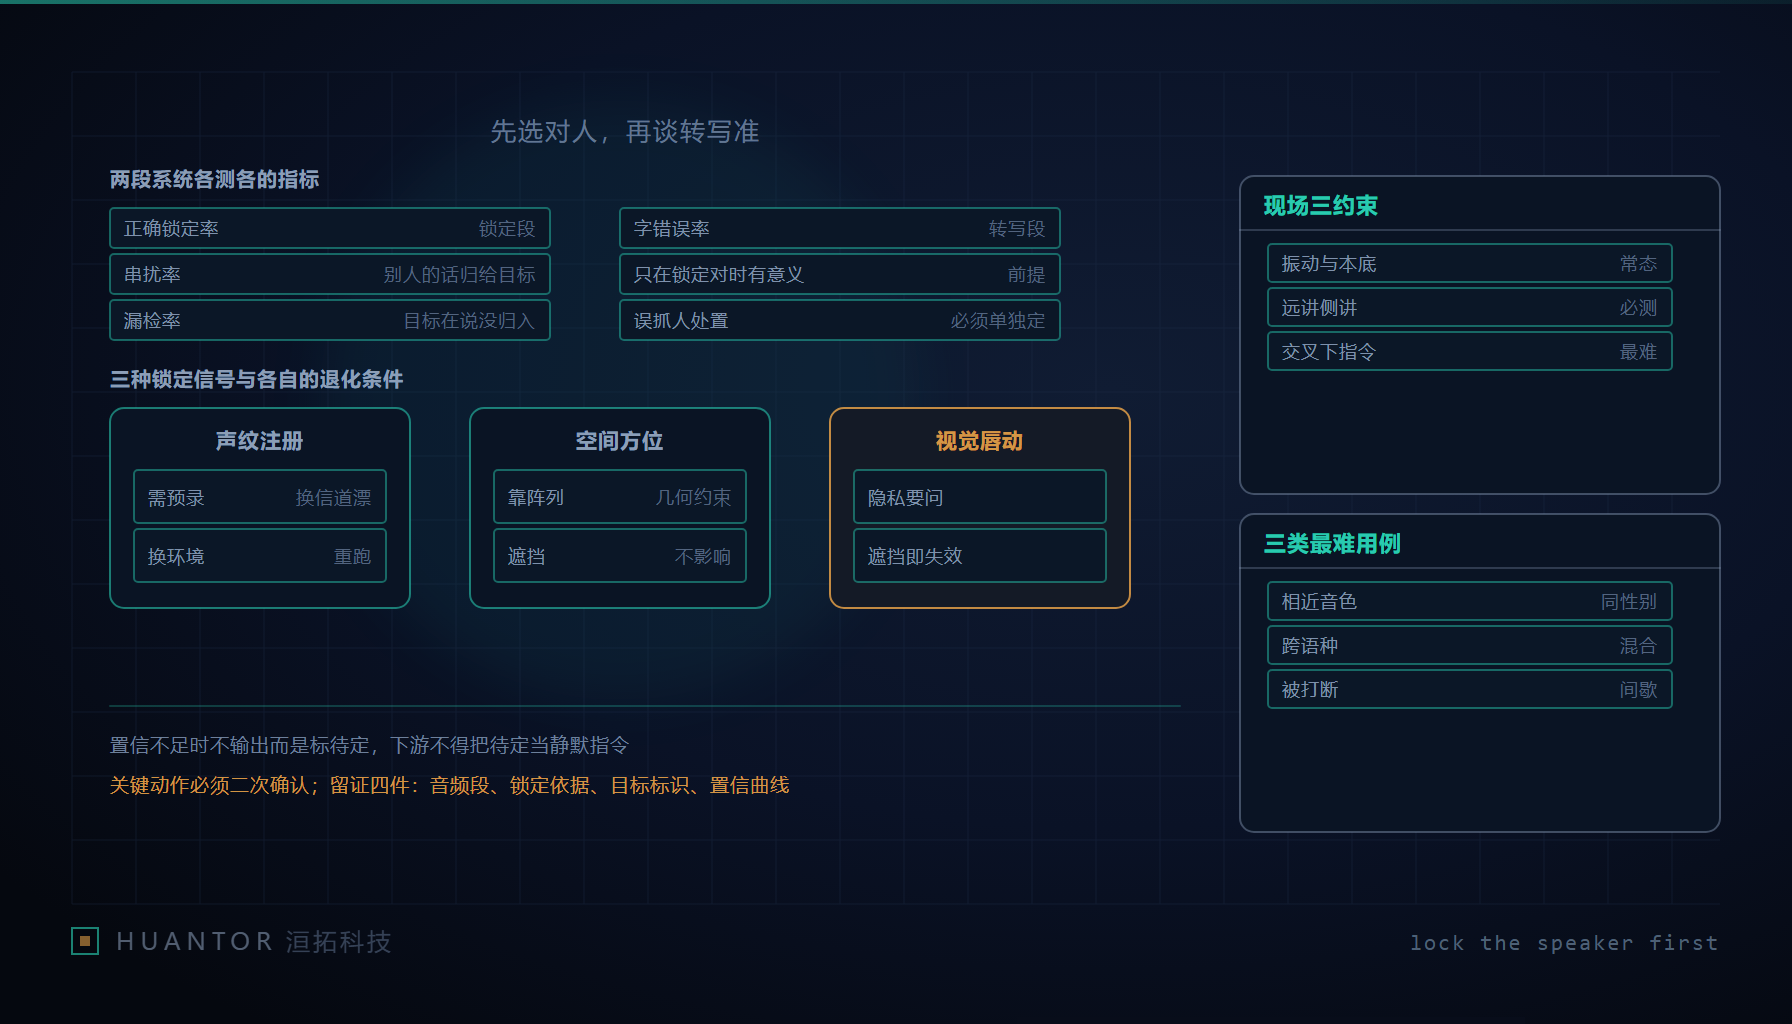
验收前先承认它是两段系统:前段锁定目标,回答“这是谁说的话”;后段转写内容,回答“说了什么”。两段各有各的指标,混在一起测就会互相掩盖。前段测三项:正确锁定率、串扰率——把别人的语音归给目标、漏检率——目标在说话却没有归入。后段的字错误率只在锁定正确的那部分样本上有意义,把全部样本混在一起算错误率,等于替前段免检。前段抓错人时,后段越准越危险:它会毕恭毕敬地把别人的一句话转写得毫无瑕疵。
两套指标意味着两套标注材料:锁定段需要一份“谁在第几秒到第几秒在说话”的归属真值,转写段需要在锁定正确子集上的文本真值。没有前者,后者的分母就是虚的;标注时按时间线逐段标归属,比按整条音频标“这段里有几个人”有用得多。
二、锁定信号的三种来源与各自的退化条件
能用来锁定目标的基础信号只有三类,代价完全不同,退化条件必须分别单独测。
| 锁定信号 | 依赖条件 | 主要退化场景 |
|---|---|---|
| 声纹注册 | 事先为每个目标录制声纹模板 | 换麦克风、换信道、身体状态变化导致模板漂移;新人员进入是运维事件而非配置项 |
| 空间方位 | 麦克风阵列布设与声源定位精度 | 两个声源同方位、目标移动出阵列覆盖、强混响空间定位失准 |
| 视觉唇动 | 摄像头机位、视线与照明 | 遮挡即失效:口罩、侧脸、背身;且直接牵出隐私评估 |
声纹是慢漂,方位是突失,唇动则同时受遮挡和合规两条约束。注册流程本身也在退化链上:操作员戴着手套录、带口音录、间隔较久之后再录,三种情形会产出一批模板漂移用例;多人共用一台终端时,人员的注册与注销由哪个班次负责,既是运维问题也是锁定精度问题,验收时要当用例覆盖,不能当配置项略过。测试顺序应当先单信号后融合:单独测出每一路的失效阈值,再验融合结果有没有优于最优单路;若融合反而更差,问题基本出在仲裁权重与矛盾判定上,而不是某一路本身。做多信号融合时,验收里还要加一条仲裁规则测试:三个信号互相矛盾时系统听谁的、矛盾持续多久后必须转入待定状态,这条规则不该由工程师在深夜调参时临时决定。
三、重叠语音里最难的三类用例
- 同性别相近音色。声纹相似度本身就高,前段分不开;后段又因为音色接近,把串扰内容转写得格外通顺,错误最难被人工抽检发现。用例要把相近音色的两人固定配对,逐轮记录归属正确与否,而不是只测一两个混合样本。
- 跨语种。目标讲一种语言、干扰者讲另一种时,转写段的语言先验会拉扯归属判断,容易把句子整体判给“更像常用语种”的那个人。用例必须双向轮换两种语言的角色各测一遍,只看单向结果会高估系统的抗干扰能力。
- 目标被间歇打断。目标说话被他人插入数秒后继续,系统要在打断结束后把后半段还回给目标,而不是顺水推舟交给打断者。这段会话连续性的处理,是区分“演示可用”和“现场可用”的分水岭,打断时长要按秒级、十秒级两个档分别设用例。
四、工业现场如何改写验收矩阵
现场三条硬约束,每一条都改变验收口径。设备振动与本底噪声:本底是宽频恒定的,它改变的不是“更吵”而是可分辨阈值整体抬升,验收基准必须用产线实测噪声谱来定,安静会议室里的结果不作数。远讲与侧讲:工人不会对着拾音设备说话,距离拉大、偏轴拾音使信噪比低于设计值,唇动信号此时整条失效,用例要按真实工位姿态布设。多人交叉下达指令:几个人几乎同时各说各的话、各要各的响应,这是风险最高的一类,考核的是锁定切换逻辑与待定状态的输出行为,在验收矩阵里应给最大权重而不是当作边角场景。
三条约束改动的是矩阵本身:信噪比一列按实测分档而不是按教科书典型值,姿态一列补上远讲与侧讲,权重一列给多人交叉场景置顶。缺任何一项,测的都是会议室,交付的才是车间,中间那段落差会在投用初期集中爆发成误操作投诉。
五、抓错人怎么办:处置四规则与留证四字段
误判成本不对称:抓错人再把内容转写对,比听不清更糟。处置规则四条,缺一条都不建议接入下游。
- 置信度不足时不输出转写文本,而是输出“待定”状态,宁可让操作员重复一次。
- 输出消息必须携带锁定依据(来自哪个信号)与置信字段,二者缺一按协议错误处理。
- 下游系统不得把“待定”当成“静默的指令”:字段缺失时报错终止,而不是当作空文本继续往下执行。
- 关键动作,例如启停设备、修改工艺参数,必须二次确认,语音通道单独不生效。
真实的坏例子长这样:系统把旁人喊的一句“停一下”归给了目标操作员,转写文本带着很高的置信送进执行接口,而接口协议里根本没有置信字段的位置——不是模型错了没人兜底,是链路没给兜底留字段。留证四字段一并保存:原始音频段、锁定依据、目标标识、随时间变化的置信曲线。事后争议只能靠这条时间线裁决——某一秒锁定从甲切到乙,依据是什么、置信掉了多少。只存转写文本不留这四样,等于把争议留给录音里根本不存在的那一方。
六、隐私三问与最小验收表
上线前回答三个问题:是否对在场人员事先告知并取得同意;录音留存周期与用途限制是什么,质检用途之外的复用要单独授权;能否现场删除并做本地化处理,音频不出厂区是一条可选项,值得为它多付端侧成本。工业场景最常漏的一条是旁观者语音:麦克风为锁定目标而常开,所有旁观谈话随音频段一并被摄入,采集范围要如实写成“音频段内全部声音”,不能写成“目标语音”。
最小验收表按五维组合出必测用例:注册方式(三类锁定信号各一列)、说话人数(一到三人及以上)、信噪比分档、距离与轴向、遮挡程度。用例数不必做全组合,但要保证危险格被钉住:三人以上加低信噪比加远讲侧讲加遮挡,以及目标被两次打断的长会话。每格用例记录第五节四个留证字段,并同时给两段指标——前段给正确锁定率、串扰率、漏检率,后段只在锁定正确子集上给错误率。开源不等于可用于生产:权重公开只是这条两段链路的起点,噪声谱、工位姿态、处置规则和验收矩阵,要每家在自己的现场补全。洹拓在这些项目里我们只签一句话:先交验收表和处置规则,再谈识别效果。