
让人绕远路来缓解整体拥堵:被优化者的代价要写在页面上|洹拓科技
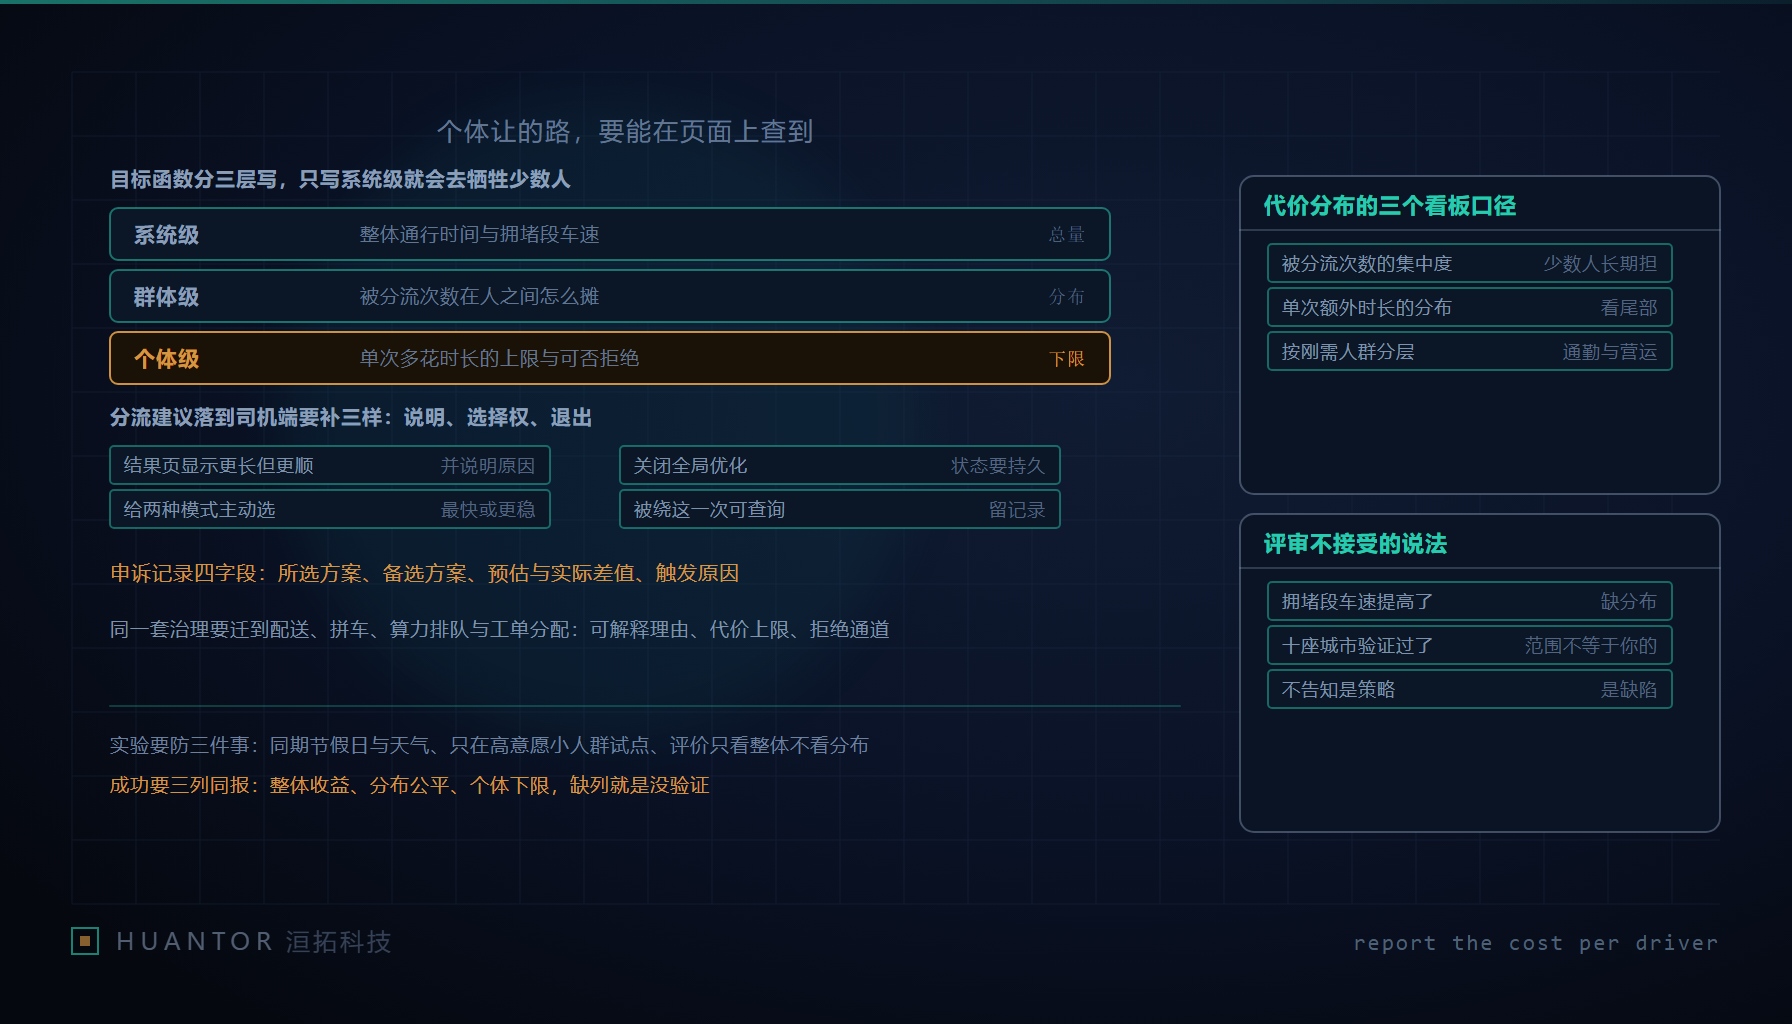
一、目标函数要显式分成三层来写
一项公开研究描述的做法并不复杂:地图服务有意向一部分司机推荐比最短路线更长的路径,把车流从已经堵死的主干道分散到若干条替代道路上,让整体通行更顺。报道说这样做之后,拥堵路段的平均车速有所提高,但没有给出提高的幅度,也没有给出个体被多绕的代价,而这两个缺口恰恰是我们做产品时要自己补上的。这类系统在算法层面不难,难的是我们到底在优化什么。如果优化目标里只写了“整体通行时间最短”这一条,那么任何让少数人承担代价、多数人受益的方案都会被判为最优,系统会稳定地走向牺牲那些老实配合、路径选择本来就多的司机。所以我们主张把目标函数拆成三层,分别写死,缺一不可。
| 层级 | 指标口径 | 只写这一层会发生什么 |
|---|---|---|
| 系统级 | 整体通行时间、拥堵路段车速、路网利用率 | 个体代价被当成噪声,谁承担无人过问 |
| 群体级 | 被分流的次数在用户之间如何分布、分布的集中度 | 少数账号长期被反复抽中,公平问题看不出来 |
| 个体级 | 单次多花时间的上限、能否拒绝、能否申诉 | 单个人反复承担大代价也没有熔断机制 |
三层里最容易被砍掉的是个体级下限,因为它会约束算法的收益。但恰恰是这一层,决定了“被优化”会不会滑向“被牺牲”。我们建议上线前先给个体级设一条硬约束:单次额外时长一旦超过阈值,就不再对同一用户触发分流,而这个阈值本身要能被配置、能被审计,不能藏在模型参数里。
二、“不告知”是产品缺陷,不是策略
系统在没有取得同意的前提下改变了一个人的行驶路径,即使整体变好了,个体也会感到被暗中操纵。这种感受一旦积累,用户会开始怀疑所有推荐,包括那些对他们确实有利的。我们把“不告知”当作一个缺陷来定级,而不是把它当作一种需要技巧的高级策略。知情与选择有三条可以直接落到界面上的路径。
- 在结果页把选择理由显示出来:当系统给出更长路线时,写明“为你选择了更长但更顺畅的路线”,并给出原因和预计的差别,而不是默默替换掉用户原本会选的那条。
- 把模式做成用户主动选的两档:提供“最快”和“更稳”两种取向,只有在“更稳”这一档里系统才被允许参与全局分流,让用户在知情的前提下自己站队。
- 允许关闭全局优化并保留这个选择:关闭以后是一个持久状态,不必每次重新勾选,也不因为关闭而在别处被降权或惩罚。
三条里第三条最容易被“顺手优化掉”,因为负责增长的同事担心关闭率太高影响整体指标。但如果一个用户长期不愿意承担额外时长,这本身就是应当回流进策略的信息,而不是一个要被消除的阻力。洹拓在做调度类交付时,会把“是否告知、是否可退出”这两条直接列为验收项,而不是留给上线后再补。
三、代价的分布要变成看板上的指标
“整体改善”这句话回答不了“谁付出了代价”。要把代价分配看清楚,至少要盯三个口径,并把它们做成日常能看到的看板指标,而不是等到出问题时临时拉一遍数。
- 被分流次数的分布集中度:看承担分流的人到底是大多数人轮流,还是少数几个人长期被选中;分布越集中,公平风险越大,哪怕总量指标很漂亮。
- 单次额外时长的分布:不要只看平均,要看尾部。平均值可以被稀释得很好看,但真正决定一个人体验的,是他碰上的最长的那几次。
- 按画像与刚需分层的公平性检查:把通勤刚需用户、新手用户、付费用户分开看,确认系统没有系统性地偏向去折磨某一群离不开这条路的人。
这三个口径合起来回答的是同一个问题:收益落在谁身上,代价落在谁身上。只报一个总量,等于没做这项检查,也等于把最容易被追责的那部分风险留到了线上。
四、“整体改善”为什么不足以通过评审
这类做法要在多座城市做对照才能说明问题,而评审时最容易在方法上放水。我们把三件事列为要防的坑。
- 混淆因素:同期路况本身变化很大,天气、事故、假期、道路施工都会改变车速,没有把这些排除干净,所谓改善可能来自别处,而不是来自分流。
- 试点人群偏差:如果分流只在愿意配合、替代道路又多的一小撮人身上试,得到的改善不能推广到所有人,换一批人未必成立。
- 只看整体不看分布:评价时只贴一张“平均车速提高”的图,从不展示代价是怎么分布的,这等于把最有风险的那部分证据藏了起来。
所以我们的判据是:整体指标改善只能证明方向,不足以通过评审;评审要看分布,要看个体下限有没有被击穿,要看混淆因素有没有被排除。报道里的城市数量与“车速提高”这一句,我们只当作“据公开报道的方向”,不作为本篇任何判断的依据。
五、这套治理不只适用于导航
任何“为了全局最优、给个体一个次优方案”的产品,都会撞上同样的三件事。配送把某单排给顺路但要绕远的骑手,拼车让某个乘客多等或多绕一段,算力排队把一个任务推迟到非高峰,工单分配把一张急单派给负荷已满的人。它们的共同点是一个人的方便建立在另一个人的等待上,而系统统计的往往只有总量。
跨系统都要备齐同样三件东西:一个可解释的选择理由,一个个体代价上限,一条拒绝或申诉的通道。
其中申诉这一件最容易被写成一句口号。我们的要求是把它工程化,不让客服靠临场话术应对。把“我这次被多绕了”变成一条可查询的记录,字段至少覆盖下面这张表,有了它,客服才有的说,补偿才有依据,前面那张公平性检查也才有原料。
| 留证字段 | 作用 |
|---|---|
| 实际方案与当时的备选方案 | 还原“本来可以不绕”这一事实 |
| 预估差值与实际差值 | 判断代价是否已经击穿个体上限 |
| 触发分流的原因标识 | 区分是全局优化还是偶发绕行 |
| 该用户在窗口期内被分流的累计次数 | 发现代价是否集中在少数人身上 |
六、报告成功要三列同报
最后落到指标治理。我们不建议用一个总量数字宣布成功。任何一次这类改动上线后,无论对内复盘还是对外沟通,都要按三列同时给出:整体收益、分布公平、个体下限,三列缺任何一列就等于没验证。
- 整体收益列:路网总通行时间的变化方向、拥堵路段车速的变化方向。
- 分布公平列:被分流次数的集中度、承担代价的人群构成有没有向某类人倾斜。
- 个体下限列:单次额外时长的尾部水平、被击穿上限的会话数量、申诉量与处理结果。
对做产品的团队,我们的一句话判断是:让一个人绕远路这件事本身不是恶,把它做成一个不告知、不设下限、不看分布的系统才是。技术上“分散车流能缓解拥堵”讲得通,产品上真正要交付的,是知情、下限与可申诉这三件。缺了它们,一个本想缓解拥堵的算法,就会变成一台专门挑老实人下手的机器。这也是我们把这三件写进验收清单、而不是写进愿景口号的原因。