
开源的是权重、代码还是那一环服务:三段流水线要分开验收|洹拓科技
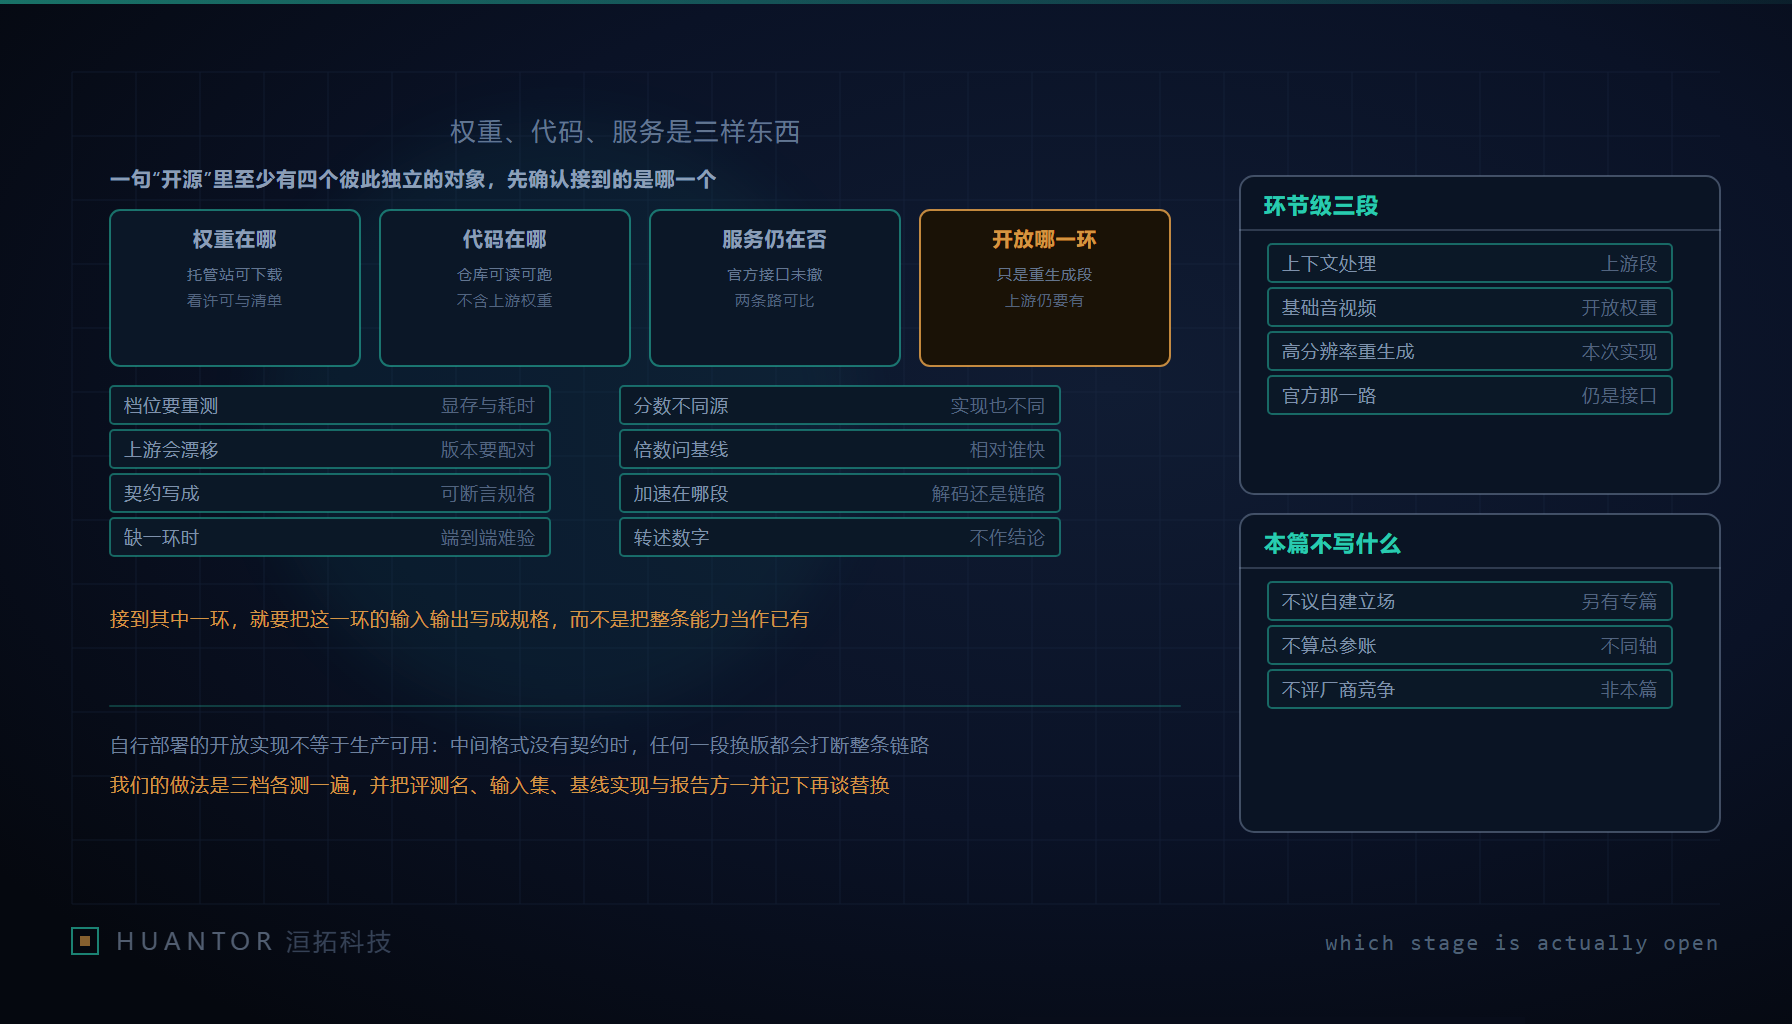
一、“开源了”三个字指向的其实是四个对象
先看这次发布实际给了什么。一家芯片企业与一所高校研究人员组成的联合团队(公开报道为英伟达与麻省理工学院的 Efficient-Large-Model 团队),在模型托管站(公开报道为 Hugging Face)发布了一个视频增强项目(公开报道为 Open-H3-Regenerate-2K)的模型权重,配套推理代码开在一个代码仓库(公开报道为 NVlabs/Sana)。方案基于一家模型企业的视频生成模型(公开报道为 MiniMax H3),作用是把低分辨率的视频草稿重新生成为高分辨率视频,支持一档 2560×1440 的输出,最高可到 3840×2160 的原生高分辨率重生成。媒体把它表述为“开源”“开放”,但没有区分权重、代码与服务,而这三者在验收里是互不替代的对象。
要把这三个字变成可核对的判断,得逐问找证据,一共四问。第一问,权重是否在托管站可直接下载,挂的是什么许可,文件清单是否完整。第二问,推理代码是否在仓库里可读、可跑,依赖是否锁定。第三问,它依赖的上游基础模型是否也在同一许可下开放。第四问,原官方接口是否仍在提供服务。据公开报道,上游完整系统包含多模态上下文处理、基础音视频生成、高分辨率重生成三个环节;其中基础生成环节已开放权重,负责产出 768P 的音视频,而高分辨率重生成这一环此前是通过接口对外提供服务的;这次放出的,正是给这一环的一套可自行部署的开放实现。只满足前两问时,接手的其实是一段需要自备上游能力的环节实现,而不是整条链路,更不能用“已开源”三个字覆盖许可对象各不相同的事实。
二、先写环节契约表,再谈自建哪一环
上游三段系统,每段的输入输出契约先写成表,才有讨论自建问题的基础:
| 环节 | 输入 | 输出 | 开放形态 |
|---|---|---|---|
| 多模态上下文处理 | 文本、图像等条件输入 | 供生成使用的上下文表示 | 未见公开实现 |
| 基础音视频生成 | 上下文与生成条件 | 768P 音视频 | 已开放权重 |
| 高分辨率重生成 | 低分辨率草稿 | 2560×1440 一档,最高 3840×2160 | 此前只有官方接口,这次出现可自行部署的开放实现 |
“未见公开实现”是按公开报道下的判定,后续材料若补齐,这张表要跟着改;关键在表格按环节维护、按对象填写,不能凭整体印象勾一个“已开源”。
有了这张表,“自建整条链路”与“只自建一环”的差别就清楚了:前者意味着三段契约都由你书写并验证,后者只意味着你接手了一环的能力边界,它上游那一段仍然是接口或者另一家拼装的结果。只自建一环有三类风险。一是上游版本漂移:基础模型更新后输入分布改变,重生成环节没动,产出质量却跟着漂,而你这边没有任何变更记录。二是中间格式没有契约:768P 音视频怎么交给下一段,靠的是实现默契而不是规格,换任何一环都可能悄悄破坏。三是缺一段时无法端到端验收:上下文处理段不在手里,出了问题归因不到具体环节,只能说“效果不对”。三类风险对应同一条对策:把每个环节边界写成可断言的契约,别让“实测兼容”当交付依据。
三、三档分辨率要各算各的资源账
768P、2560×1440、3840×2160 三档,不是同一个模型按顺序跑三遍。像素量是成倍跳升,视频的时长维度还叠在上面,“同一模型、更高一档”的代价不是线性外推。交付前要把资源账按档重测,至少覆盖四个量:峰值显存占用、单帧延迟、单位时长视频的处理耗时,以及同一硬件条件下各档能支撑的并发能力。
重测的最小实验设计是:固定输入片段集,覆盖不同运动幅度、镜头切换密度与细节丰富度;固定随机种子,排除采样差异;逐档分别测峰值显存与耗时分布,按分位数而不是均值报,至少保留九十五分位与最大值;测试条件与硬件环境同表记录。据公开报道,这套实现使用潜空间放大手段来提高推理效率,是否开启它同样改变读数,测试矩阵里要把这个开关作为一个维度列进去。这张表没测出来之前,任何“能够支持最高档”的说法都只是对规格参数的复述,不是对自家环境的结论。
四、转述来的分数与倍数要放回不可比的位置
公开材料里的对比数字需要特别处理。据公开报道,该开源实现相对原方案有倍数级的处理速度改善,并在一项图像质量评测(公开报道为 UniPercept)上的平均分高于官方接口版本,前者约六十、后者约五十三;另据公开报道,上游模型自开放以来下载量以千万计、社区衍生模型数以百计。这些数字都属第三方转述,不作为本篇任何判断的依据。我们关心的是它们暴露出的验收纪律:凡引用外部对比,必须同时记下列五件——评测名与版本、所用输入集、基线指向哪个实现、指标的定义与算法、报告方是否就是实现方。
以速度改善为例。倍数先要问相对谁的基线:是相对官方接口,还是相对未加速的自建版本;再问加速发生在哪一段,是解码段、放大段还是整条链路;最后问测试时的分辨率与片段长度。若改善主要发生在解码段而你的链路并不经过它,整链路耗时未必跟着降。评测分数同理:两个平均分出自不同实现,可能对应不同评测版本与不同输入集,把它们相减当作结论没有意义。外部对比数字唯一稳妥的用途,是提示我们要在自己的输入片段集上复测哪些点。
五、适配器台账与两个生态信号
据公开报道,这套开放实现可与细化用的低秩适配器与社区适配器结合使用。组合是能力增益的手段,也带来维护性问题:系统从“模型能不能跑”变成“哪些组合能跑”。适配器台账的最小字段:基础模型版本、重生成实现版本、每个适配器的适用版本区间、适配用途、来源与审查结论,另设一个冲突记录字段,写清哪些组合实测过、哪些从未同时挂载。对照法要预置:删除某个适配器后做画质回归测试时,保持输入片段集与随机种子不变,在组合状态与删除状态各生成一组,逐帧或按关键帧抽样比较并记录差值;评的不是哪张好看,而是差值是否落在客户可感知的类别里,比如闪烁、细节劣化或色彩漂移。
生态信号另说一句。据公开报道的下载量与衍生模型数,加上同团队另发布的面向交互式视频渲染的流式渲染方案与面向解码效率的快速解码器,可以当作维护活跃度的参考。它们能支持两条推断:社区具备改动能力,非官方分支会随时间出现。它们不能支持三条推断:质量、安全与许可合规。在若干实现之间取舍时,这些信号用作排查线索,而不是验收证据。
六、作为承接方要落进生产的四件必做
把这类能力落到客户生产环境,要做的不是表态,而是四件事。第一件,上游许可与权重文件清单存档:下载时的许可文本、文件清单与哈希落盘;本环节与上游基础模型的许可各记各的,两个对象不能混写成一条。第二件,自建环节的输入输出契约写成可断言的规格:分辨率范围、格式、时长容差逐条可执行,随构建自动跑,而不是文档里一段自然语言。第三件,三档资源实测表放进交付文档:峰值显存、延迟分位、并发能力与测试条件一并列明,客户据此判断哪一档真正可承载,这比复述“最高支持 3840×2160”有用。第四件,社区适配器做来源审查与最小可用集裁剪:每个保留的适配器登记来源、用途与适用版本,超出最小可用集的先进独立测试通道。
“可自行部署”与“生产可用”之间隔着契约、实测表、台账与审查这四件做过的事。把它们做成表格与断言而不是一句结论,洹拓在这类项目里的验收才能被客户的复核人独立复算。