
配额按实例均分之后,一千份额度发出去一千七百八:限流失灵在哪一层|洹拓科技
一、超发的归因链:从均分假设到下游被打满
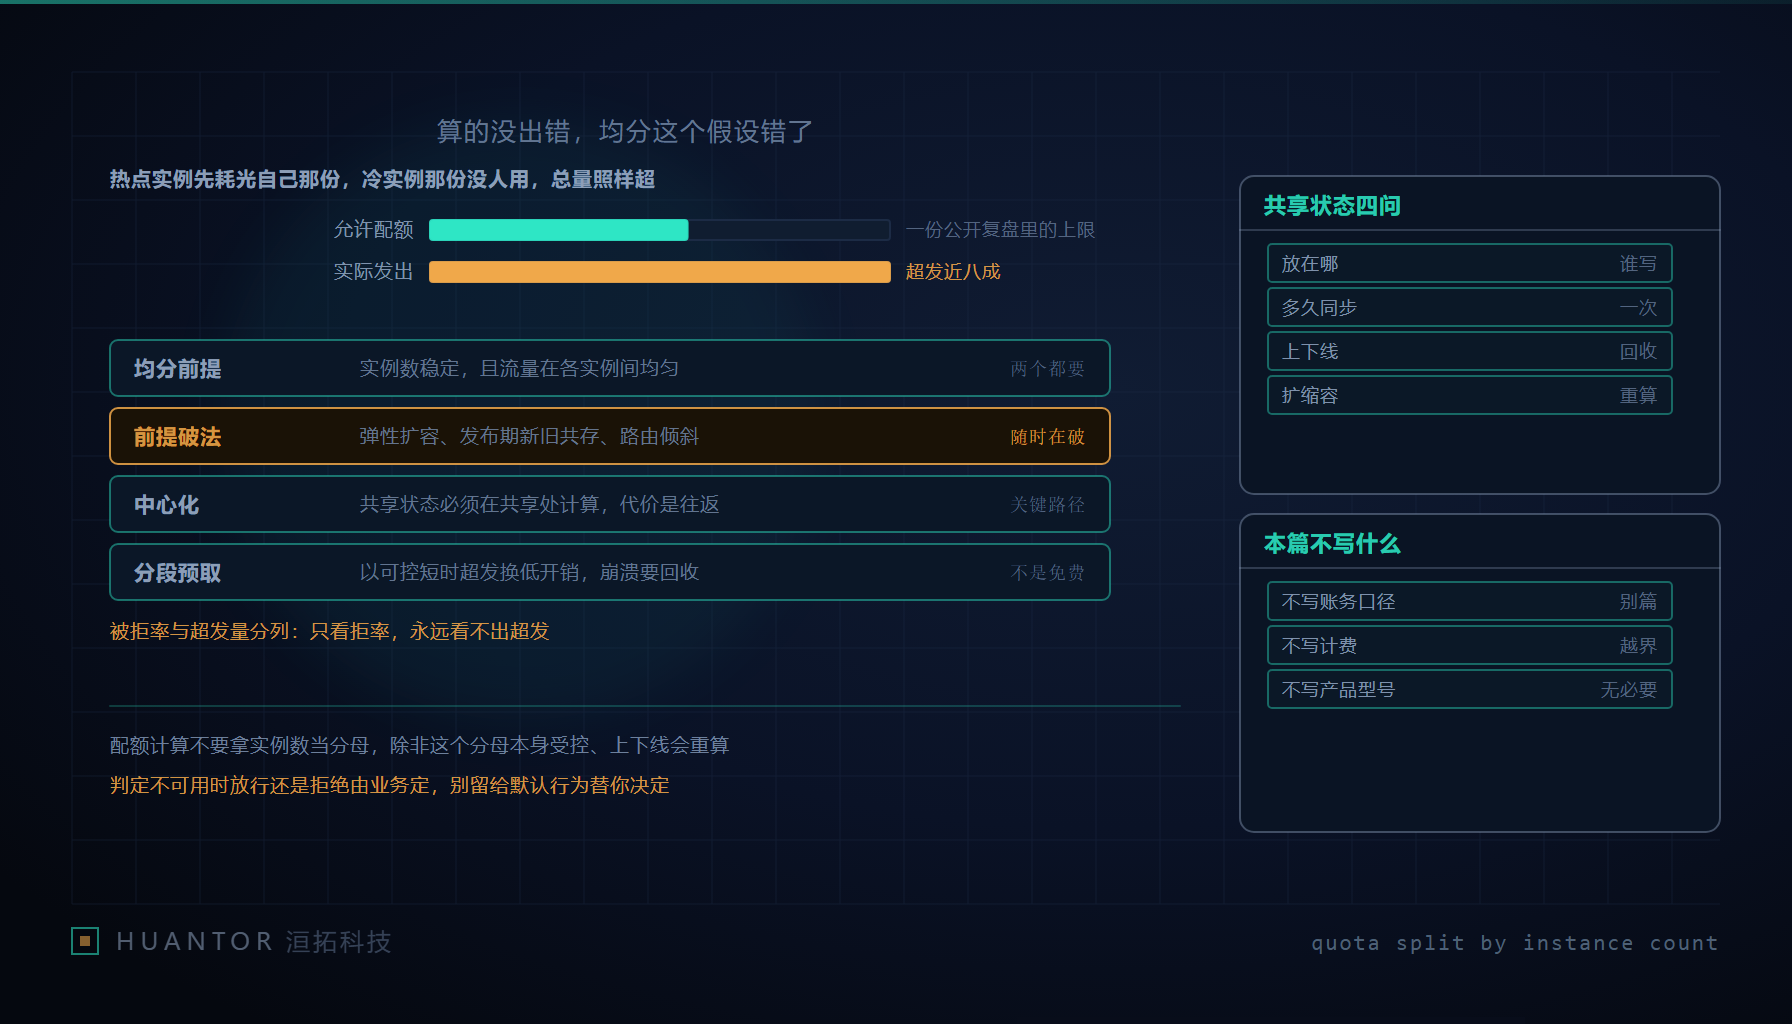
限流失灵很少是算法算错,多半是假设先塌了。最经典的一种塌法,是把一份总量按实例数简单平均,默认每个实例都会把自己那一份消耗干净。这个默认要成立,得同时满足两件事:实例数量稳定,而且流量在实例之间均匀铺开。只要这两条里有一条断了,均分就从省事变成埋雷。
据一份公开复盘里的数字,总量 1000 的配额实际发出 1780、超发约 78%。这组数字我们只用来标定事故形状,不作为本篇任何推论的基础。真正值得抄进复盘模板的,是把归因链拆成能逐条对账的四步。
第一步是承认均分假设的前提。第二步写出前提被破坏的方式:弹性扩缩让实例数骤然翻倍,滚动发布期新旧版本共存、两边的分配逻辑还不一样,路由策略或大租户把请求集中打到少数实例上形成流量倾斜。第三步看每份配额被不同实例实际消耗的差异:热点实例先把自己那份耗光、然后被本地限流卡住,冷实例那份从头到尾没人动。第四步才是下游被打满——因为全集群放出去的总量,从来就不是配置里写的那个数,而是各实例那份的总和,而总和在倾斜下被热点之外的空闲份额顶了上去。
这条链每一步都要能指到一条观测数据上:实例数变化曲线、按实例拆开的请求分布、每个实例的令牌消耗、下游的错误率。指不到数据的归因,等于没归因。
二、实例数不是可控分母:扩容与发布期为什么短时超发
只要配额计算里把实例数当分母,就要问一句:这个分母受控吗。扩容瞬间,负载均衡刚把新实例挂上来,旧实例还在按“总份额除以旧数量”领自己的那份,新实例又按新的均分各领一份,两边都还没收敛,放出去的总量必然超过配置上限。这一段超发不是稳态,是一次瞬时的尖峰,靠事后看平均值反而看不出来。
发布期是另一个时点。旧版本按均分逻辑跑,新版本可能已经改了分配方式,两种逻辑在同一批流量上并存几分钟到几十分钟,各自算各自的份额,合起来既可能偏大也可能偏小。所以一条写进设计评审的硬规矩是:配额计算不能引用实例数作分母,除非分母本身被显式管控,比如把“允许参与分配的实例数”当成一个由配置中心下发的、有上下界的值,而不是从服务发现里实时现捞的活数。
三、两种解法各自兜住哪一段
针对均分假设失效,常见有两条路,各自的前提和代价不同,选错了等于把一个坑换成另一个坑。
第一条是中心化原子限流:把“还剩多少配额”这份状态放到共享处计算,每次判定都去共享存储做原子扣减。它的核心原则就一句——共享状态必须在共享的地方算,不能靠各实例自己估。代价随它而来,要一并写进判据:一是共享存储成了关键路径,它的可用性和限流判定的一致性被绑在一起,它抖一下全集群的判定跟着抖;二是每次判定一趟往返开销;三是它故障时的失败取向,是拒绝还是放行,得由业务定,不能默认。三条判据落下来就是:单请求能接受多少往返预算、共享存储能扛多大读写、失效时按保守还是宽松。
第二条是分段预取:实例一次性从共享处批量领走一段令牌,之后在本地消耗,把“每次判定一趟往返”摊薄成“每领一次一趟往返”。这是一笔取舍,不是免费午餐。一次领多少,直接决定超发上界和粒度的抖动——领得越多开销越低,可一旦领了没用完就出问题,短时超发就越大。领取窗口内实例如果崩了,它预取走却没消耗的那部分要能过期回收,否则就永久漏掉了。更要紧的是,分段预取在实例数剧烈变化时仍然会超发:因为每个实例领的是整数段,实例多了、段数也就多了,总和照样能越过总量。它的准确定位是“以可控的短时超发,换低得多的判定开销”,把超发上界当成一个可调的设计参数,而不是当成没有。
四、判定不可用时的降级与下游保护
无论走哪条路,都要回答同一件最难堪的事:限流判定本身不可用时,业务怎么办。这里建议固定三档,逐档绑死适用场景,不要临场决定。放行这一档只给那些“误限的代价远大于放过的代价”的读类接口;按最旧一次快照的额度放行,适合流量平稳、短时偏差可接受的场景;直接拒绝,是写类与高价值操作在共享处彻底失联时的默认取向。选哪一档由数据敏感度决定,而不是由“哪个实现最简单”决定。
最后一道防线要单独说清楚:下游自身的并发上限、队列长度和熔断,是限流失效时兜底的保护,但它不能替代限流。原因是它保护的是“这一个下游不被打穿”,而限流要管的是“上游总量别越界”。两者职责不同,把熔断当成限流,结果是一旦阈值触发就把正常流量也一起切断,等于用一把过猛的闸刀代替一个该精细的量程。
五、渐进上线与两套读数怎么取舍
在洹拓交付这类限流能力时,我们不会一上来就拦。渐进上线分三步走。第一步只观测不拦截,把每一层的判定结果和实际放行量分开记下来,先让两套数字并排跑一段时间,看它们对得上对不上。第二步小比例启用拦截,只放一小撮流量真按判定去挡,其余仍旧放行,比对被拦截的那部分是不是符合预期。第三步再逐步收紧比例,直到全量。每一步都要有明确的进入判据和退出判据,尤其要定死“退回上一步”的条件。
观测期最容易被忽略的是权威问题。两套算法并行时,一边是老的本地均分、一边是新的中心化或预取,同一批请求会给出不同的“是否放行”。这段时间必须以哪一套为准,要提前写死,并在指标里分列两套各自的判定与被拒率,否则灰度结束后谁也说不清哪套真的在起作用。
配套的是分列的两个读数:请求被拒率,和超发量。只看拒率会漏掉超发——拒率低说明没挡住多少,可这恰恰可能是超发的信号。真正要盯的是“实际放出去多少”和“配置允许多少”在同一时间窗内比对,两个数落在同一个窗口里才有意义,一个按分钟统计、一个按小时统计,比出来的差是假的。
六、把原则落成可核对的字段
“共享状态必须在共享处计算”是一句原则,原则不进评审、不落字段就会变形。下面这张表,是我们建议在方案评审里逐项打勾的部署判据表,每一项都要能对着配置或代码回答“是”或“否”。
| 核对项 | 要写清的内容 | 出问题时先看的数据 |
|---|---|---|
| 共享状态落点 | 剩余配额存在哪一个共享处、由谁持有 | 共享存储的连接数与延迟 |
| 写入者 | 谁有权扣减、是否只有原子入口能写 | 非原子写路径的命中计数 |
| 同步周期 | 本地快照与共享处多久对齐一次 | 快照与真值的偏差分布 |
| 上下线回收 | 实例退出时它领走未用的部分如何回收或过期 | 回收队列的积压与丢弃量 |
| 扩容重算 | 实例数变化时份额是否重算、由谁触发 | 扩容前后各实例的令牌消耗 |
| 失败取向 | 判定不可用时默认拒绝还是放行 | 降级触发次数与影响接口 |
把这六行填满,比在文档里写十句“要保证一致性”都管用。限流失灵从来不是某一个数字算错了,而是一个“大家都默认成立、但没人负责核对”的假设塌了。把假设写成字段、把字段挂上观测数据,均分这个老朋友才不会换个项目再犯一次。