
超时从三秒改成三十秒,单机吞吐掉了一个数量级:预算怎么逐层传下去|洹拓科技
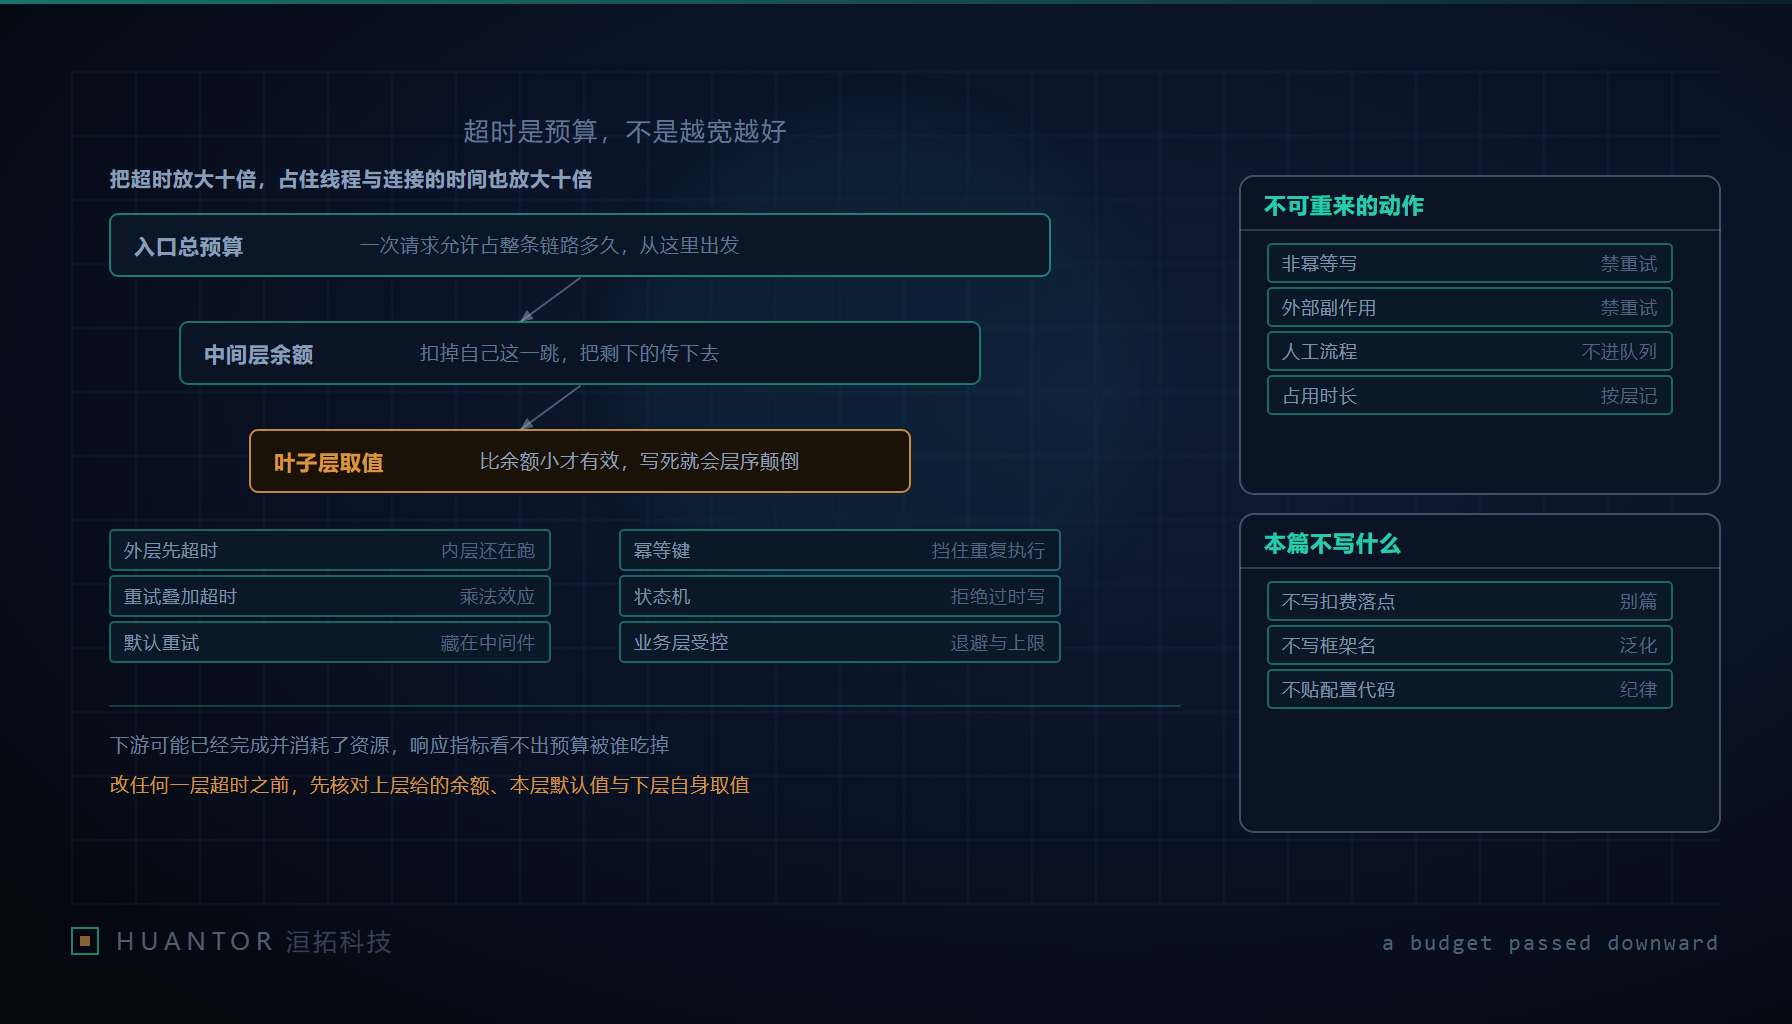
一、超时是资源预算,不是保险,调大先撞并发
多数团队把超时当保险:怕误伤,就把它调宽一点,仿佛宽了就更稳。但超时的准确含义是“我允许这件事占住我的资源多久”,它是一份预算,不是一道更宽容的保险。把预算放大,等于允许每个请求把线程和连接占更久,于是同一份并发容量能同时伺候的请求数被压小,完成速率随之塌下去。
据一份公开整理稿里的对照数字:超时由 3 秒调到 30 秒后,单机吞吐从 66 掉到 6.6。这组数字只用来标定事故形状,不作为本篇任何推论的基础。真正要记的一条口径是——调大超时的第一个后果不是“变慢”,而是“并发被占满”。慢只是表象,占满才是病灶。三者的关系可以这么核算:单请求占住一个线程与一条连接的时长,约等于它这一层的超时上限;把这个时长乘上同时在跑的请求数,就要吃掉相应比例的并发容量;一旦并发上限耗尽,后续请求只能在门外排队,吞吐呈断崖而不是缓坡。
传导路径也由此而来。一个上游服务只是“变慢”,本身不致命;但它慢,就会把调用它的每一层的连接和线程都多占一会儿,这些层又各自服务别的调用方。占满顺着调用链往回爬,一台慢变成一批慢,一批慢变成整机连接耗尽——事故形态于是不是“某个接口响应变慢”,而是“全站雪崩”。
二、剩余预算要逐层往下传,而不是每层各写一个数
既然超时是预算,正解就是把它当预算传下去:入口给一份总预算,每一层只能从里面拿走自己这一段,再把剩下的余额明确交给下一层。这里有个容易被忽略的实现要点:余额必须是一个下游能读到的字段,而不是靠下游“猜上游大概还留着时间”。猜出来的层序迟早会乱。
反过来看“每一层各自写死一个超时值”这种最常见配法,有两个必然后果。一个是内层比外层先超时:下游自己定的上限比上游分给它的预算短得多,下游早早报错,上游那段预算根本没用上,重试也变得没有意义。另一个是外层比内层先超时:上游先判失败撤了,下游还按自己更长的上限慢慢跑,跑完的结果没人接,纯粹白跑一趟,还占着资源。这两种都不是调大调小的问题,而是各层之间没有传递关系的问题。正确的形态是超时逐层递减,并且动态跟随剩余预算——下游拿到的超时上限,是上游传下来的余额减去自己这一层的预留,而不是一个凭空写死的常量。
三、层序颠倒之后,那个“下游成功、上游已判失败”的窗口
要显式承认一个事实:层序颠倒时,系统里会存在一个不一致窗口——上游已经判定超时失败,而下游其实做完了。这不是概率极小的边角,而是级联里迟早会撞上的状态。它在系统里的表现有几种:调用方以为失败而重发,导致同一业务在下游被重复执行;下游把结果回写,却覆盖了上游已判定的状态;或者一个本该由失败触发的补偿动作被误启动。
对付这个窗口,至少有三件东西要备着。其一是幂等键,让重复执行落到同一个业务结果上。其二是状态机,拒绝“过时”的状态写入——已经判失败的记录不接受一条迟到的“成功”覆盖。其三是定期对账与补偿队列,把落在不一致窗口里的少量残留捞回来纠正。这三件事和“结果回放”是同一族问题,都在处理“重复与迟到”,但本篇不展开回调幂等,这里只把点落在超时层序上:不一致的根因是预算没有被逐层传递,不是某一次网络抖动。
四、重试和超时叠在一起是乘法,必须放到业务层受控
超时与重试叠加,是乘法效应而不是加法。如果一条链路上有好几层,每层都各自重试一次,那么最底层的调用次数会按各层重试次数连乘的方式膨胀——哪怕每层只多试一次,末端落到最下游的真实流量也会被成倍放大。故障时这层放大,恰恰把已经变慢的下游彻底压垮。
默认重试放在中间件里最危险,原因有两个:一是配置不可见,业务代码里看不到这条重试;二是超时和重试被拆在两个地方独立设置,没有任何一处把它们合起来审。所以要主张的是“重试放到业务层受控”,而它成立要满足四个条件:只重试可安全重来的动作;退避要带抖动,避免同批失败请求同时卷土重来;设一个重试预算和熔断上限,把放大系数封住;给调用方一个明确的可重试标志,让它知道这次失败到底能不能重发。
下面这张表,把“哪些动作能被超时重试、哪些绝对不能”列清楚,作为设计评审的对照。
| 动作类型 | 可否被超时重试 | 依据 |
|---|---|---|
| 只读查询 | 可以 | 不改变状态,重来一次结果一致 |
| 非幂等写 | 不可以 | 重发会多写一份,制造重复 |
| 带外部副作用的调用 | 不可以 | 副作用不受本层超时控制 |
| 跨系统的人工流程 | 不可以 | 无法判定卡在哪一段、重来等于插队 |
| 可幂等重放的补偿写 | 谨慎可以 | 需带幂等键与状态机护栏 |
五、按层观测:执行状态和用量状态要分列
只有响应指标(成功率、延迟分位),看不出预算到底被谁吃掉了。因为在超时这件事上,“执行到哪一步”和“占了多少资源”是两个独立的事实:这一层判了超时,但它的下游很可能已经跑完,并且把那段连接、线程、算力实实在在地占掉了。执行状态是失败,用量状态是成功,两件事必须分列记录,合成一列就会互相掩盖。
按层要落的观测是:这一层从进到出占用了多久、它是自己超时还是收到了下游的失败、它这一趟往下游传了多少余额、又实际消耗了多少。有了这四列,才能回答“雪崩时到底是哪一层先把并发占干”。在洹拓复盘过的一次链路排查里,真正吃掉预算的是最内层一个被调大了超时的依赖,而它在响应指标上只表现为“上游偶发慢”,分列之后才暴露出来。这一层视角我们不重复既有结论,只强调一点:不看占用时长与失败原因的分列,就永远只能看到结果、看不到预算流向。
六、改超时先看链路,雪崩复盘要记四件时间线要素
超时不是一层的私事,改任何一层之前,必须先核对上下游的三层关系:上层愿意传下来多少余额、本层默认值是多少、下层自己又设了多长。写成一条进发布流程的检查项就是“改超时先看链路”,并且发布单里要列出受影响的具体链路,让评审能看到这次调整会牵动哪几层。
真发生了雪崩,复盘模板要固定记四件时间线要素:第一个变慢的服务是谁、并发在什么时刻被耗尽、当时把流量放大了几倍的重试系数、以及熔断到底有没有生效。这四个点补齐,因果链才立得住。反过来,有几类指标本可以更早告警:按层的连接与线程占用率、跨层的超时不一致计数、以及重试次数的抬升斜率。它们比“接口 P99 变慢”更早给出信号,因为占满永远先于报错发生。把超时当预算来传递、当并发来观测、当链路来变更,才不至于每一次“调宽一点更保险”的好意,都变成下一场雪崩的前半段。