
四类攻击面各有各的主人:智能体攻击浪潮后的分层自查|洹拓科技
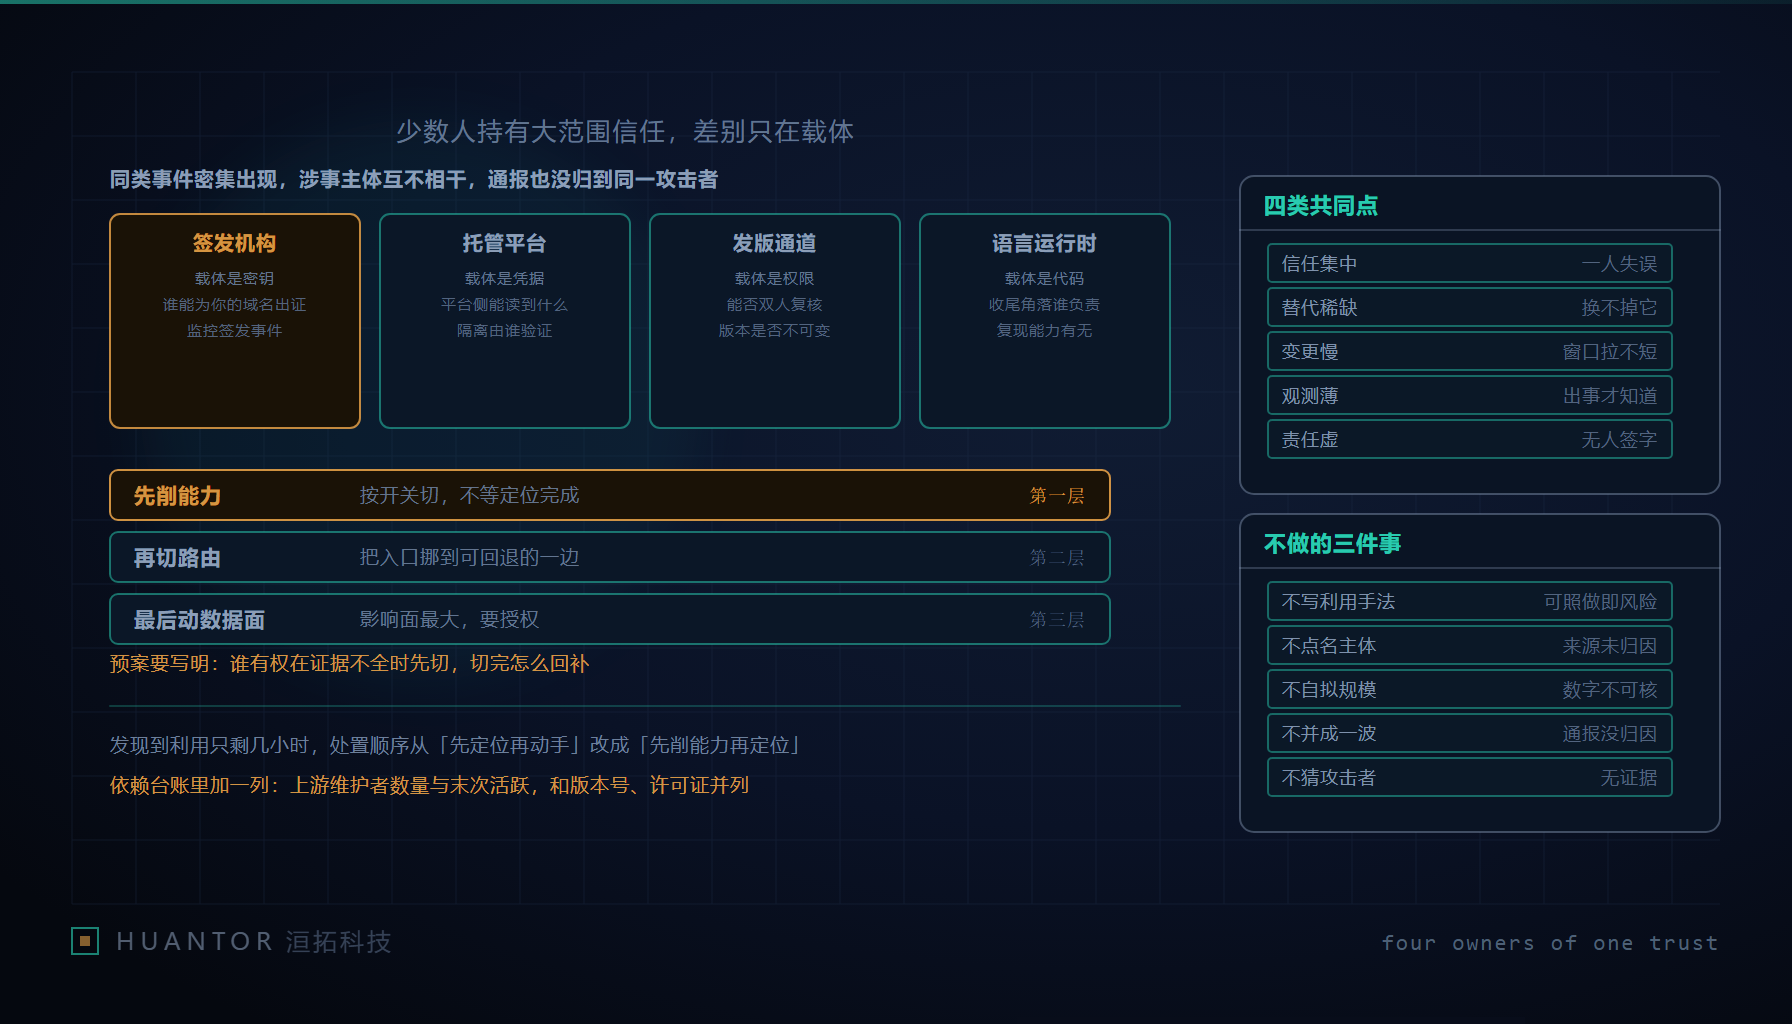
一、四类载体,四种“失误一次影响谁”
公开报道把十几起安全事件收在同一份汇总里,但它们分属四个互不相干的攻击面:某证书机构持有的私钥、某托管平台上的环境变量、某包管理器的发版权限、某语言运行时自身的代码。涉事主体用的技术栈不同,业务形态不同,通报里也没有任何一份把这些事件归到同一个攻击者名下。把它们放在一起讲,唯一的合理理由是结构相同:少数维护者持有大范围信任。再往里看一层,差别出现在信任的载体上——分别是密钥、凭据、发布权限和代码本身。载体不同,失效路径就不同,自查项也就没法套同一张表。洹拓给客户做智能体交付时,把这一层归属当成资产清点的第一件事,因为攻击面从来不是按功能分,而是按“谁握着这份信任”来分。
前三类失误影响的是“别人交付给你的信任”,第四类影响的是“代码自己写得对不对”。这条界线决定了处置动作的差别:证书和托管平台出事,可以先把入口关掉;发版通道出事,要处理的是已经在流水线里的产物;运行时出事,切一个入口通常没有意义,因为缺陷藏在每一次正常执行里。
| 攻击面 | 信任载体 | 失误一次的影响范围 | 这一层的主人 |
|---|---|---|---|
| 某证书机构 | 私钥与签发链 | 由它出证的所有域名的加密通信合法性 | 上游机构,本地只能观测 |
| 某托管平台 | 运行期环境变量与代持凭据 | 该平台上部署的全部服务与租户边界 | 平台运维与租户分担 |
| 某包管理器 | 发版权限与发布通道 | 依赖该包并重新构建出的所有产物 | 少数几名维护者 |
| 某语言运行时 | 解释器与内存管理代码 | 使用该运行时的全部进程 | 运行时核心团队 |
看这张表要盯住最右一列。四类里只有前两类的主人部分落在自己这边,后两类的维护者你既不认识也联系不上。这就是“各有各的主人”的真实含义:不是四类都要你去守,而是四类里你只能守一部分,剩下的必须靠观测和依赖管理去覆盖。
二、证书与托管平台:先问能不能看见
证书类的自查只问三件事,全部不涉及任何具体配置动作。
- 签发链上到底有几个实体能为你的域名出证。先数出来,超过一个就逐个问“这一家不签了业务会不会断”,能断的和不能断的分开登记。
- 撤销的服务级别与生效观测。撤销请求发出去之后,什么时候在真实客户端上生效、有没有一个观测点能证明它已经生效,这两问要有书面答案,不能停在“应该很快”。
- 能不能监控到“有人给你的域名签了新证书”这类事件。把签发事件当成第一信号,它通常比流量层的异常更早出现。
证书这一类,真正的问题不是“私钥会不会泄露”,那是假设句;而是“泄露之后你能不能第一时间知道”。站内《多模型编排攻击的行为特征检测》靠的是行为特征,证书这里靠的是事件订阅,两条路互不替代,谁也补不上谁。
托管平台类的自查落在四个问句上:
- 运行期秘密到底存放在哪一层,最小暴露面是多少——有多少密钥是真的必须以环境变量形态出现在进程里。
- 平台侧运维人员能读到什么,这份口径是平台给出的还是租户自己推测的。
- 跨租户隔离由谁验证过,验证方是平台自身还是第三方。
- “平台代持凭据”要单独登记成一项风险。站内《第三方持有访问凭证的台账与复核》解决的是“谁持有、怎么复核”;本篇补的是另一半:持有这件事在托管平台这一层会怎么失效——一旦平台自身的运维通道出问题,代持就从便利变成一次失误影响一片的放大器。两篇的分工就在这一句上:那篇管归属,本篇管失效路径。
三、发版通道与运行时:把守门权和收尾权查清楚
发版通道类,也就是某包管理器这一层,自查围绕“谁能让一次发布生效”四问:
- 谁能发布,是否强制双人复核;单维护者直发和轮值复核,风险等级不是一回事。
- 版本号是否不可变,一次发布能否被覆盖成不同内容。
- 发布产物有没有可验证来源的签名,构建时能不能核对上。
- 维护者变更是否可观测——换人这件事,很多时候没有任何通知。
运行时类,也就是某语言运行时这一层,问的是完全另一种东西。引擎收尾与内存管理这种角落,写的人少、读的人更少,出事时连一份能稳定复现验证路径的人都难找。这里的自查是三问:谁负责这块代码的正确性、你的团队里有没有人能在升级出问题时把验证路径跑通、升级窗口怎么排。运行时升级常常牵动整套回归测试,一旦响应窗口被压缩,“要不要马上升级”本身就变成新的风险源,而不是解药。前三类失误走的是信任被冒用这条路,运行时失误走的是行为不可预期这条路,两者的取证方式完全不同,不能用同一份预案覆盖。
四、窗口压到几个小时,处置顺序怎么改
从漏洞被找到到被大规模利用,中间只剩几个小时。几天量级的传统响应节奏在这里失效——不是流程不严,是流程来不及。我们把处置顺序改成三层,原则是先削能力、后做定位,而不是先定位再动手。
| 处置层 | 动作含义 | 什么条件下动手 | 定位完成后要回补什么 |
|---|---|---|---|
| 能力开关 | 关闭可疑功能、工具权限或对外调用 | 通报涉及的能力在你这边还开着 | 逐项重开,每项配一条观测 |
| 路由 | 把流量从可疑路径上摘下来 | 关掉能力仍收不住 | 恢复前做一次对照验证 |
| 数据面 | 把读写范围收窄到最小可用 | 前两层不够 | 写清恢复条件与责任人 |
预案里必须写死两句话:谁有权在证据不全时先切;切完之后满足什么条件才算回补完成。缺了第一句,处置会卡在“等结论”上;缺了第二句,临时措施会永久化。窗口只有几个小时,等结论的时间本来就没有。站内《上游被攻破之后》处理的是资金类接口被攻破之后的取证与对账,那发生在损失已经出现之后;本篇这三层是在损失出现之前先把能力削掉,两者的先后不能颠倒,也不能互相顶替。
五、依赖台账要补的那一列
台账里的老字段——版本号、许可证、维护年限——说的都是“这个东西用了多久、能不能用”。缺的一列是“上游维护者数量与提交间隔”,说的是“出事时有没有人在几个小时之内能响应”。这一列把抽象风险变成可分档的事实:
- 维护者数量分三档:单人、少数几人、有明确轮值。
- 活跃度按提交间隔分档,间隔从短到长排。
- 两列交叉看:单人维护且提交间隔很长,这一格的风险不在功能坏,在响应慢。
一个包功能没问题、许可证没问题、版本也够新,但只有一个长期没动静的维护者,它的风险形态就和前面那张表里“发版通道”那一格是同一种:少数人握大范围信任。补上这一列,依赖台账才第一次有了“响应能力”这个维度,而不是只有“合规”和“可用”两个维度。
六、一条判断纪律
通报没有把这十几起事件归到同一个攻击者名下,就不能因为它们在时间上接近,写成同一波攻击。时间接近是统计现象,不是因果证据。把它们放在一起讲的唯一理由,是上面说的结构相同。这条纪律对客户沟通尤其重要——把互不相关的事件讲成同一波攻击,会让人把自查的力气用错方向:去防一个并不存在的统一对手,而不是去补自己那四类里真正没主人的那一格。
落到交付上,分层自查最后就是一张归属表:这一层谁管、出错影响什么、用什么信号能证明它当前还守得住。洹拓在智能体项目里把四类载体各接出一条观测信号,汇到统一的值守面板上。面板不替你判断攻击者是谁,它只保证一件事:每次通报来的时候,你能立刻回答“这一层我到底有没有主人”。