
三万次折叠之后"手感如初":耐久测试怎么把感觉变成判据
一、值得学的是那条动作,不是那句结论
据公开报道,《华尔街日报》的科技记者用一台叫 Hingey 的定制折叠装置,把一款折叠屏手机反复开合约三万两千次,给出的结论是”开合手感基本如初”。我们不对那台设备的质量下任何判断——一次个人测试既不构成合格证明,也不构成不合格证明。
但有一个动作值得抄:他没有靠”用了一段时间觉得还行”,而是自己做了一台装置,让开合这件事变成可重复的行程。这就是耐久测试的第一件事:把行为交给机器做,人只负责定义和判读。相比之下,”手感如初”这个结论的问题不在于它错,而在于它无法被别人复核——没有人知道”如初”允许偏离多少,也没有人知道在哪个次数上测的、在什么条件下测的、按什么标准算失效。
消费电子的评测里这类说法非常多,工业客户的验收里同样多,只是换了词:”运行平稳””界面顺滑””和原来差不多”。把它们变成能签字的东西,需要四层工作:选代理指标、声明测试条件、说明加速换算的前提、交代抽样与统计。
二、四个能写下来的量,代替”手感”
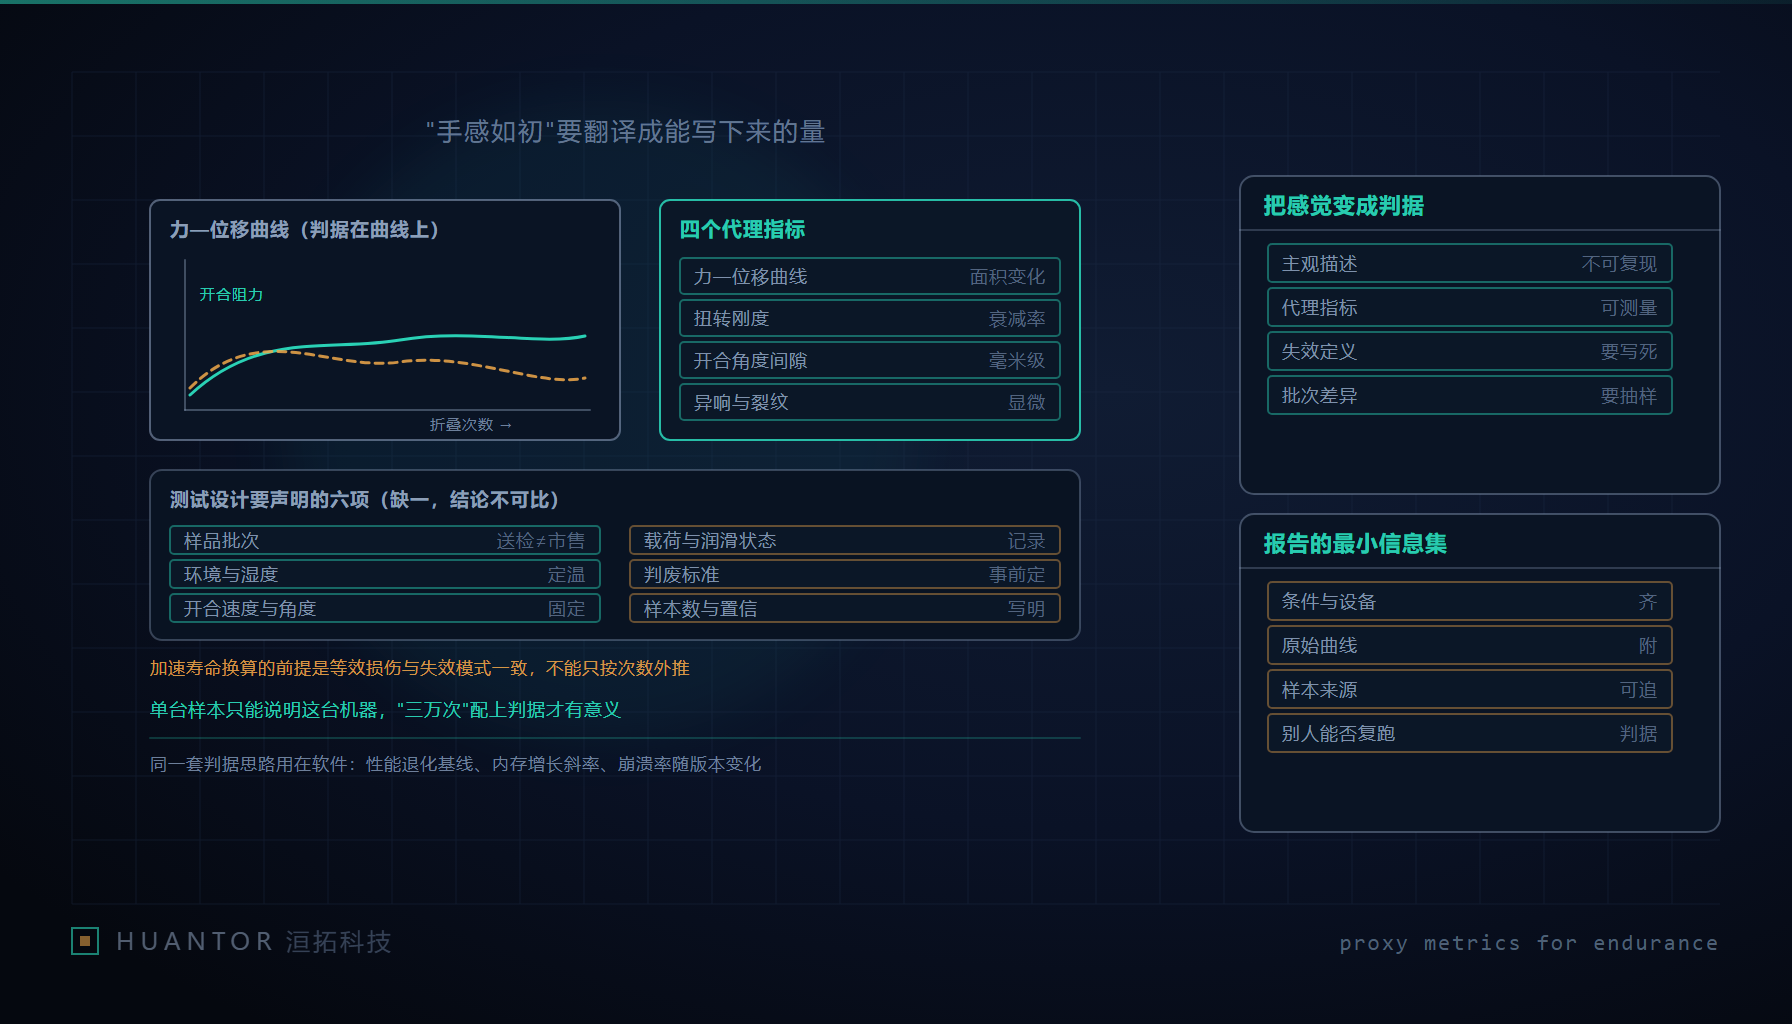
“手感”是一组感官印象的合成:开合时需要多大力、中间有没有段落感或松旷、到位时有没有吸附、有没有杂音。它对应到仪器上,是四个可记录的量。
| 观感说法 | 代理指标 | 怎么取 | 判据怎么写 |
|---|---|---|---|
| 开合阻力合适 | 力—位移(或力矩—转角)曲线 | 测力传感器加载于开合路径,全程采样 | 规定曲线上若干特征点的绝对区间,以及相对初始值的漂移上限 |
| 转轴松紧没变 | 扭转刚度、回程差 | 施加已知力矩测转角,正反行程对比 | 刚度下降比例、迟滞环面积增大的阈值 |
| 中间有旷量、屏幕边缘错位 | 开合角度偏差、面隙与段差 | 塞尺或三坐标测量指定配合位置 | 每个测点的允许区间,并规定测量温度 |
| 有异响、屏有异常 | 音频频谱特征、显示功能项 | 隔声环境录音取频带能量;坏点、触控、亮度均一性 | 出现新频率成分即记异常项;功能按失效定义判 |
关键在最后一列。判据必须是”相对初始值的漂移上限”,而不是”合格/不合格”的印象描述:一台设备出厂时的阻力曲线本身就带个体差异,只有以首件标定值为基准,”变化了多少”才是可比的。第二件要做的事是把失效定义写死——是结构断裂、阻力超出区间、屏幕出现线影,还是功能完全丧失,四者性质不同,混在一起就会出现”没坏所以通过”这种没有信息量的结论。
三、测试设计要先声明的六项,缺一项别人就无法复现
同样一台装置、同样一个次数,条件不同结论可以相反。所以报告里必须前置声明的是:
- 样品来源与批次。 量产件还是工程样机、哪个生产批次、是否特挑。供应商送检样品与市售品不一致,是耐久测试里最常见的争议来源,判据上应要求”从渠道随机购得”或”由第三方对产线末件抽样”。
- 环境条件。 温度与湿度要写成控制范围而不是”常温”;转轴润滑剂黏度随温度变化明显,低温下阻力上升,高温下油脂迁移,两个极端常常才是真实失效发生的场合。
- 开合速度与角度。 速度影响摩擦与惯性载荷,是动摩擦还是接近静态加载,结果差别很大;角度要写清是全行程、部分行程还是反复经过某一段——很多人实际使用只开合到一半,磨损集中在中段。
- 附加载荷。 空载开合与手持边走边开不是同一件事,后者有侧向力和扭转。至少要说明是否施加额外载荷、载荷大小与方向。
- 润滑状态。 初始状态(出厂涂脂/干态)、是否允许中途清洁或补脂,这条会直接改变摩擦系数的走势。
- 判废标准与中止条件。 什么现象出现就停止并记录为失效;失效之后是否更换样品继续、还是批次判定结束。
这六项里,第五、第六项最常被省掉,而它们恰好决定曲线的形状与”多少次”这个数字的含义。
四、加速寿命不是把次数乘上去
“三万次相当于用几年”这类换算,是外推最容易出错的地方。加速测试要成立,得同时满足三个前提:失效模式一致(加速时是高应力下的疲劳与磨损,正常使用是低频氧化与微动,两者不同,次数就没法换算);载荷谱等效(真实使用里有半开、急拉、带外壳开合、跌落后的偏心载荷,把这些简化成匀速全行程,等于换了台设备在测);损伤累积模型可用(对疲劳通常需要一个 Miner 型的线性累积假设,而转轴里有润滑状态变化这种非线性因素,累积假设本身要先验证)。
对铰链这类以磨损为主的部件,更稳的做法是分段观测而不是单点外推:在若干个中间点做无损测量(阻力曲线、间隙、影像检查),画出演化趋势;磨损速率如果在中段出现拐点,说明润滑状态已经变了,后面一段的寿命预测要按拐点后的斜率算,而不是按最初的斜率乘以总次数。
五、一台只能说明一台:抽样、统计与报告最小集
单台样本的结论范围只有一句话:”这台设备在这个条件下到这个次数是这样。”它能证明装置能跑、能证明没有严重的设计缺陷,不能证明批次可靠性。批次结论需要样本量与统计口径:同批取若干台、给出观测次数与失效数的对应关系、对寿命分位数报告置信区间,并显式披露批次差异——不同模具或不同装配工位的差异,往往大于同一台设备的个体差异。
报告要写成”别人能复现”的最小信息集,我们固定这几栏:样品标识与来源、批次数量、环境与设备(装置型号、驱动方式、采样频率)、行程与速度谱、载荷、润滑状态、观测点清单、每个观测点的测量方法与量具精度、失效定义、每台的实际结果(含中途异常与更换情况)、原始数据文件的留存位置。最后两栏最容易被删,而它们恰恰是复核时唯一能验的东西。
量具精度这一栏值得单独提:阻力和间隙的漂移量级常常只有几个百分点到几十微米,如果量具的分辨力与重复性不如被测量的变化,报告里的”无明显变化”就毫无意义。这也是为什么很多内部耐久测试做完等于没做。
六、把同一套判据搬到软件上
硬件评测里的这套方法在软件交付里同样成立,只是换成另一批代理指标。洹拓科技做长周期运行的产品时,把”用起来还是那么快”拆成三个量:固定场景的响应时间基线(同一组操作、同一份数据集、同一硬件配置,每次版本回归都跑,报告相对基线的偏移而不是绝对值);内存增长的斜率(连续运行若干天,取增长曲线的拟合斜率,看它是否趋于平稳,只看某个时刻的占用值会把启动峰值和真泄漏混在一起);崩溃率按版本与机型分层(总体崩溃率会被用户结构变化掩盖,必须分版本、分场景)。
失效定义也要同样写死:什么算崩溃、什么算卡死、什么算可容忍的降级,判据不同,同一份日志能得出相反结论。条件声明同样不能省——数据集规模、并发数、设备型号、网络条件,缺一栏,别人复现不了,下一次版本也没法比。
至于统计口径,有一条经验值得写在流程里:不要把耐久结论做成一个覆盖率或通过率指标,它一旦被设成考核目标,就会立刻被”把失效定义放宽”或”把观测点减少”刷掉。判据的作用是让第三个人能重跑并得到同一个答案,做不到这一点的手感描述,无论说多少次,都只是叙述。