
定长记录怎么读:从 COBOL 拷贝本到可验收的字段字典
一、先承认你拿到的是字节布局,不是数据结构
银行核心系统的外汇文件、制造业 MES 发给财务系统的接口包,很多仍然是一行一条定长记录:每条记录长度完全一致,字段靠位置定位,不靠名字定位。描述这份布局的文档就是拷贝本(Copybook),里面用层号(01、05、10)和 PIC 子句把每个字段的宽度和类型写清楚,例如 PIC X(8) 是八个字符,PIC 9(5)V99 是七位数字里带两位隐含小数。
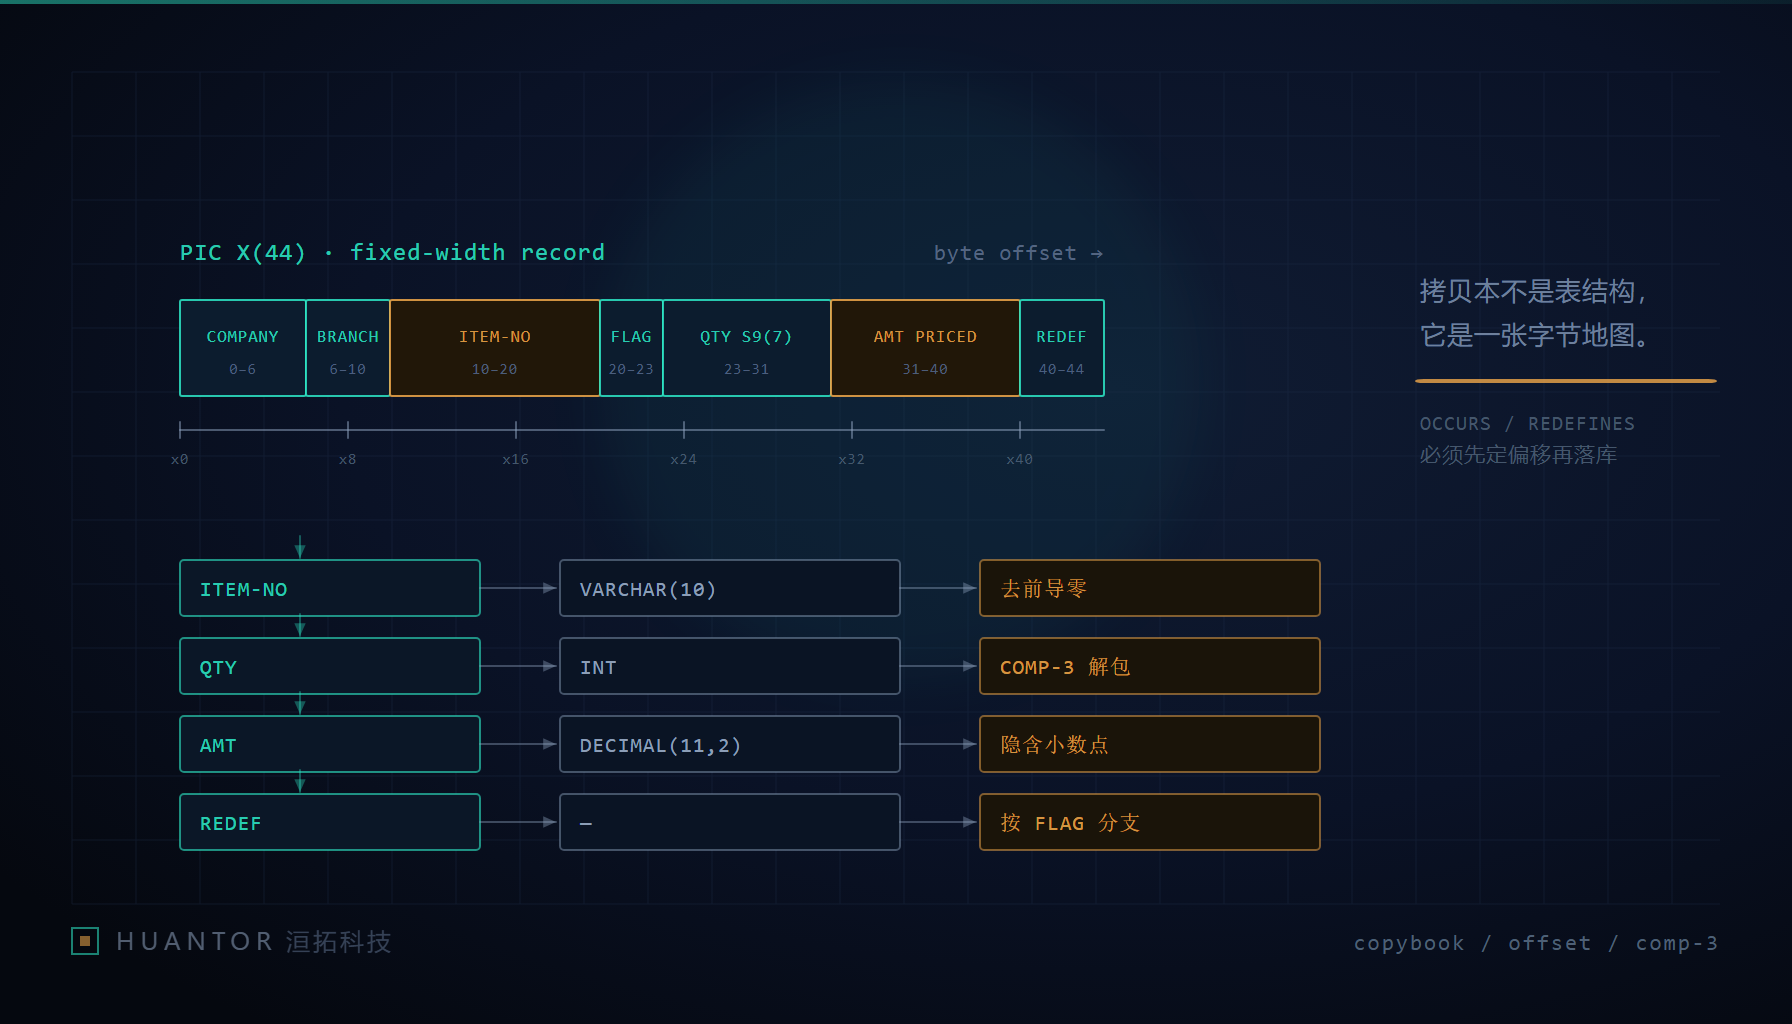
新系统这边最容易犯的第一个错误,是把拷贝本当字段清单读。它其实是三段信息的叠加:字节宽度、字段之间的包含关系、以及同一批字节的多种解释方式。第三段最麻烦,因为一段字节可能同时属于两个不同名字的字段,程序按哪个解释,结果就完全不同。我们接手这类对接时,第一条规则是先产出「偏移量 + 宽度 + 类型 + 解释口径」四元组,名字反而排在后面。
二、把拷贝本变成字段结构:JRecord 这类工具的用法与限度
Java 生态里做主机格式读写,JRecord 是被提到最多的一个库,它就是为 COBOL 定义的定长与变长记录设计的。社区问答里给出过一条 0.93 版本的可用路径:直接用静态工厂方法拿到 reader 实例,再调用取 schema 明细的方法,遍历字段对象读取名字、PIC、长度与类型名。这条路径的价值不在于省了几十行代码,而在于它把 PIC 到长度的换算、组嵌套的展开交给了解析器,人只负责核对结果。
CobolSchemaReader reader = CobolSchemaReader.newCobolSchemaReader("test.cbl"); |
问答里点出的那个坑很典型:把具体类强转成同名接口会抛 ClassCastException,根因是这个 reader 类并没有实现那个接口,只是自己提供了静态工厂与解析能力。这类问题在文档简略的库里非常常见,处置办法不是到处试类型,而是把「编译器给的类型、运行时实际的类型」打出来看一次,五分钟就能定位。
同样要记住的是工具的能力边界。同一条问答里说明,0.93 对 COBOL 语法的支持偏基础,遇到 OCCURS DEPENDING ON(变长重复组)和嵌套重定义这类结构,需要绕开扁平字段列表,改用 schema 的树根节点手动遍历。也就是说,工具能给你 90% 的常规字段,剩下 10% 恰恰是出事故的地方。解析不出来不等于文件里没有,这句话在遗留系统对接里要贴在工位上。
三、四个反复咬人的坑:现象、成因与处置
| 坑 | 现场现象 | 真实成因 | 我们的处置 |
|---|---|---|---|
REDEFINES 同一段字节 |
同一偏移位置出现两个字段名,一边金额正常一边是乱码 | 一段字节被两种结构复用,通常按某个类型码字段决定用哪种解释 | 字段字典里给该偏移打上「条件解释」标记,解析前先读判别字段,禁止两个名字同时入库 |
OCCURS 重复组 |
记录长度对不上,最后几列整体错位 | 固定次数重复组按数组展开;OCCURS DEPENDING ON 让条目数由另一字段决定 |
变长组单独建表落库,主表只留定长部分;用计数域实际值校验条目数,不一致就告警 |
| 打包小数(comp-3 / packed decimal) | 数字看着对但差一个量级,或负号丢失 | 两个十进制数字存一字节,末位半字节存符号;隐含小数点位置只在 PIC 里,不占字节 | 入库统一转字符串或 BigDecimal,禁用浮点;小数点位置由 PIC 的 V 决定,写进字典注释 |
| 字符集与末尾补空格 | 中文列出现问号或半个字符;等值查询匹配不上 | EBCDIC 与 ASCII 码序不同,定长字段用空格右对齐补齐;比较时把补齐的空格也算进去 | 转换阶段固定源码页并显式声明目标编码;所有字符列入库前做右侧空格裁剪,同时保留原始长度字段用于回查 |
第二行的问题在制造业里最常见:一条生产记录里挂可变数量的工步,字段字典如果按定长摊平,跑两周就会有一批记录解析崩。变长组落子表这一条不是风格选择,是结构约束。
第四行还有个隐蔽变体:有的老文件用 0x00 或特殊字符做填充而不是空格,裁剪逻辑只处理空格的话,脏字符会一路带到下游报表里。所以我们要求「填充规则」单独成列,由对方系统负责人书面确认一次。
四、抽样验证偏移量:上线前把风险摊开的顺序
- 先核对总长度。把字典里所有叶子字段的宽度累加,与文件单行实际字节数比对,不一致说明有字段没进字典,或者有隐含的填充区与记录控制字。
- 再核对层级归属。逐个组字段确认它包含的子字段偏移和是否等于父字段宽度,
REDEFINES的位置在这一步全部标红。 - 抽三类真实记录做人工验证:最早一条、中间随机一条、最后一条。把每个字段按偏移量取出的字节区间和值列成对照表,交给业务方读,而不是自己看。
- 数字字段单独抽查。挑最大值、最小值、全零、带负号四种样本各一条,验证隐含小数点与符号位解析方向。
- 建断言而不是建信任。把上面结论固化成校验:长度断言、字符集断言、日期字段可解析断言、数字字段范围断言,任何一条不过就整批拦下,不允许「先入库再清洗」。
- 留一份原始字节。落库时保留该行记录的原始内容或其哈希,事后有争议可以直接回到字节层面复盘。
五、落成什么格式:我们的取舍
字段字典建好之后才谈目标表设计。我们一般分三层落:第一层是原样落地层,一条记录一行,字段全部按字符串存,长度与偏移保留,作用是让任何解析争议可以复现;第二层是解释层,按拷贝本的类型语义转成 BigDecimal、日期、布尔,并把条件解释和变长组拆开;第三层才是业务视图。
为什么第一层要全存字符串:因为老文件的口径本身会漂。同一份拷贝本对不上线上数据的情况我们碰到过多次,通常是对方改了程序没改文档。全字符串落地意味着这一层永远不丢信息,漂了可以在解释层修正,不用回头重取数据。
六、洹拓视角:顺序不能反
这类项目的失败模式很统一:先看样例数据猜结构,边猜边写转换脚本,跑通了就交付。三个月后金额差一个量级,才回头发现是隐含小数点。正确顺序是拿拷贝本、建字段字典、抽样验证偏移量、定义目标格式、最后才写代码,中间每一步都要有可交付的书面产物。工具只是把某一步变快,替换不了这个顺序。JRecord 也好,别的解析器也好,判断标准都一样:能不能把字典里标注的条件解释和变长组如实暴露出来,而不是默默摊平成一个扁平列表。凡是被工具默默摊平的部分,就是后面要还的债。