
文档"一切皆可编辑"听起来很美:先问它能不能还原结构
把排版文件、图片甚至视频都说成”可编辑”,宣传里省掉的关键一步是:编辑完之后,那份东西还是不是一份有结构的文档。像素能改、文字能换、段落表格样式页码规则仍在、字段能被程序消费——这是四个不同的工程问题,代价差一个数量级,可逆性也完全不同。把它们叫同一个名字,结果就是做出一个”看着能改、改完不能用”的产品:界面上什么都能拖动,导出之后下游还是得靠人重新看一遍。
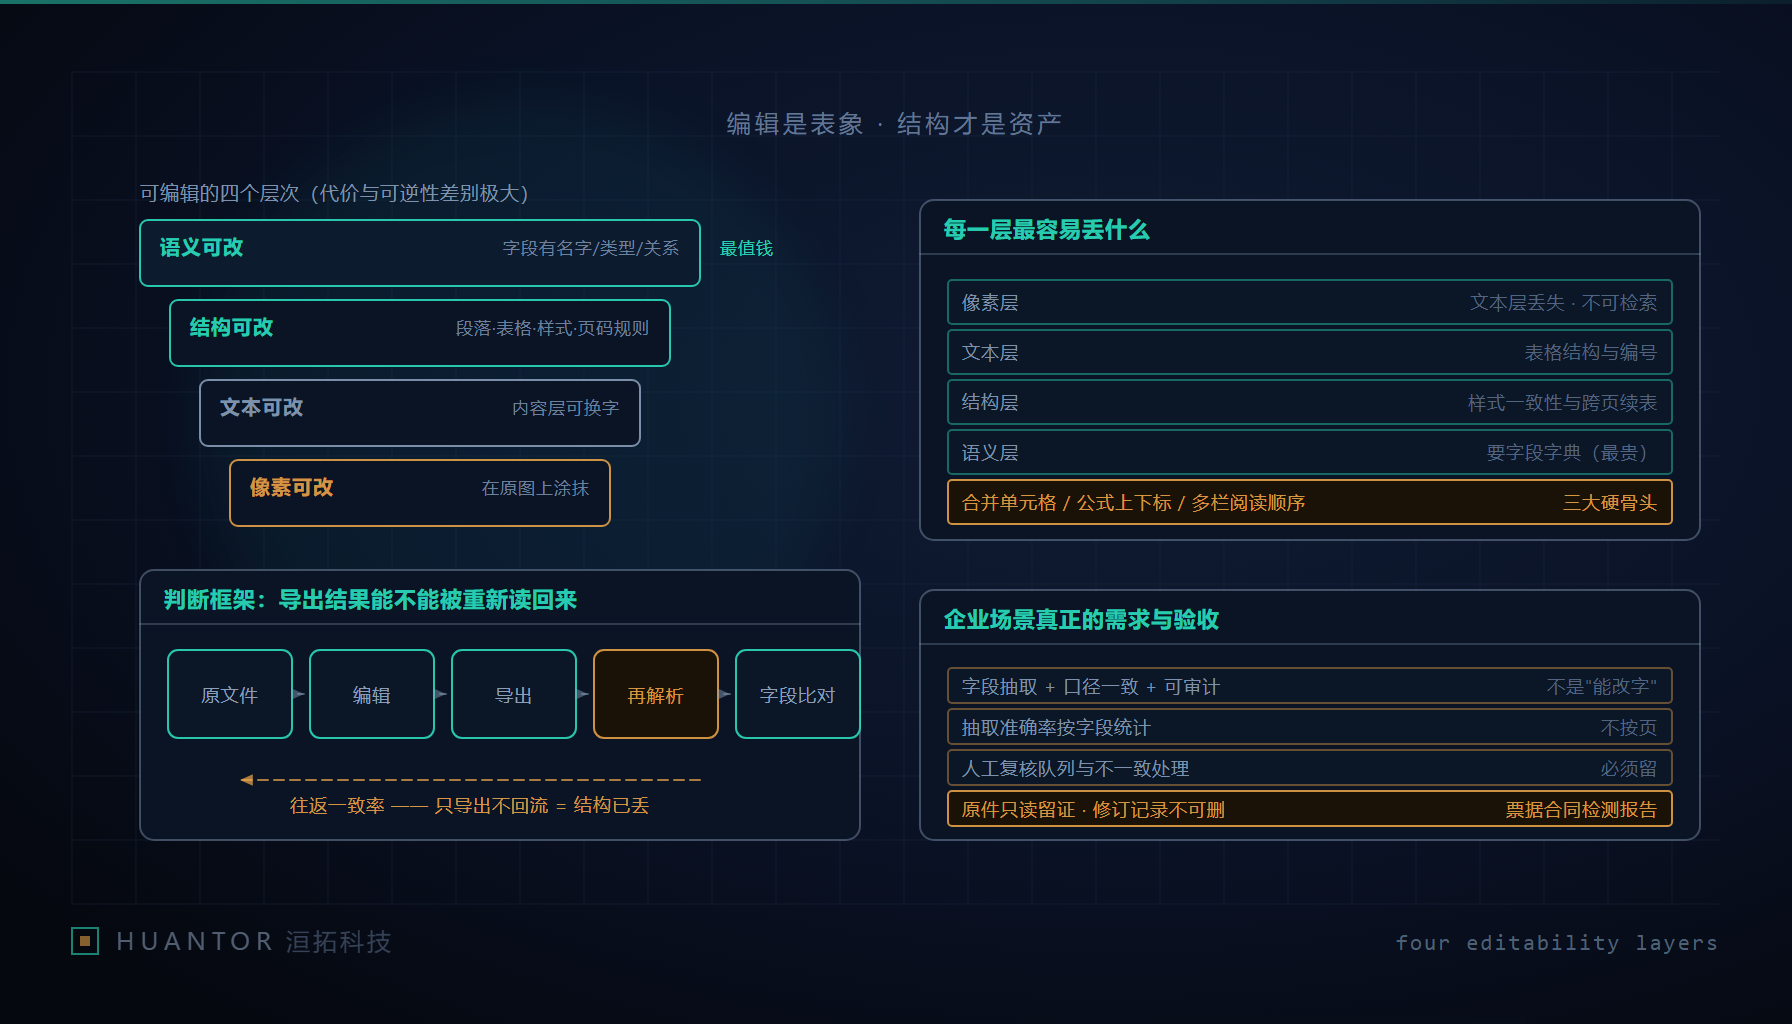
区分它们有一个不依赖厂商说辞的办法,就是往返测试。
一、判断框架:先看导出的东西能不能被重新读回来
能不能编辑是表象,能不能回流才是结构是否存在的证明。测试按四步做:
- 取原始文档,先记录结构断言:有几张表、每张表多少行多少列、合并单元格在哪个位置、编号体系是什么、公式出现在哪、有几处脚注、正文分几栏、页码与节如何规则化。这一步要写下来,不能靠评审时”感觉一下”。
- 在编辑态做一次可追踪的修改:改一个字、加一行、删一列。必须改点什么,否则”完全没变”也能通过,测试就成了自证。
- 导出为目标格式,再用一个独立解析器读回来。读回来的代码不能是产出它的那套——同源实现会共享同一个错误假设,一致率会假性偏高。
- 按结构断言做字段级比对,打分用”结构断言一致率”,不用”肉眼看着差不多”。
一致率要按字段统计,不能按页统计。按页统计会让一张二十行全错的表和一张正确的表得分相同,因为它衡量的只是页面存在。按字段统计还有第二个好处:错误可以直接落到具体对象上,复核的人知道该看哪里。
这条框架也定义了什么叫”结构已丢失”:一份能在编辑器里任意拖动、却读不出”第三行第二列是金额”的文档,它的结构只存在于渲染结果里,不存在于数据里。反过来,如果一份文档能被稳定读回成带字段名的结构并且字段有字典,”可编辑”这件事根本不需要宣传。
二、可编辑的四个层次与各自的丢失项
| 层次 | 用户看到的能力 | 常见实现 | 典型丢失项 | 失败的样子 |
|---|---|---|---|---|
| 像素可改 | 在图上涂抹、换字、局部重画 | 图像修复与重绘 | 文本层与检索性;原件与改动之间无法区分 | 图看着对,但复制不出文字、无法全文检索、无法证明没被改过 |
| 文本可改 | 内容与段落能换字 | 版面识别后重建文本层 | 表格、自动编号与交叉引用、页码规则 | 段落散成一堆行,列表编号变成正文里的数字,节与页码设置没了 |
| 结构可改 | 段落、表格、样式、分节仍是对象 | 带样式的文档对象模型 | 复杂对象的原生表示:公式、嵌入图、批注与修订记录 | 简单文档没问题,遇到合并单元格和跨页续表就散架 |
| 语义可改 | 字段有名字、类型与关系,能被程序消费 | 字段字典加抽取与校验 | 依赖人工定义与口径治理,前期成本最高 | 前三层都能做到,字段还是抽不出来 |
层次越往上越值钱,也越不可能”顺带做到”。下面两层是渲染问题,第三层是对象模型问题,第四层是数据治理问题——用同一套模型号称同时解决四件事,实测通常只落在前两层。判断一个方案属于哪一层,不用看功能清单,直接跑第一节的往返测试:把断言列表丢给它,看回来几条。
三、难点一:表格不是网格,是带跨度的拓扑
版面分析还原表格的通行做法是先检测线、得到网格,再把字符填进格子。问题在于合并单元格在表格拓扑里是一个跨度属性,而网格检测只会看到两种情况:要么把这一整块识别成一个大格,行列数对不上;要么把缺失的内部分隔线补出来,硬拆成若干小格。两种结果的共同后果是——字符都对,行列结构错了。而错误恰好落在最需要机器读的那些表上。
跨页续表要再叠一层判定:新页的第一行到底是上一张表的延续,还是另一张表的开始?可用判据有表头是否重复出现、列宽与列数是否一致、标题编号是否延续、行间空白量与缩进是否变化。判错的后果是一张表被拆成三张,或者三张独立小表被并成一张巨大的表——后者更糟,因为它在页面上看起来完全正常。
还有几处高频坑:
- 无边框表格:靠留白对齐的表,线检测拿不到任何证据,只能退化成按空白间距猜列边界;
- 单元格内换行与”新的一行记录”难以区分,尤其在没有边框时;
- 数值单元格的形态:千分位逗号、用括号表示的负数、日期分隔符差异,都会让”数值格”回流成字符串;
- 多层嵌套表头:列名需要拼成路径,合并的上层表头导出后无法还原”它是哪几列的共同前缀”;
- 表内嵌套小表与单元格内附图,多数还原链路会直接压平。
验收口径要单独加一条:网格拓扑一致率(行列数、跨度位置、续表归属),不能把它并进字符识别率里一起报。
四、难点二:公式是二维结构,按行读会丢作用域
分数、根号、上下标、求和与积分的上下限、矩阵、带编号的公式行,本质都是二维布局,符号的含义部分来自它占据的位置。按一维文本行去读取会把上下标与主字符拉到同一层:变量名后面的下标变成普通数字,带上下限的求和只剩一个符号,分子与分母的从属关系在视觉上没变但语义已经丢了。这类输出最危险的地方是它读起来像公式。
同一份文档里的公式至少有三种存在形态,而版面上看不出差别:原生数学标记对象(自身带结构化表示,可回流)、矢量图形(能缩放、能重排,但没有语义)、位图(只能当图处理)。因此在检测阶段就要分档记录”这处公式有没有可解析的数学层”,并把未结构化的位置显式列成清单。
挂在正文旁边的小结构是同一类问题:脚注与尾注的上标序号、注体与序号的跨页对应、公式编号与交叉引用。序号错一个,后面全错,而且错了没人会去核对。
可行的处置是给公式一条明确的降级路径:作为”保留的图像加原始数学源”落地,同时标出这一处尚未结构化。这比强行转成一维文本要好——转出来的错比缺失更难被发现,因为缺失会被复核,错误会被信任。
五、难点三:多栏与图文混排里的阅读顺序
阅读顺序最常见的实现是按水平行带从上往下扫。单栏时这没问题;双栏时它会把左右两栏同一高度的行交替读出来,正文变成两段互相穿插的文字。更稳的做法是先做栏块切分,再在块内按列优先排序,最后按块间关系拼接——但块边界本身要靠线、空白与缩进推断,而图文混排会不断制造假的块边界。
干扰项有一串:两栏栏高不齐、侧栏说明与正文处在同一水平带、跨栏标题被当成正文的一行、图题与图注的归属(这段文字是图的说明还是下一段的开头)、页眉页脚与页码混进正文、表格与正文互相嵌套、竖排文本、脚注区被当作正文最后一段。
这里要强调第一节埋下的那点:看着整齐但结构错了,比明显乱更危险。明显乱会被人工发现并复核;结构错位产出的段落能读通、格式规范,于是下游再没人回看原件。一份没人复核的错序文档,比一份乱到没法用的文档造成的损失更大。所以断言里必须单独有”顺序类”条目:段落总数、段落先后、段落与图的归属、跨页段落是否被切断。这几项字符识别率再高也补不回来。
六、洹拓视角:企业文档要的是字段与可审计,不是能改字
合同、票据、招投标文件、病历、检测报告这几类,需求从来不是”能改字”——原件恰恰不能改。真正要的是字段抽取准确、同一字段在不同文档间口径一致、整个过程可审计。而一旦引入生成式改图能力,证据链就从加分项变成硬要求:原件只读留存且能校验、每一处改动的记录可查、能被第三方判定”这张图是否被动过”。
我们做文档类项目时验收会写这几条:
- 抽取准确率按字段统计,不按页、不按文档;关键字段(金额、日期、主体名称、编号)单独设阈值。
- 不一致项进人工复核队列,队列要有处理时限和处置结论,而不是只出一张报表。
- 原件只读留证,导出件与原件可通过校验和区分;修订记录不可删除,版本可追溯。
- 扫描件分辨率不足、缺页、模糊区域一律显式拒识并说明原因,不允许硬猜。
- 表格的网格拓扑一致率、公式的可解析比例、段落顺序一致率三项单独出数,不与字符识别率合并。
- 往返一致率写进合同:由甲方提供结构断言集,交付时现场跑一次。
再加一份”能不能用”的五问,评审时按顺序问完:能否还原表格结构(含合并单元格与跨页续表);公式与脚注如何处理、有无降级清单;扫描件分辨率下限与拒识策略是什么;多语种与混排下的阅读顺序如何保证;导出后再回流的字段一致率实测是多少。
编辑是表象,结构才是资产。一份文档真正的价值在于三年后还能不能从里面把字段取出来、还能不能证明它没被改过——这两件事都不发生在”能不能拖动文字框”那一层。