
一个 3MB 的单文件 C# 程序能装下多少物理:N·Body 2.0 的体积与精度账
一、先把 3.3MB 这件事看清楚
原文发布在 2026 年 10 月,作者给 N·Body 2.0 放在 Release 里的产物是 3.3MB 的 NBody-win-x64.exe,他在文中的说法是「从物理引擎到渲染、界面、音乐,全部用 C# 写成,最后打包成一个 3MB 的 exe」。技术栈是 net10.0 加 .NET 10 的 Native AOT 单文件发布,工程里开了 IsAotCompatible,用户拿到 exe 直接运行,原文的措辞是「不用装 .NET 运行时」。
能确认的信息先摆在一起:整个项目大约 5000 行 C#,HLSL 着色器不到 600 行,「没有一行 C++」,界面层「没有 WinForms 也没有 WPF」,直接对着 Direct3D 11、Direct2D 和原生 Win32 写。
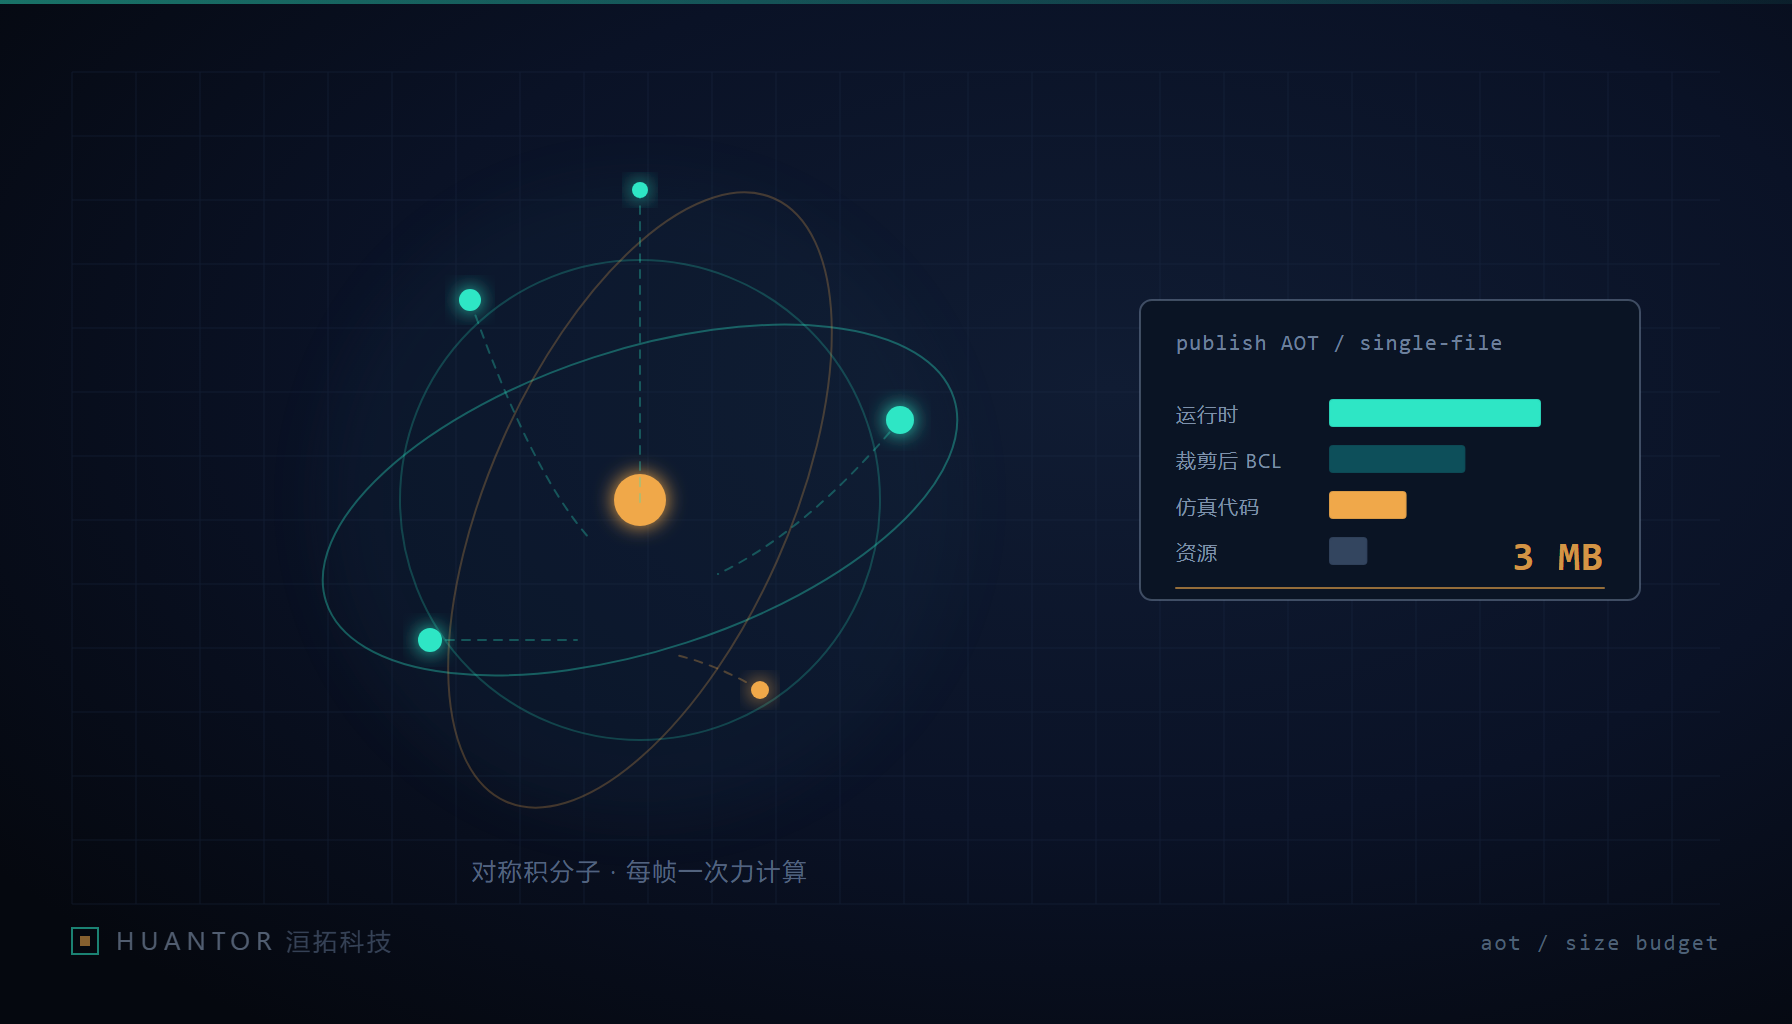
原文没有给出这 3.3MB 的分模块明细,所以下面这段是我们的推断:
- 编译后的托管代码本身占不了多少,五千行量级的 C# 加几百行着色器,产物大概率在几百 KB。
- 头部分是运行时支撑:GC、类型系统需要保留的元数据、异常路径,以及可达性分析没能删掉的那部分 BCL。Native AOT 能删多少,完全取决于你引用了什么。
- 第三块是资源:字体、纹理、音频。能压进 3MB,说明这部分也做了克制的处理。
真正的关键在第二块。这个包之所以小,不是因为”运行时被压缩了”,而是它的依赖树几乎是空的。没有第三方 NuGet,没有 UI 框架,连数学库也没用——原文很直白地提到作者自己的 Sdcb.Arithmetic 在这个项目里「依然一行都没用上」。依赖图干净,可达性分析才能把不用的部分整段删掉;换成一群带反射入口、带动态序列化的库,裁剪收益立刻兑现不出来,还会附加大量保留声明。这是我们看完最想抄的一条经验:AOT 的体积收益是删出来的,不是配出来的。
二、四种积分器,分的是一份误差预算
物理部分是这篇文章我们最想细看的地方。项目里放了四种积分器:Leapfrog、Yoshida 4、RK4、Dormand–Prince 5(4),运行时按 I 键切换。原文给出的对照很干脆:Dormand–Prince 的能量误差在 10⁻¹⁴ 量级,RK4 在 10⁻⁶ 量级。
从工程角度看这四个不是”精度阶梯”,是两种不同的错误形态:
- Leapfrog 和 Yoshida 4 属于保结构的方法:单步便宜,能量误差不随时间单调发散,长时程跑下来轨道形状不散但相位会漂。星系碰撞这种要盯着看很久的场景应该用它。
- Dormand–Prince 5(4) 是自适应步长的显式 Runge–Kutta,每步要多次求导再加步长控制,单步贵得多,换来的是可控的局部误差。三体周期解这类要严格对齐的轨道就得上它。
- RK4 夹在中间:固定步长、四阶,比自适应便宜,但误差稳定累积,跑到后面能量会漂。
八个数量级的差距摆在那里,正常直觉是”能加载 10⁻¹⁴ 的就不该用 10⁻⁶ 的”。可这篇文章里恰恰相反:演示蝴蝶效应的场景需要的是误差被放大——只有让数值误差参与进来,两条几乎重合的轨道才会在有限时间内分岔。精度是预算,不是美德,按场景分配才是工程。
规模数字也在同一节:65,536 颗恒星,跑满 60 帧,相互作用数量原文写作「40 多亿对」。这个数怎么来的:65,536 就是 2¹⁶,它的平方正落在 4.3×10⁹ 量级,即朴素双重循环的求值次数——这印证了作者说的 GPU 暴力 O(N²):不是近似算法,是把 N² 全部算完,放到 Direct3D 11 的 compute 上;小场景才走 CPU,靠 SIMD 和并行。每帧 4.3×10⁹ 次要压进 16.7 毫秒,靠的是算力而不是剪枝。
还有一点我们格外看重:作者用 xUnit 测试来验证能量和动量守恒。科学计算类的演示程序最容易糊人的地方就是”看起来对”——画面好看,物理是假的。
三、3MB 是怎么删出来的
把原文里可以当作删除清单的信息抽出来,一共四条:
- 删掉 C++。 原文强调「没有一行 C++」,物理和渲染都在托管侧解决。收益是不用维护两套工具链;代价是要自己确认热路径编译得足够直白。
- 删掉 UI 框架。 不走 WinForms 也不走 WPF,直接用原生窗口加 Direct2D/Direct3D 11。这是最划算的一刀——UI 框架通常是托管程序里最大的一片保留面积。
- 删掉第三方数学库。 连作者自己的库都没用上,精度靠积分方案本身解决。
- 删掉运行时交付。 单文件 AOT 让终端不需要装 .NET。严格说这条不是删体积,是把体积从安装包转移到了每个终端上。
四条合起来解释了 3.3MB 为什么可达。我们对照过自己的项目,坦白讲大多数做不到:不是写不出那五千行,而是依赖树里总有几个删不掉的东西——报表库、序列化库、某个只有反射入口的配置组件。
顺便记下文中的开发数据:这一版涉及 77 个文件、新增 6396 行、删掉 1528 行,AI 侧重构调用 239 次,账单约 25 美元,输入 token 约 6924 万、输出 token 约 35.3 万。这组数字对我们做报价有参考价值:几千行规模的单体功能重写,AI 参与的边际成本已经低到可以忽略,真正的成本落在人复核数值正确性那一段——而原文刚好用测试把这一段覆盖了。作者另外放了一个 WebGPU 的浏览器版本给非 Windows 用户,说明这套物理内核没有绑死在某一平台上。
四、什么业务值得为体积和冷启动做裁剪
我们做边缘侧和客户端交付时反复被问”能不能再小一点”。这不是万能药,要按判据过一遍。
值得裁的三种情况:
- 分发环境带宽受限。工业现场的边缘盒子、4G 回传、门店终端,一次升级摊到几百台设备上,包体每小一档,升级窗口和失败率都会跟着动。
- 冷启动本身就是产品指标。桌面小工具和演示用的可视化程序,双击到画面出现的时长用户能感知,N·Body 正属于这一类。
- 交付物要求”免安装”。给客户一个可执行文件而不是安装程序,现场运维的成本差一个量级。
不值得裁的三种情况:
- 服务端容器里的应用。镜像层有缓存,体积在拉取阶段被摊薄,为几 MB 去砍依赖、加保留声明,抵不上引入反射故障的风险。
- 业务逻辑靠反射或动态序列化撑着的系统。AOT 会把这类问题变成运行时静默失效,排查成本高于省下的带宽。
- 需要长周期演进的插件体系。保留了加载任意程序集的能力,就等于保留了绝大部分体积。
我们的判断是:包体积是一项分发侧的成本,不是代码质量的指标。把它当指标去优化,很容易做出一个 3MB 但三年后没人敢加功能的项目。N·Body 之所以成立,是因为它的功能集合是封闭的——一个演示程序,不需要接客户的数据源。
五、我们的体积预算表
边缘侧和客户端交付立项时,我们按下面这张表分配预算。表中数字是我们内部的目标口径,不是从原文测来的,落地时按具体 SDK 版本重新标定。
| 模块 | 预算 | 裁剪手段 | 代价 |
|---|---|---|---|
| 运行时与 GC | ≤1.2MB | 单文件 AOT 发布,按可达性裁剪 | 未保留的类型在运行时静默失效,需要一套启动自检 |
| 语言与区域行为 | ≤0.4MB | 关闭用不到的全球化与时区特性,具体开关以当时 SDK 文档为准 | 排序、日期格式、大小写规则的差异要在测试里显式覆盖 |
| 第三方依赖 | ≤0.8MB,且单项可枚举 | 直接调系统 API 替代框架级封装;每个依赖写明引入理由 | 自研代码量上升,功能边界要人守 |
| UI 层 | ≤0.5MB | 不用桌面 UI 框架,走原生窗口加自绘 | 控件的可访问性和主题跟随要自己做 |
| 资源 | ≤0.4MB | 字体子集化、纹理程序生成、音频优先压缩率 | 视觉与听觉的质量下限被锁死 |
| 预留额度 | ≤0.3MB | 不给手段,只给额度 | 超支即触发一次架构复盘,而不是”再挤挤” |
这张表里最重要的不是数字,是”超支即复盘”那一条。体积失控从来不是某个模块偷偷变大,而是新增了一个依赖,然后那个依赖又带进来三个。
六、三条我们会带走的东西
- 先审依赖图,再谈 AOT。 只要依赖里存在任何一个用反射或动态加载的库,裁剪收益就会被保留声明吃掉;先解决依赖,再解决发布方式。
- 数值内核必须有守恒量断言。 原文用 xUnit 测能量和动量,这个做法可以搬进任何带物理、金融或统计内核的项目,成本极低,能挡住绝大多数”看起来对”。
- 精度按场景分配。 同一个程序里 10⁻¹⁴ 和 10⁻⁶ 都有存在的理由,我们的报表和控制算法同理——把误差预算做成配置项,比做成注释有用。
至于原文那句「谁说 C# 只能写 CRUD?」,我们的读法更平淡一些:能不能写出不带框架的 3MB 程序,取决于你愿不愿意放弃框架带来的那些便利,而大多数商业项目里放弃它们并不划算。这篇文章的价值不在于证明托管语言做得到,而在于把”要做到需要什么”完整摊开了。