
手机下指令、家里主机干活:跨设备任务最先断的是状态
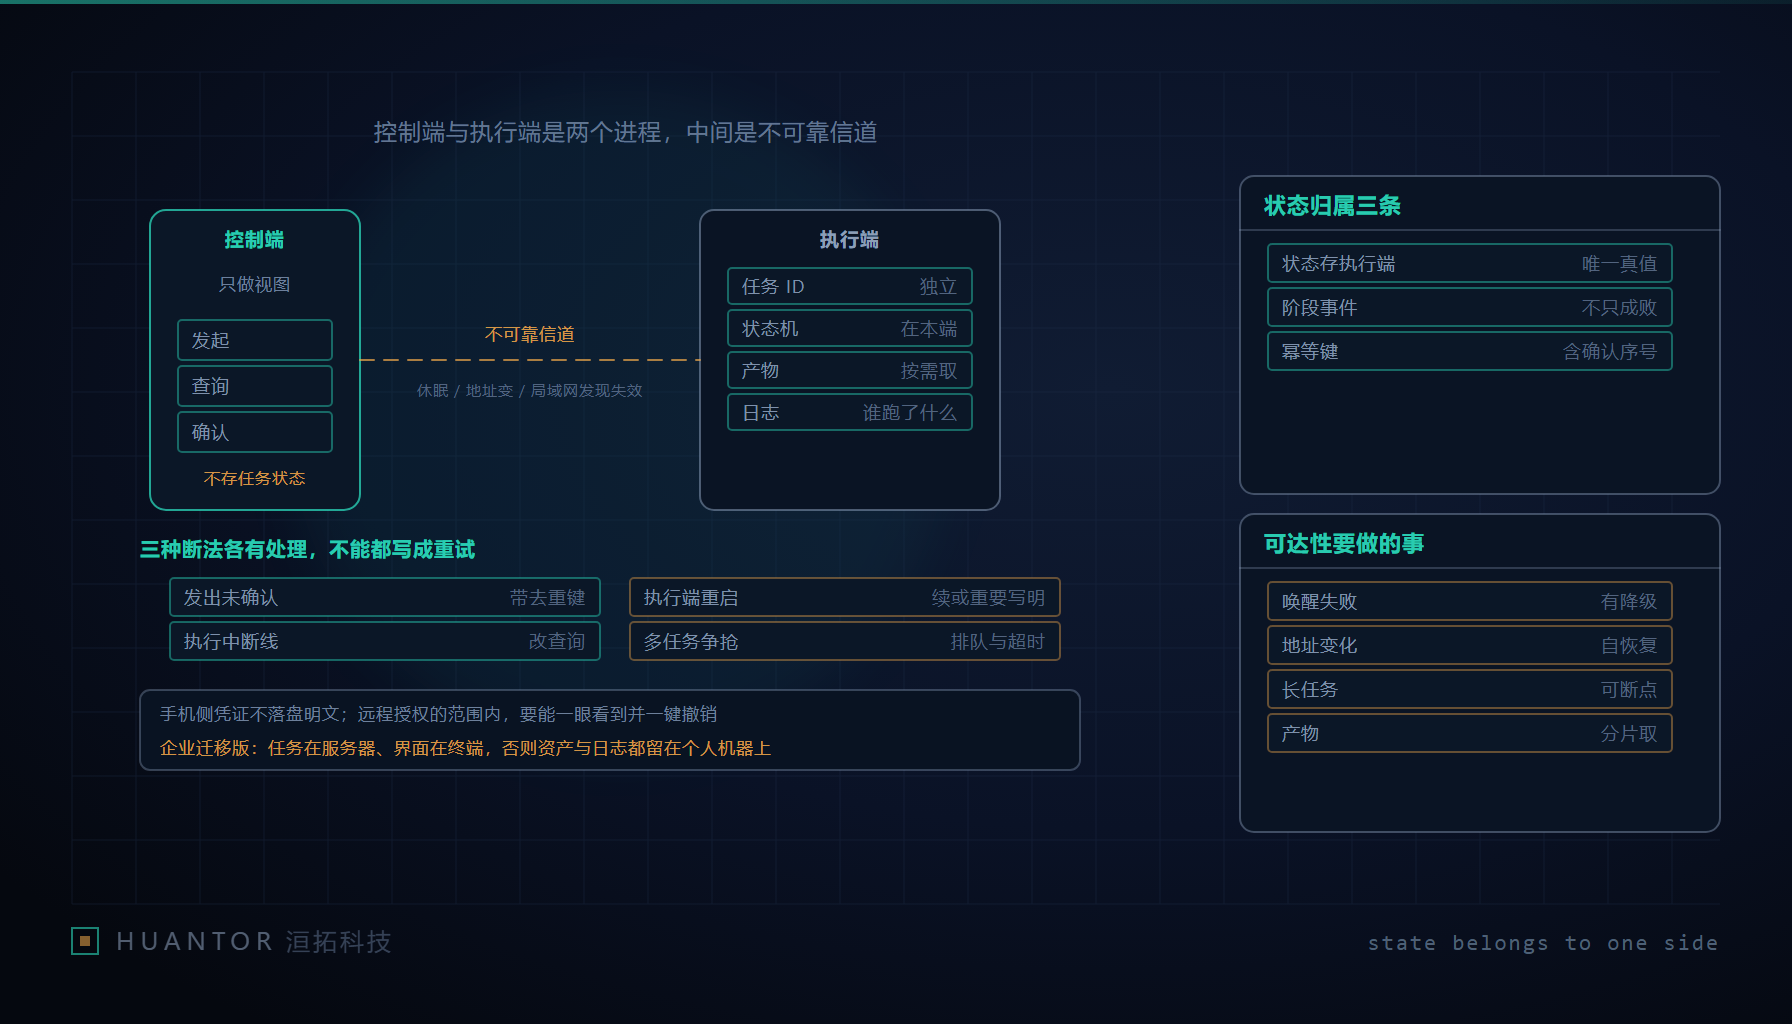
一、这不是远程控制,是两个进程隔着一条不可靠信道
据公开报道,有人用一部折叠形态的手机当日常入口,把需要本地算力的重活交给家里一台大内存主机跑,来源给出的主机参数是 256G 内存、约 1.2TB/s 的内存带宽。这两个数字在这里只说明一件事:入口端和执行端的能力不对称,差了一个量级。它们不是本文任何判断的依据,我们也不评价这套组合值不值。
能力不对称带来的结构变化,比”手机当遥控器”这个说法严肃得多。入口端负责意图与确认,执行端负责算力与副作用,中间那条链路随时可能没有:手机进电梯、主机进睡眠、家里的地址变了、执行端进程被杀。工程上这就是两个进程通过不可靠信道协作的经典场景,只是信道上跑着”人正在等着看结果”的实时预期。
所以第一件事不是选协议,是定状态归属。我们的取舍很明确:任务的一切权威状态放在执行端,入口端只做视图。一旦手机本地存了”我认为它现在在跑”,系统里就有了两份真相,之后所有诡异现象都来自这两份真相的差值。
二、任务要有自己的身份证:最小字段集
一条任务从提交到结束,手机看到的应该只是这份记录的投影。这份记录至少要带下面这些字段,缺一个都会在某个断线场景里变成玄学问题。
| 字段 | 为什么必须有 | 没有它会怎样 |
|---|---|---|
| 任务 ID | 由执行端生成、全局唯一,入口端只透传不生成 | 重连后手机无法认领自己提交的那条 |
| 幂等键 | 在用户显式确认后生成,同一意图复用同一个 | 用户多点一次确认,就真跑了两遍 |
| 状态 | 有限状态机的枚举值,不放自由文本 | 前端只能靠提示语猜进度 |
| 阶段事件序号 | 每个阶段事件带单调递增序号 | 乱序到达的进度把状态往回跳 |
| 产物清单与分段 | 每个产物的路径、字节数、可按段取的范围 | 只能整包推给手机,弱网直接失败 |
| 心跳与租约 | 执行端持有租约,超时即判定失联 | 卡死的任务永远显示运行中 |
| 发起端与确认记录 | 哪个终端、哪个用户、哪一次确认 | 出问题时还原不了是谁授的权 |
| 撤销记录 | 撤销请求时间与实际停止时间分开记 | “我早就点了停止”无从核对 |
状态机要写死,别用”进行中”这种能塞下一切的值。我们的最小集合是:已受理、已排队、运行中、部分产物可读、需要输入、已成功、已失败、已取消、结果未知。最后两个必须存在——把”不知道”承认成一个状态,比把它折算成失败或成功都诚实。”结果未知”要触发一次重查询,而不是直接把结论渲染给用户。
现场判据也很直接:杀掉手机应用再打开,如果任务状态丢失、跳回排队或者显示成两条,那是状态归属放错了,不是网络差。
三、断线与重启是三种病,不能开同一张方子
第一种,发起后未确认。手机把请求发出去,没收到回执。它可能已经通了,也可能没通,最危险的是”通了但你不知道”。处理方式是重试必须携带同一个幂等键,服务端以”用户加幂等键”做唯一约束,冲突时把已存在的那条任务原样返回,让入口端认领而不是新建。这里键不能只取会话 ID:会话会被系统回收后重开,同一个会话里用户也可能确认两件不同的事。键里要带上用户显式确认的序号,或者干脆由执行端在受理时回执一个确认号,后续所有重试都围绕这个号。
第二种,执行中断线。任务在跑,手机掉线了。错误做法是重连之后继续等推送——推送在断线窗口里丢了就永远等不到。正确做法是重连即拉取:入口一上线,先按任务 ID 拉一次完整状态,再拉事件游标之后的增量,然后恢复订阅。拉取必须带分页与上限,长任务攒了几百条阶段事件时不能一次回灌,否则手机端自己先被压垮。
第三种,执行端重启。主机断电、系统更新、进程被杀,回来时有一条正在跑的任务。怎么处理不该由代码随手决定,判据要摊开写:
| 情形 | 处理 | 判据 |
|---|---|---|
| 有检查点,副作用只在本地 | 续跑 | 阶段产物完整可校验,且恢复成本低于重跑 |
| 无检查点,计算可重入且无外部副作用 | 重跑 | 单次时长可接受,重跑不产生第二份外部影响 |
| 有外部副作用(发消息、下单、写别人的系统) | 标失败或转人工 | 无法证明副作用只发生一次,一律不自动重试 |
| 判断不出处在哪一步 | 置”结果未知”并冻结 | 宁可不给结论,也不猜 |
这张表里最值钱的是那条纪律:能不能自动重跑,取决于副作用是否外部可见,跟这条任务看起来重不重要没有关系。
四、进度、产物与排队:返回粒度决定它能不能天天用
长任务只回”完成/失败”两个状态,用户会以为它死了,于是重复提交,排队系统才真正开始承压。阶段事件要按”用户能据此做决策”的粒度切:输入准备完成、模型加载完成、第 N 段处理完、首个产物可读、开始清理。每个事件带序号与时间,入口端按序号去重,展示上就是一条不会倒退的进度线。
产物要能按需取。手机上大概率只想看一眼结果长什么样,并不想要完整原始文件。所以同一份产物至少准备两个形态:一个足够小的预览(缩略图、文本节选、表格前若干行)随事件返回,原始文件分卷存放、分段拉取,并把总字节数事先告诉用户。整包推送在弱网下的失败率,会把这套体验砸回”还是得回电脑上看”。
排队必须显式,因为争抢是物理的:同一台主机上多个任务抢同一份显存和内存带宽。至少定四件事:
- 并发上限按资源池设,不按任务数设。显存吃紧时同时跑两个大任务和跑八个小任务是两种结果。
- 优先级要有缺省值和上限。允许”我自己给自己插队”的产品,最后一定退化成所有人插队。
- 排队位次和预计等待要回给入口端。看不见排第几,用户就会重提交。
- 排队超时与执行超时分开设。前者到了直接拒绝并说明原因,后者到了才走取消流程,不要把排队时间算进执行超时里。
同一账号从手机和桌面同时提交时,要落到同一个队列,不能一端一个队列——那又是一份真相。
五、可达性与唤醒:最先坏的是”找不找得到那台机器”
家里主机这条链路有三类典型失效,降级路径要事先写死,不要在用户点下确认之后现场发明。
主机在睡眠。入口探测到不可达,先走唤醒:网络唤醒、电源计划里的定时唤醒,或者由一个常开的边缘节点代为唤醒。唤醒失败就把任务留在队列里,并明确告诉用户”主机上线后开始”,同时保留取消入口。这里有个容易混过去的点:”唤醒包发出去了”不等于”主机醒着”,唤醒之后要有回执确认才能改状态,否则界面会长时间停在一种假的乐观态上。
地址变化。家用网络的地址并不稳定,公网可达性也不保证。常见的稳妥做法是由执行端主动出网注册一条连接通道,入口端找通道而不是找地址。对我们的启示是:入口端永远不要把一个直连地址当成长期凭证缓存下来,它必须有有效期,失效后重新寻址,而不是对着旧地址重试到超时。
局域网发现失效。多个 SSID、访客网络、路由器客户端隔离都会让本地发现失败。降级顺序应当是:本地发现失败后转注册通道,通道也不可用时转”排队等待上线”,最后才提示用户到主机前手工操作。把云端中转当第一选择要想清楚代价——它最省事,但恰好抹掉了这套方案一开始的卖点:数据和处理都留在本地。
六、安全边界与企业迁移:别让记录和日志留在个人机器上
入口端最容易被省掉的是凭证存储。手机侧的长期凭证不能明文落盘,要交给系统级的安全存储;能绑定生物识别的,就把它和一次一签结合起来,别让一个 token 通吃所有动作。远程执行这种能力,授权范围必须一眼可读:允许在哪台主机上、允许哪一类动作、允许到什么时候、当前有几个任务在跑。撤销要一键,还要说明撤销多久生效——正在跑的是立刻终止还是跑完当前阶段才停,这个差别要写在按钮下面,否则用户会以为撤销就等于终止。
执行端这边必须留审计:谁在什么时候跑了什么、依据哪一次确认、产出了什么、被谁取消、取消是否成功。一条日志不留的本地主机,出事时只能靠回忆。
这套结构还有一层更实际的意义。企业里让员工在本地机器上跑重型工具——模型推理、大批量数据处理、编译与仿真——入口同样常常是手机或浏览器。如果照搬家庭玩法,状态在终端、日志在终端、产物也在终端,那么资产、凭证和操作记录就全部沉在个人机器上:人一变动,历史任务无法解释,产物无法追回,出了问题定位不到时间点。洹拓在评审这类方案时用一条判据:任务状态、阶段事件、审计日志和产物索引落在服务端,终端只保留视图和短期缓存,本地只允许存被明确标注为”可本地缓存”的数据。凡是某个功能只能在一台特定机器上解释自己发生过什么,它就不该进生产。