
论文和社区讨论挂上钩:实体对齐与引用字段的写法
一、这类问题的名字叫实体对齐,难点不在连而在字段
有个知识社区推出开源计划并上线了几项科研功能,能一键查看某篇论文的站内讨论、把问题关联到论文卡片,对外说法是用 AI 把论文站点和社区内容连接起来。这些功能的具体名称和实现细节来源没给,我们不去补,也不评价它对谁有学术价值。真正值得写下来的是它背后那个通用问题:论文在论文站上有一份记录,讨论在社区里有一份记录,两边都存在,就是连不上。这件事工程上叫实体对齐,而它难的地方从来不是”建一条外键”,是字段怎么定、冲突怎么判、状态怎么更新。
本文给一套能直接落库的设计:先分清标识,再定关系类型,然后走四步对齐流程,最后补上校验与更新。核心交付物是第三节的关系类型拆分和第四节的对齐四步,其余都是让它们跑得住的配套。立场摆明在前面:模型在这个链路里负责把候选召回和打分做便宜,把判断权留给人和规则;把它说成”模型能自动对齐全部”是甩锅,后文会说为什么。
二、先分清标识:同一篇论文不止一个名字
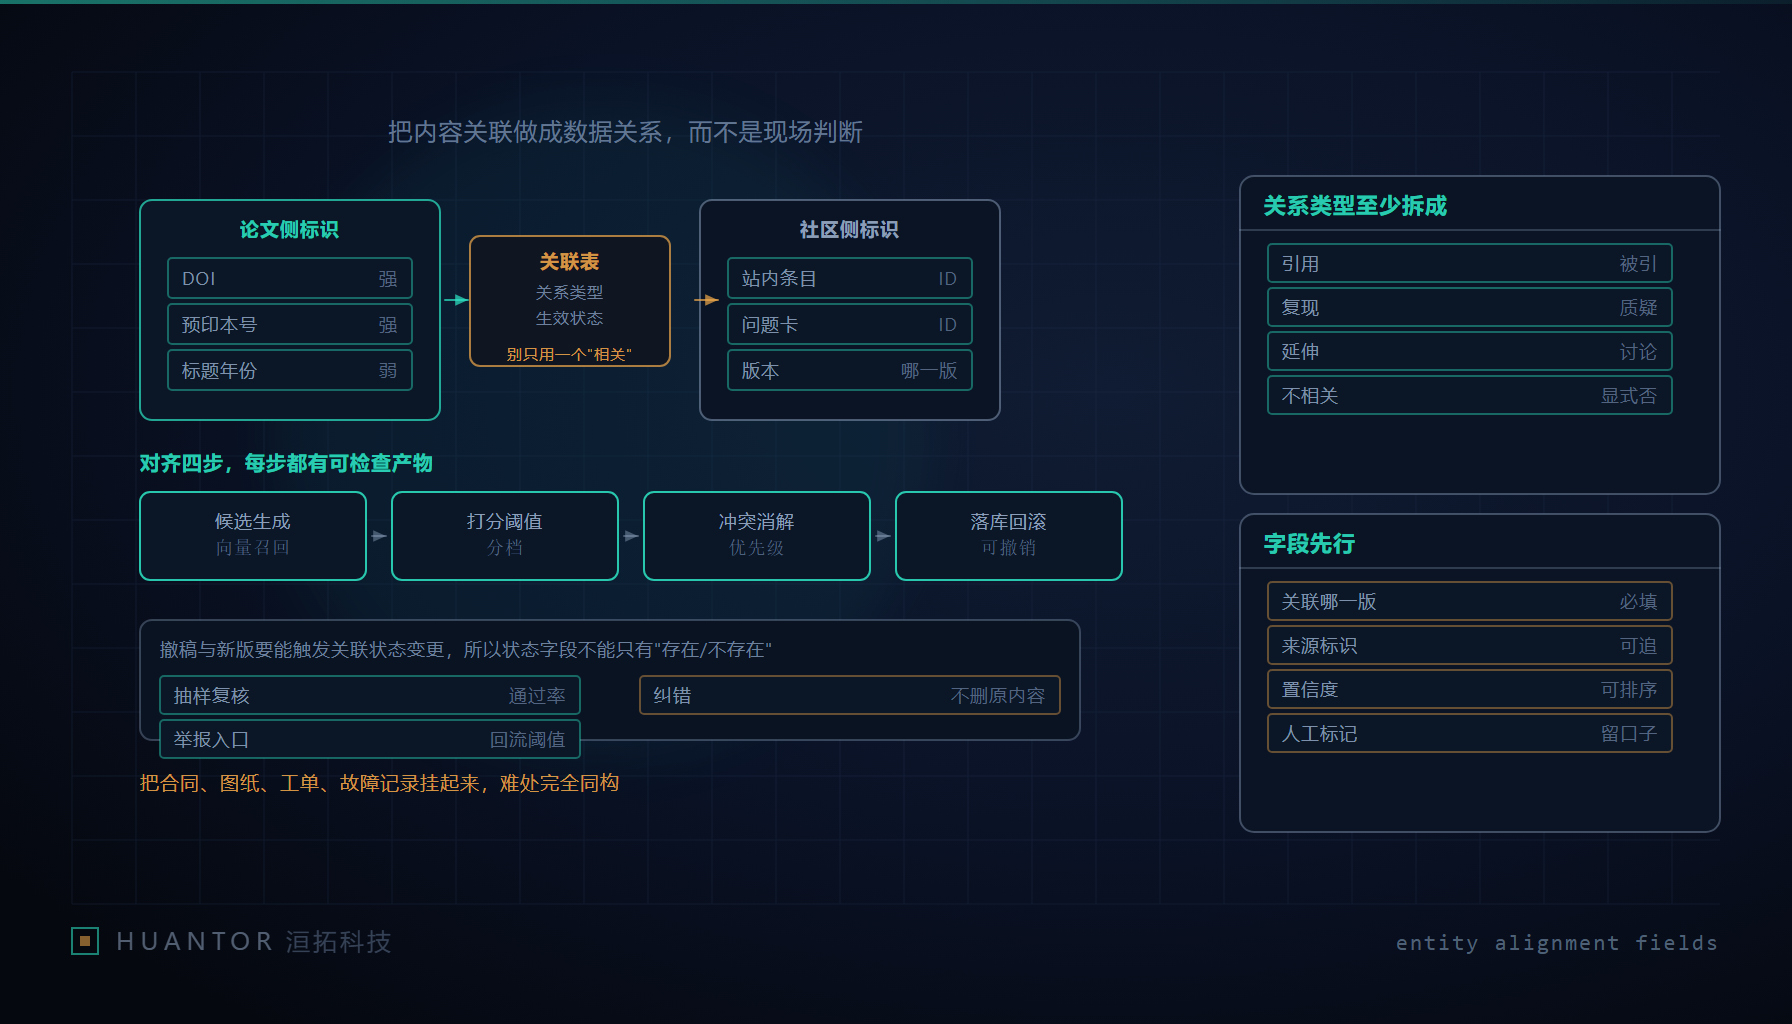
对齐的第一步是承认”一篇论文”没有唯一自然键。论文侧至少要并存三种标识,各有各的可靠性:arXiv 号覆盖预印本、更新快但同一工作可能挂多个版本;DOI 覆盖正式出版、稳定但预印本阶段常常还没有;标题加年份只是弱匹配,用来在两者都缺时兜底,且必须允许它误配。社区侧则用站内 ID 标识讨论、问题、回答这些内容对象,它们本身不是论文,只是”指向某篇论文的内容”。
关键的字段设计在关联表上:一条关联记录必须明确”关联的是哪一版论文”,而不是笼统挂到”这篇论文”。因为预印本和正式版内容可能不同,甚至结论相反,用户从讨论跳过去时如果落到被后续版本推翻的那一版,就是错关联。所以关联表的主键之外要有两个字段:论文标识(含标识类型和版本号)与社区内容标识,再加一个关系类型(见下节)。少存版本这一列,将来版本更新时你连该撤销哪条都查不出来;多存一个标识类型,则是为了让同一篇论文在 arXiv 号和 DOI 都到位时能做合并而不是当成两条。
三、关系类型不能只剩一个”相关”
最省事也最没用的做法,是所有关联都写成”相关”。一旦只有一个类型,排序就没法差异化:引用关系和质疑关系在业务上权重完全不同,混成一个”相关”就只能一律加权,等于没区分。至少拆成这么几类,每类给不同的展示与排序语义:
- 引用 / 被引:方向明确的硬关系,通常来自论文正文的引文,可信度高,用来做知识图谱的骨架。
- 复现:某讨论声称复现了该论文,独立于”讨论”,因为它暗示可验证性,排序上应单独加权。
- 讨论:泛化的内容关联,量最大、噪声也最大。
- 质疑:对结论或方法的反对,价值高但最需要人工确认,误标会让作者页挂上不实的批评。
- 延伸:基于该论文的后续工作或应用,方向性弱于引用。
拆类型的收益是让”该把哪条关联摆在显眼位置”变成一个可计算的规则,而不是靠模型每次现场拍脑袋。
四、对齐流程四步(本文核心交付物)
把两边连起来是一条固定流水线,四步各自有明确的输入、判据和失败出口。
- 候选生成:从社区内容里抽出它提到的论文线索(正文里的 arXiv 链接、DOI、标题串),再对没有硬链接的,用标题、作者、摘要做向量召回补一批候选。要点是不要只做字符串匹配——用户转述论文时标题常被简写、翻译或改词,纯字符串会大量漏召回;但向量召回只负责”把可能的候选捞进来”,不负责判定。
- 打分与阈值:对每个候选关联算一个置信分,综合标识一致度、标题相似度、作者重叠、上下文提及。设两条线,不是单条:高过上限自动建关联,落在中间带进人工队列,低于下限直接丢弃。单一阈值必然在”错关联太多”和”漏关联太多”之间来回翻车。
- 冲突消解:同一篇论文对应多个候选讨论,或同一条讨论疑似指向两篇论文时,按优先级裁决——有 DOI/arXiv 硬标识的压过弱匹配,复现与引用压过泛讨论。规则拿不准的一律落到人工兜底,不允许系统”猜一个填上”就完事。
- 落库与回滚:关联写库,但必须可撤销,且撤销只解除关联、绝不删除原生的论文记录或社区内容。这一步是把”我们可能会连错”这件事在数据层承认下来;没有回滚的关联系统,第一次大规模错关联就只能靠删数据止血,删着删着把用户内容也删了。
四步里模型出现在第 1、2 步的召回与打分,出现在不了第 3 步的价值判断和第 4 步的撤销决策。这就是”模型不能自动完成全部对齐”的具体含义,不是客套话。
五、质量校验与更新:撤稿要能触发状态变更
对齐不是一次性跑完就归档的活度。质量校验要有三件东西:定期抽样人工复核,统计通过率并把它当成流水线健康度指标;给错关联留一个用户举报入口,这是最便宜的高质量负样本来源;把纠错反馈回流到第 2 步的阈值和第 3 步的优先级,让系统在被纠正的地方逐渐变准,而不是每次都靠人补。
更新比校验更容易被漏掉。论文会有新版本,也会被撤稿;一旦上游状态变化,关联必须能被触发重算。这要求关联表不是只有”存在/不存在”两态,而要带生效状态字段——生效、待复核、因撤稿失效等。撤稿发生时,关联到的讨论并不该被删,但”这条讨论指向一篇已被撤的论文”这件事要能被标记出来,前端才不至于继续把一篇撤稿当成有效成果来推荐。把状态做成字段而不是布尔位,是这类系统从 demo 到能长期维护的分水岭。
六、企业侧完全同构:字段与状态先于模型
这套东西对我们做企业数据的人价值更直接。把合同、图纸、工单、故障记录跨系统挂起来,遇到的难处和论文对齐一模一样:同一实体多套标识(合同号、项目编号、归档号)、关系有多种类型(引用、依赖、变更、作废)、冲突要靠规则加人工兜底、状态要能随上游变更而失效。我们在洹拓落地这类项目时的固定顺序是:先把标识字典、关系类型枚举和生效状态字段定义清楚并评审通过,再谈用什么召回模型。顺序反了,模型只会把一片混乱的字段更快地连成一张更乱的网。字段与状态先行,模型补召回与打分——这是同一件事在科研社区和在企业内网里的共同解法。