
一张脸能排出风险高低,却算不出个人结局:这类模型要先看验证
哈佛医学院、麻省总医院百瀚癌症研究所与丹娜法伯的团队在《柳叶刀·数字健康》发表了一项名为 FAHR-Face 的工作:先用超过 4000 万张无标签人脸照片(数据集 WebFace42M,覆盖 0—116 岁)训练一个面部基础模型,再在它上面分化出两条支路——FAHR-FaceAge 估算生物学年龄,FAHR-FaceSurvival 预测癌症患者的生存风险。通讯作者 Raymond Mak 是放射肿瘤学家。媒体标题大多写成”看脸断生死”那一类,但那不是这项工作的工程内容。
对做模型验证的人来说,这篇论文可复用的部分恰恰是它的克制:模型不用病历、不用影像,只用面部照片;论文把力气花在两件事上——证明这个信号在校正过已知临床变量之后仍然存在,以及主动检验化妆、整容、拍摄角度和光线会不会把它打掉。下面把这些拆开,同时说清这类模型不能用来做什么。
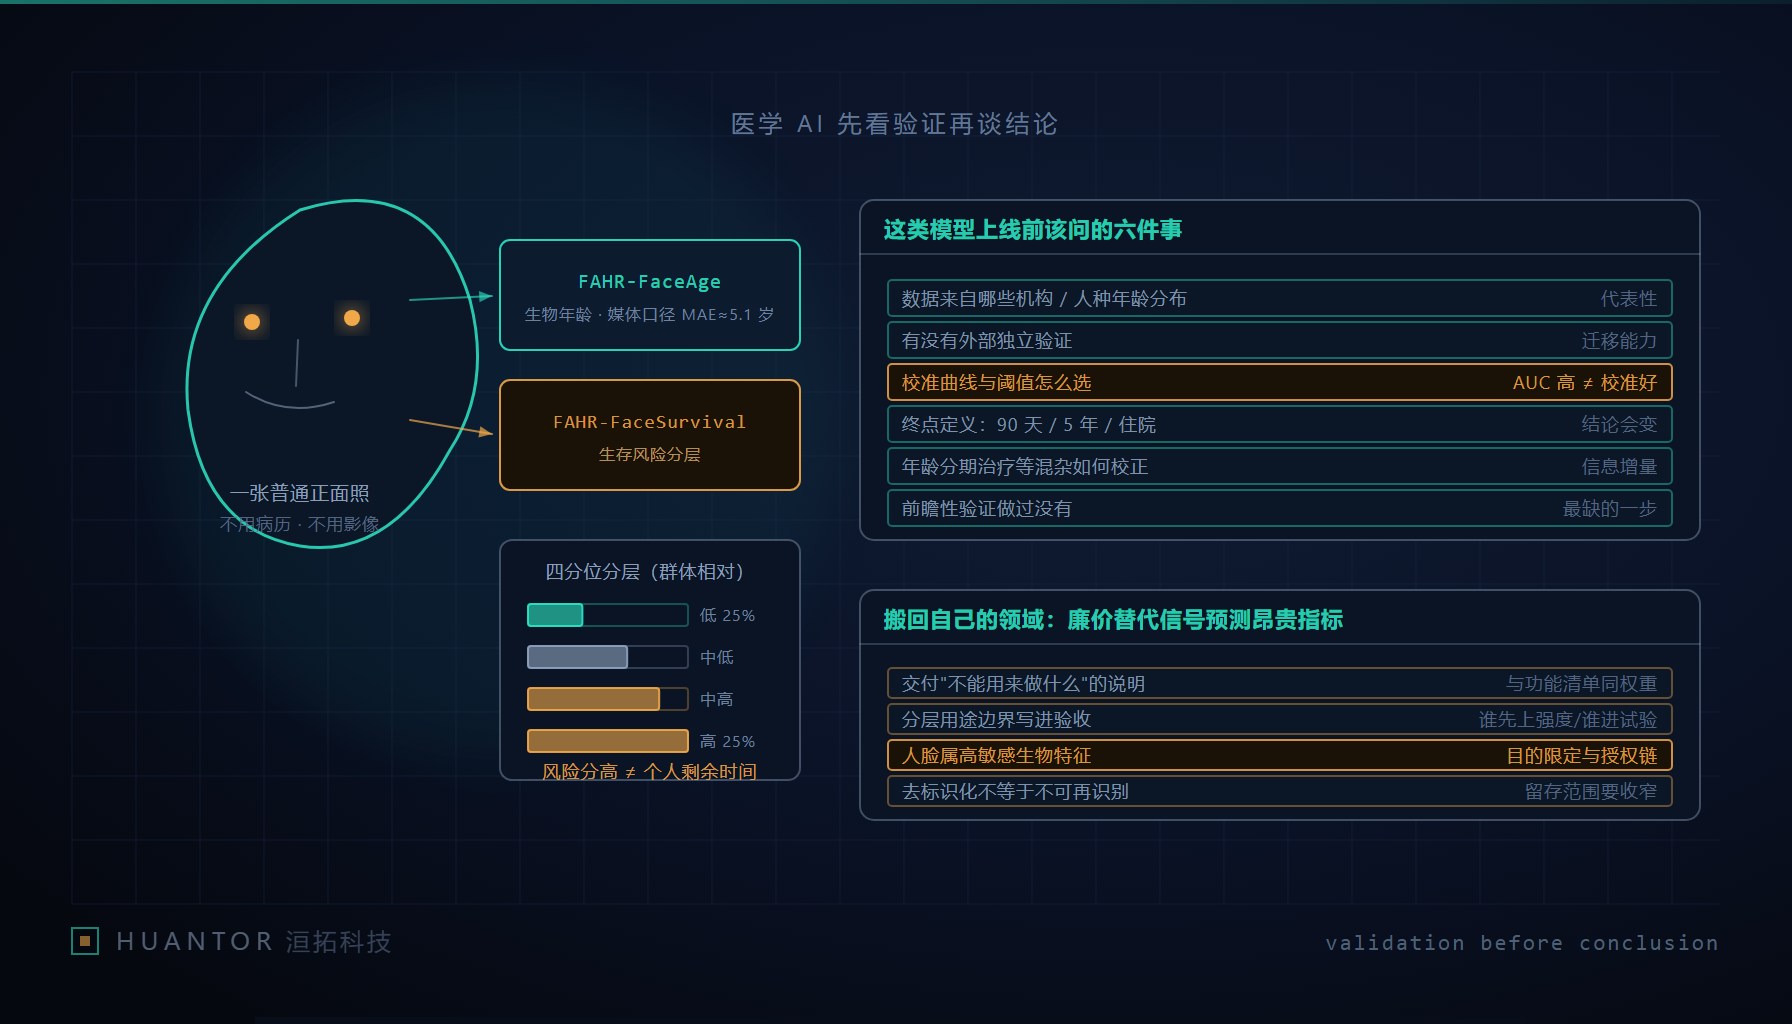
一、先把它翻译成”分层”,而不是”算出个人结局”
分层模型的输出是一个排名:给定一批人,它把其中一部分排在风险更高的一端。判别力指标(C 指数、AUC、风险比)衡量的是这个排名的整体区分能力,它有一个常被忽略的盲区——排序好不代表概率准。校准问的是另一件事:模型说这一档的人 90 天内死亡概率是五成,实际观测到的频率是否接近五成。一个模型完全可能判别力很高而校准很差,把”排名”读成”概率”就是从这一步开始的,而临床与业务上的事故几乎都发生在这一步。
研究给出的测试子集是 3820 人。风险分最高档 122 人里,52.5% 在拍照后 90 天内去世;最低档 975 人为 2.1%。这两个数放在一起至少能读出三件事。第一,档与档的分离是真的。第二,52.5% 同时意味着最高档里仍有接近一半的人没有在 90 天内去世,把它当作个体结局去告知是错的。第三,最低档 975 人里也有约二十人去世,”低风险”不等于”无风险”,任何把低档当豁免依据的用法都不成立。
还有一处细节值得注意:122 人与 975 人差了八倍,这不是把 3820 人均分成四档的结果,而是按风险分值切出来的组。分档规则本身是一个设计决定,它会改变所有”某一档里有多少比例的人如何如何”的表述。看到任何分档比例,第一个要问的是分界线画在哪里、由谁画的。
二、值得工程同行抄走的三点方法论
- 把标签稀缺问题挪到正确的阶段。 用 4000 万张没有任何健康标注的人脸先学”脸的一般表示”,再用约 3.4 万张患者照片去学一个特定终点。无标签数据的规模换来表示的通用性,昂贵的标签只出现在微调阶段。这正是很多团队在垂直领域缺的那一步:先把表示学厚,再把任务做窄,而不是拿几千张图从头训一个分类器。
- 用”校正后仍成立”来证明信息增量。 报告口径里,按四分位比较时最高风险组的死亡率是最低组的三倍以上,调整后风险比约为 3.23;5 年生存率前 25% 组为 78.1%,后 25% 组为 17.7%。这里的写法比结论更重要:一个新指标要主张的不是”我能预测”,而是”在年龄、分期、治疗方案这些已知变量已经进入模型之后,我仍然提供剩余信息”。任何不肯给校正集与校正后区间的增量声明,都不该被接受。
- 主动做干扰因素的稳健性测试。 化妆、整容、拍摄角度、光线——这四类都是采集现场就能改变输入分布的因素,研究者选择自己先攻击自己的模型,而不是等下游场景里被发现。这一条在工业项目里同样适用:把最可能的污染来源做成一组退化测试,与主指标一起交付。
三、口径会改写结论:六个数字各自在回答什么
先把术语对齐:脸龄减去证件年龄得到的差值被称作年龄差,报道里写作 FAD,它被视为健康耗损的信号——这也是”用估算误差几岁的模型还能谈健康”的原因:绝对脸龄不准不要紧,差值可能是有信息的。下面六个数各自在不同尺子上。
| 报告口径 | 它在回答什么 | 它不回答什么 |
|---|---|---|
| 平均绝对误差约 5.1 岁 | 脸龄估算按年计的平均误差 | 误差在不同年龄、肤色、拍摄条件下的分布 |
| 脸龄与证件年龄相关性 R≈0.16 | 两个量在人群层面的线性关联强度 | 单个人”看起来比实际大几岁”的可信度 |
| FAD≥5 岁者死亡风险上升(媒体口径) | 年龄差这一特征与终点的方向性关系 | 一个人多出的那几岁能推到什么置信度 |
| 90 天内死亡:52.5% 对 2.1% | 两个风险档在短终点上的分离程度 | 某个患者还剩多少时间 |
| 调整后 HR≈3.23 | 校正已知临床变量后剩余的相对风险 | 绝对风险与个体概率 |
| 5 年生存率 78.1% 对 17.7% | 长终点上分层依然成立 | 分期与治疗变化的贡献是否已被扣干净 |
上表前两行放在一起会让人觉得不舒服:平均误差 5.1 岁的估算,通常应当与证件年龄强相关;而 0.16 是很弱的关联。合理的读法是这两个数不是在同一个人群、同一个参照上算出来的,比如一个是受控集内的年龄估算精度,另一个是跨人群迁移后”脸龄对证件年龄”的相关。这不是要挑论文的错,而是拿到二手数字时必须做的第一道核对:口径不配对,任何外推都没有意义。媒体传播里最常被合并使用的,恰恰是这两类不同尺子上的数。
终点定义同样会改写结论。90 天内死亡、5 年生存、再住院、并发症,是四个不同的东西;对”拍照后 90 天”这个短终点而言,最难排除的混杂是拍摄时点本身——患者为什么在那一天被拍照,很可能就是病情出现变化的结果,于是”照片里的状态”与”即将到来的结局”之间存在反向因果。换成 5 年生存这个长终点,这类耦合会淡一些,但失访、治疗更换又进来了。同一个模型,换终点就换一套解释。
四、企业级验证该问的六个问题
- 训练与评估数据来自哪些机构?人种、肤色、年龄段、性别、病种构成是什么分布?迁移到我们自己的人群时,误差怎么变。
- 有没有外部独立验证——不是随机划分的内部测试集,而是不同机构、不同相机或手机、不同拍摄流程下采集的数据。
- 校准曲线长什么样,决策阈值定在哪里,阈值以下的阴性结论被允许说到什么程度。
- 终点是怎么定义的,短终点与长终点各自的混杂结构是什么,换终点后结论方向是否翻转。
- 混杂因素(年龄、分期、治疗方案、社会经济状态)在模型里怎么处理,调整集是否引入了”只有拿到这些数据的人才会被纳入”的选择偏倚。
- 有没有做过前瞻性验证,即从拍照那天起往前看、按预设流程收集结局,而不是在存档照片上回溯。
这六问里没有一问是关于模型结构的。这不是巧合:到了验证阶段,决定结论强度的从来是数据与口径,不是网络层数。
五、成本几乎为零的指标,为什么在合规上反而最脆
人脸大概是所有生物识别信息里最容易采集的一种:不需要接触、不需要被摄者配合、可以在人群里批量获取,甚至可以在对方不知情时完成。采集门槛越低,”目的限定”就越容易在链条里被悄悄突破。把同一张脸用于身份识别与用于健康推断是两个完全不同的目的,各自的授权基础也不同——采集时告知的用途是什么、健康推断的同意从哪里来、撤回之后已经训练过的模型怎么处理,这三问要在方案评审阶段就有答案,而不是在产品上线后补。
配套的硬约束还有几条:最小可用留存(到底需要保留原图,还是只保留特征向量);去标识化不等于匿名化,人脸本身是再识别能力最强的载体之一,一旦库被合并就可能反查到个人;用途审计(谁在什么时候用哪一批照片跑了什么模型)。
临床落地卡住的原因也和它类似,只是代价更直接。误分类的代价是不对称的:把高风险判成低风险,可能少做一次评估;把低风险判成高风险,会触发一连串过度检查与患者焦虑。阈值不该按总体准确率来定,而该按这两类代价来定。再往下是责任归属与预期用途声明——“辅助资源分配与随访强度排序”和”预测患者生存期”是两个不同的监管类别,一旦写进预期用途,就进入审批路径;而一句”仅供参考”又无法阻止它在实际流程里变成”不照做需要写理由”的压力。一个几乎免费的额外指标,在组织里最难的部分从来不是算力。
六、洹拓视角:模型交付物里必须有三份文档
这类研究对我们最直接的可迁移经验是那句方法论:任何用廉价替代信号去预测昂贵指标的模型,都要连同”它不能用来做什么”一起交付。 拍张照片估健康状态、看界面行为估员工能力、听声音估设备状态,本质都是同一件事——信号便宜、标签昂贵、结论容易被过度解读。
在洹拓的交付模板里,这类模型验收要附三份文档:
- 分层用途边界:模型输出被允许用于哪些决策(排序、资源倾斜、复核优先级),被禁止用于哪些(个体预后结论、定价、准入与解聘),分档线如何确定、由谁签字。
- 校准证据:在哪些人群、哪些采集条件下测过,校准曲线与误差区间,外部验证集的表现,以及明确列出”分布一旦改变就要重新验证”的触发条件。
- 拒用场景:已知的失效输入(设备与光照差异、整容与化妆、肤色与年龄分布外、拍摄时点与事件耦合)、被拒绝样本的处理方式、缺失数据不允许被填补成结论。
标题里的”AI 看脸断生死”很好卖,论文里的分层、校正与稳健性测试不好读。做模型验证的人能带走的东西只有后者。