
服务端生成 Office 文档:一个零依赖库的四个场景与它免掉的坑
一、Linux 容器里生成 Office 为什么反复翻车
服务端出个 Excel,听起来是二十行代码的事,实际是我们遇到过最多返工的一类交付。翻车的原因基本落在三处:
- 可移植性。 桌面 Office 的自动化接口本质上是把一个桌面应用当服务端进程来调用,Linux 容器里没有这个进程。即使环境凑出来了,它也不是为并发设计的:多个请求同时驱动同一个实例,行为不可预期;无桌面会话的环境下,剪贴板、默认打印机、用户配置目录这些隐式依赖都会变成故障源,而报出来的错通常和真实原因隔了好几层。
- 许可。 桌面授权条款是否覆盖”在服务器上无人值守地为第三方生成文档”,这个问题在很多项目里从来没被正式回答过。评审时我们要求把候选库的许可条款逐字读一遍并留档,不接受”业界都在这么用”这类二手结论:依赖库在新版本里改许可模式的情况并不罕见,一次常规升级就可能把合规问题带进生产。
- 内存放大。 OOXML 是 ZIP 里面套 XML,一个几百 KB 的 xlsx 解压后的文档对象模型可以膨胀很多倍。基于对象模型全量加载的写法在小文件上看不出问题,明细上万行就 OOM。部分库提供流式的前向写入,但代价是写完不能回改、样式能力受限,等于把 API 的一半功能换成内存安全。
原文这个库(Wisdom.Office,NuGet 包版本 1.0.0,博客园文章发布于 2026 年 10 月)给出的答案是回到第一性原理:底层格式自己实现。作者的表述是「纯 C# 自研,不依赖任何第三方 NuGet 组件,也不依赖 Microsoft Office 或 WPS」,自研的部分包括 ZIP、XML、OLE2、PDF、OOXML、BIFF8。目标框架覆盖 net461、netstandard2.0 以及 net7.0 到 net10.0——出现 net461 说明作者把老 .NET Framework 的存量系统算进了考虑范围,这在政企客户的现场环境里很实际:能不能在客户现有的那套运行时上跑,往往直接决定一个方案可不可选。
二、零依赖具体免掉了什么,又留下了什么
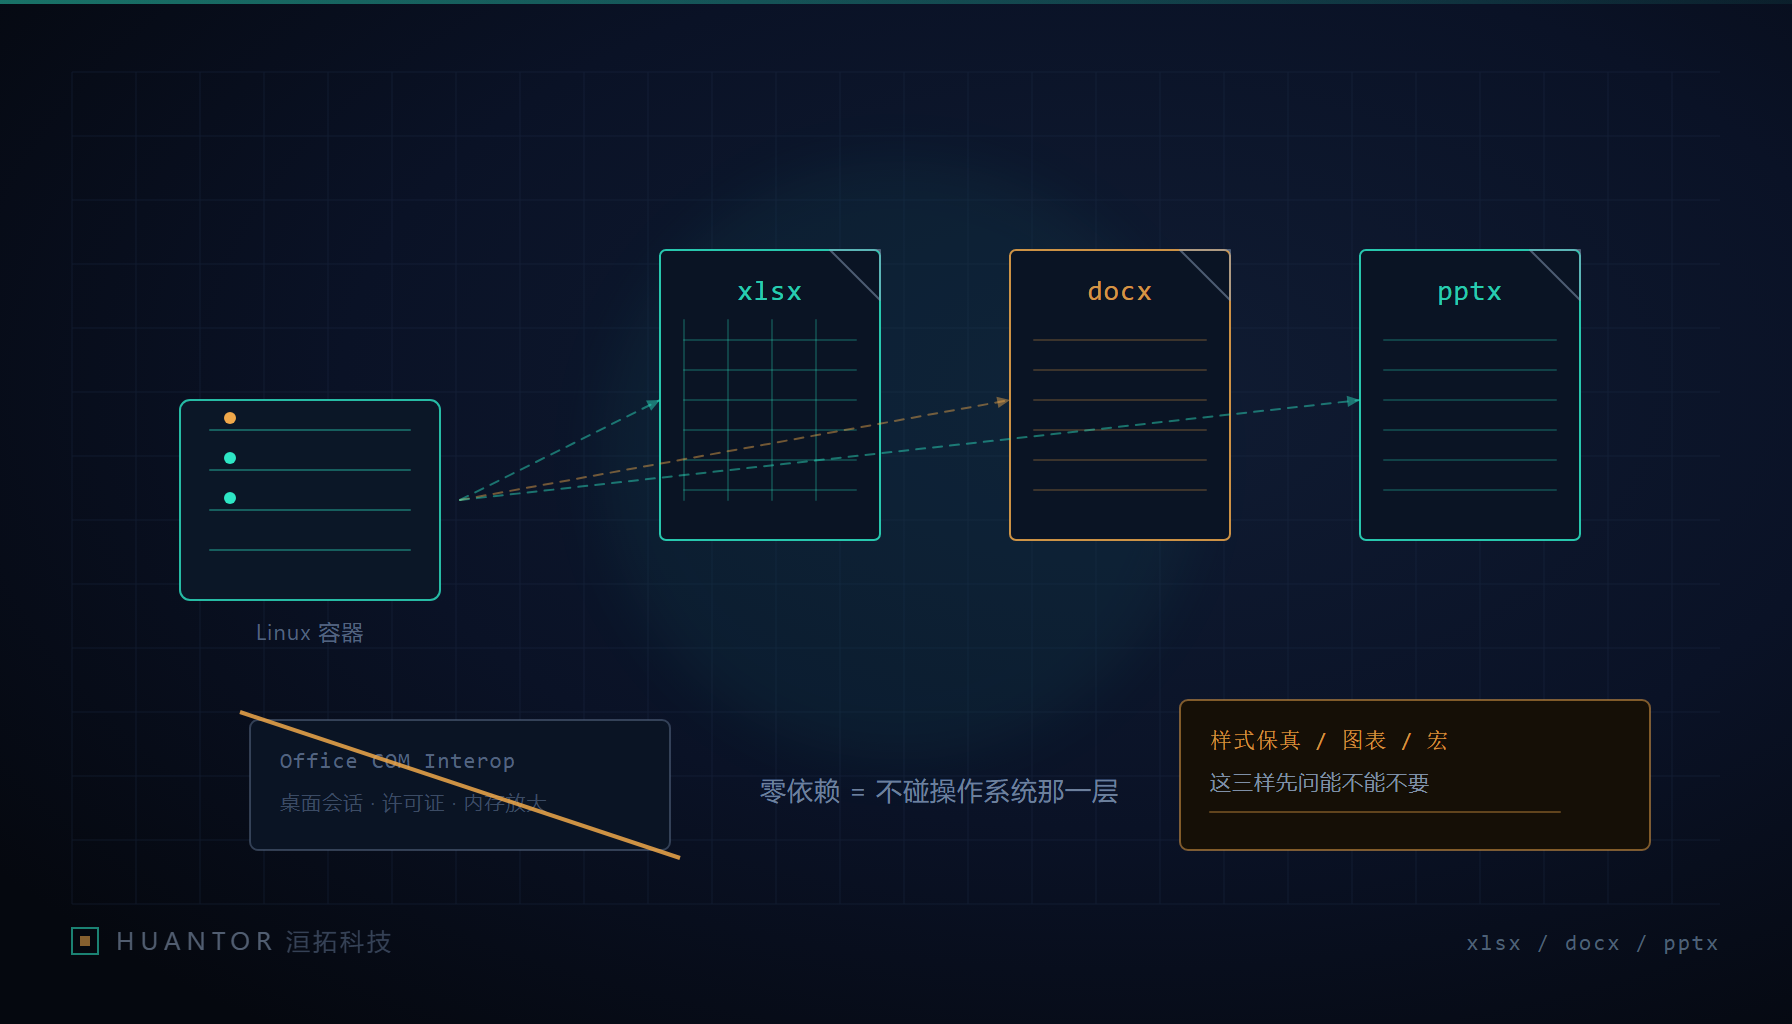
免掉的是三件事:传递依赖冲突、对桌面 Office 的运行时依赖、服务端许可的不确定性。因为依赖树只有自己,审计一次就基本不用再动。
留下的是:功能面被显式收窄。原文里能确认的支持边界是这样的——DOCX、XLSX、PDF 可读写;DOC、XLS 只读;Word 和 PDF 里没有图表;不做加密;不做 OCR;不支持 CFF 轮廓字体;不做 Word/PDF 转 Excel。
这份”不做”的清单比”能做”的部分信息量更大。图表和加密恰好是客户最常在 Office 交付里追加的两个要求。作者愿意把 OOXML 和 BIFF8 自己写出来,却没去碰图表模型和加密容器,因为这两块的工作量不在同一个量级上:图表背后是一个排版引擎,加密背后是一整套 OOXML 的加密封装流程。这是任何自研格式库都会撞到的现实——零依赖不是”更强”,是把复杂度换成了覆盖面。
由此我们的定位判断很明确:这类库适合当输出通道,不适合当文档处理平台。凡是要把客户上传的复杂 docx 原样改几个字再传回去的场景,仍然不该走这条路。样式保真的难点从来不在能不能解析,而在于解析之后你对整棵样式继承树的理解是否和桌面软件一致。
三、原文的四个场景,对应四类交付需求
- 报表导出。 用
Report这套 DSL 把数据、样式、表格定义一次,AddTable塞表格,Export()出 PDF/DOCX/XLSX。一份定义三种输出,对交付方吸引力很大:客户经常是同一份报表既要可编辑的 Excel,又要能归档盖章的 PDF。要注意的是 DSL 的表达力上限——它覆盖的永远是三种格式的交集,只有一种格式才有的能力(Word 的分栏、Excel 的条件格式)一旦用上,另外两头就得降级或报错。 - 文档互转。
OfficeFile.Load()做格式嗅探,OfficeConverter负责转换,表格到 PDF 走WorkbookToPdf,带WorkbookLayoutOptions这类排版参数。原文的转换能力是有方向的:表格转 PDF 支持,Word/PDF 转 Excel 明确不做。 - 模板填空。
DocxTemplate.Fill()和XlsxTemplate.Fill(),占位符语法是{{key}}。这是我们实际项目里用得最多的一类。它的坑不在填充逻辑,在模板本身:Word 会因为拼写检查或字体切换把一句{{customer_name}}拆进多个 run,简单的字符串替换于是找不到占位符。原文模型里有FieldRun这个概念,说明作者在 run 一级做了处理,具体实现我们没读到,只记一条规矩:模板上线前先用 Word 手工敲一遍,保存后检查占位符是否还完整待在同一个 run 里。 - 通用文档模型。 直接操作
OfficeDocument(按 Section 和 Block 组织)和OfficeWorkbook,绕过 DSL 做复杂排版。
四个场景串起来看,是按抽象层级递减排的:报表 DSL 最省话,互转最省事,模板填空最贴近业务,通用文档模型最接近直接写 XML。选哪一层取决于排版责任的归属——排版规则在开发手里就用 DSL,排版规则在客户手里就用模板填空。这条分界线在我们的方案评审里是必答题。
四、四类交付各自该走哪条路
- 模板填空:文件由业务方维护,程序只填值。走占位符方案,配一套模板预检工具,校验占位符完整性、run 拆分、表格行是否允许增长。模板必须纳入版本管理,这是实际项目里最容易漏的一项。
- 批量导出:文件由程序生成,量大。走”按分组切片、多个文件分别生成再打包”的结构,单个文件的行数设上限。核心原则是不要用一个对象模型装下全部数据——任何”先全查出来再写文件”的接口,都在等着被一次全量导出打挂。
- 格式回传校验:客户上传、我方校验或轻量改写。走”只解析不重写”:把 xlsx 当成 ZIP 直接读内部 XML 做结构校验(工作表名、必填列、数据类型、是否存在公式),需要落回业务时只生成新文件,不改客户原件。原文里 DOC/XLS 是只读定位,正好符合这个用法。
- 在线预览:要的是渲染一致性而不是可编辑性。走”服务端转 PDF、前端只做翻页”。直接在前端解析 docx 我们不推荐:浏览器端还原样式继承树与桌面软件打开效果的差异,会全部转成客户投诉。表格类预览可以把排版参数集中在服务端(对应
WorkbookLayoutOptions这一层),前端只负责翻页和缓存。
五、需求 / 常见做法 / 翻车点 / 我们的选择
| 需求 | 常见做法 | 翻车点 | 我们的选择 |
|---|---|---|---|
| 客户要一份可编辑的合同 | 驱动桌面 Office 生成 | 容器里没有该进程;并发不可控;许可条款没覆盖无人值守场景 | docx 模板填空,输出即交付物,不碰渲染 |
| 上万行明细的 Excel | 全量加载对象模型后一次写出 | 内存放大导致 OOM;GC 抖动拖垮整个接口 | 按分组切多个文件再打包,单文件行数设上限 |
| 同一份报表要两个格式 | 两套代码分别生成 | 口径漂移,两个版本的数字对不上 | 一份定义两种输出,格式交集之外的差异在评审时列清单确认 |
| 校验上传的 xlsx | 读进对象模型再校验 | 客户端产生的格式五花八门,解析器直接抛异常 | 按 ZIP 读内部 XML 做结构校验,只读不改原件 |
| 报表里要图表 | 指望库自动画原生图表 | 图表模型是最难自研的部分,轻量库通常不支持 | 服务端出图后以图片嵌入,不追求原生 chart 对象 |
| 文件里要带宏 | 保留原文件的宏一起下发 | 安全审计一般直接否决;带宏文件在邮件网关常被拦 | 一律拒绝,逻辑移到服务端,宏不作为交付通道 |
| PDF 要可检索、能加盖电子章 | 把页面当图片拼成 PDF | 无法全文检索,电子签章无从附着 | 保留文本层;签章走独立的可信流程,不由文档库兼职 |
六、三条落地约束
- 生成侧永远不要”打开输入文件再另存为输出”。 读是一份模型,写是另一份模型,中间只走自己的数据结构。这一条能挡住绝大多数”客户上传的文件把服务打崩”的事故。
- 把”我们不支持什么”写进交付文档。 原文那份负向清单(不做加密、不做 OCR、DOC/XLS 只读、Word 和 PDF 无图表)之所以有价值,正因为它写得明确。我们给客户的功能表里,负向清单放在正向清单前面。
- 许可条款读原文并存档,依赖树逐层看。 “零依赖”最大的好处不是省磁盘,是让这两个合规动作从”每次升级都要重做”变成”做一次就基本不用再动”。
最后补一句判断:自研格式解析这条路,只有当团队真的打算长期做文档类产品时才成立,一次交付项目照抄它并不划算——1.0.0 这个版本号本身就提示覆盖面的扩大还需要时间。但对报表这类年年都要出、格式年年都要改的需求,一个依赖树只有自己、目标框架能落到 net461 的输出通道,确实比每次重做一遍许可与依赖审计省事。我们的用法是把它放在”输出通道”这个位置上试用,而不是放在”文档平台”的位置上。