
蒸馏要学的是动作不是字:Agent 化模型的目标函数换掉了什么
一、换掉目标函数,改动最大的地方在数据侧
据公开报道,清华的一个研究团队提出过一项叫 ActionOPD 的思路,主张把蒸馏的目标从逐 token 预测换成决策本身,出发点是语言模型正越来越多地以 Agent 形式部署:它们与用户交流、维护交互状态、并通过外部工具执行动作。我们不掌握这项工作的方法细节与实验数据,也不打算判断它是否优于既有蒸馏路线。本篇只把这一句话当需求来读:当被蒸馏对象的行为是一串交互轨迹而不是一段文本,损失该打在哪一层,以及为了让这件事成立,训练流水线要先改什么。
改动的重心不在损失函数那一行代码,在数据。文本蒸馏的数据单元是”输入加输出”,师生两边只要共享词表就能对齐;轨迹蒸馏的数据单元是”一段环境交互”,它包含工具的真实返回、被拒的动作、重试、时间戳。如果这些没有被完整记录,学生的目标就无法定义,因为没有任何东西可以被复现。换句话说,这类方法能不能落地,先取决于你原来的日志格式够不够诚实。
二、三类蒸馏目标:打在哪一层、什么时候够用、会怎么失真
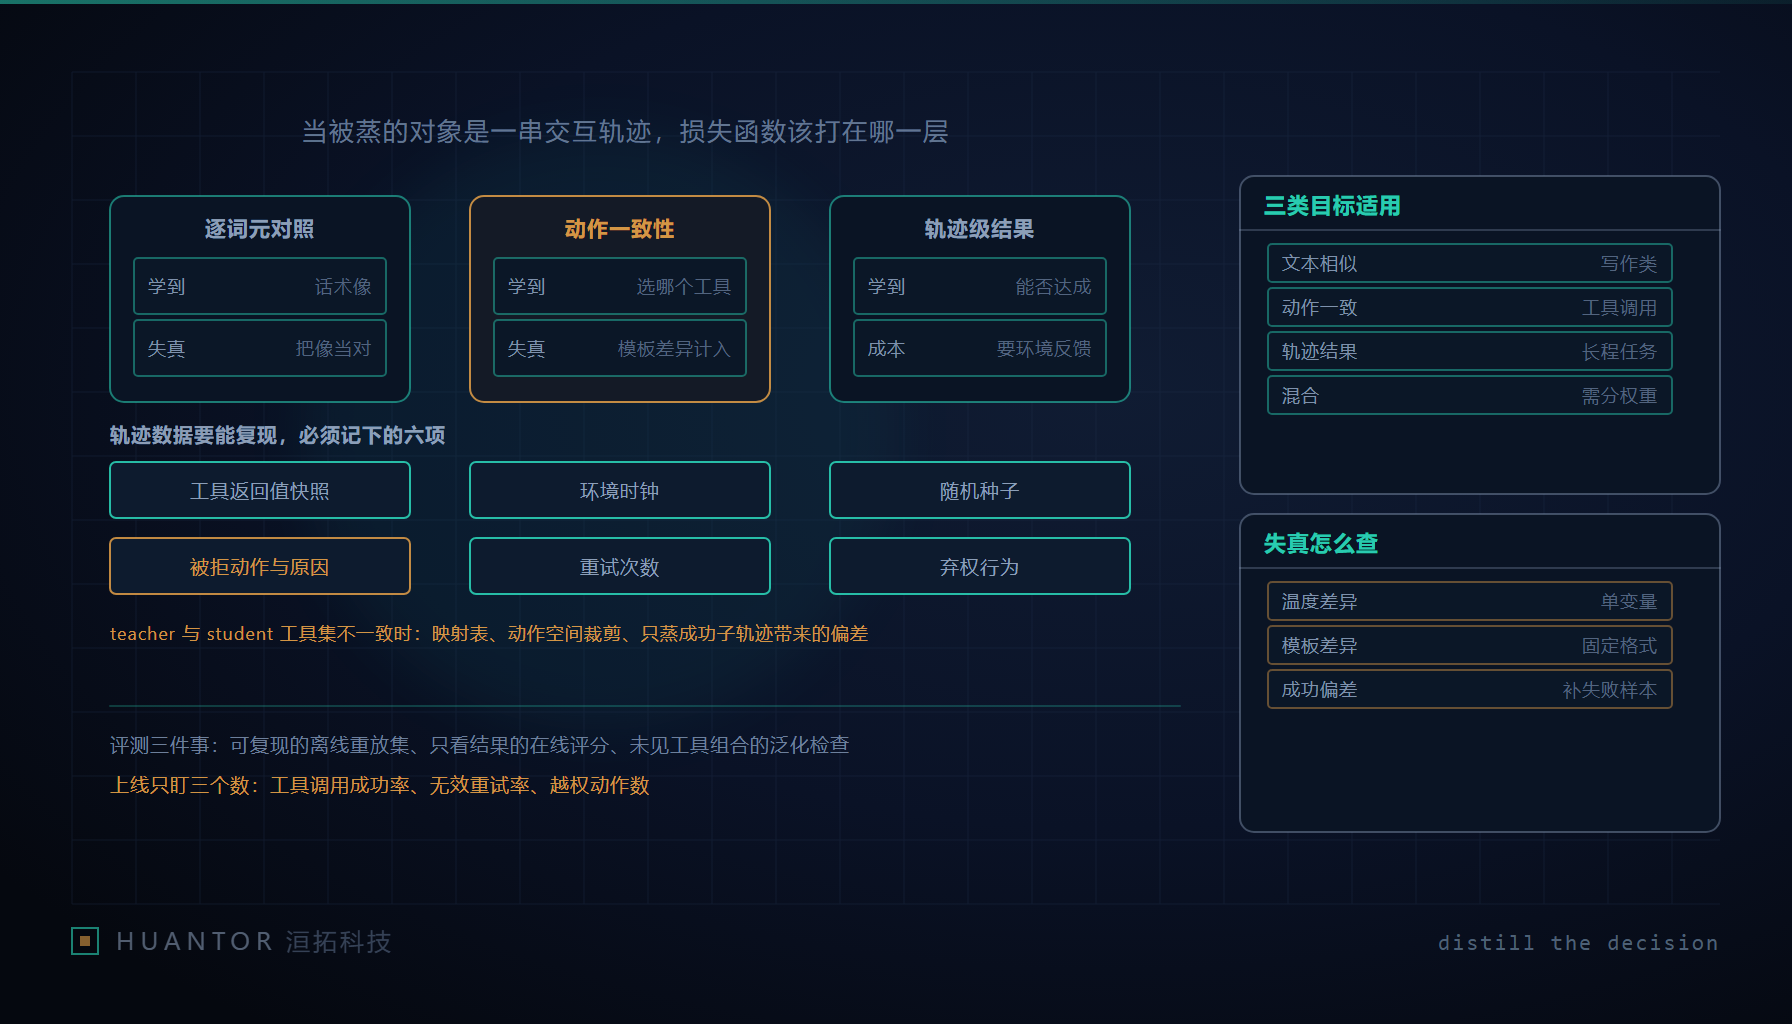
| 目标层 | 损失打在哪里 | 适用场景 | 典型失真方式 |
|---|---|---|---|
| 输出文本的逐 token 交叉熵 | 词表概率分布,逐位置对齐 teacher 的分布 | 单轮问答、风格与格式迁移、摘要这类”输出就是一段话”的任务 | 把”话术像”当成”决策对”;采样温度与模板差异被当成要拟合的错误 |
| 动作与工具选择的分类一致性 | 离散动作空间上的选择概率,含参数槽位 | 工具集合稳定、动作可枚举的调用型任务 | 只对齐”选哪个工具”,丢掉参数与终止时机;师生动作空间不同就没法直接比 |
| 含环境反馈的轨迹级结果 | 整条轨迹的最终结果与代价,包括步数、失败与越权 | 长程任务、需要重试和状态维护的部署 | 反馈稀疏,难归因到具体某一步;结果好可能只是环境宽容 |
三档不是替代关系。同一个 Agent 项目里三档都会用到:格式与语气靠第一档,工具选择靠第二档,什么时候该停、失败后怎么处理靠第三档。真正需要重新审视的是团队习惯上把哪一档当默认项。逐 token 交叉熵之所以成为默认,是因为它的实现最省事、评测最标准化,不是因为它最贴近我们要的行为。
三、把 token 级损失直接用在 Agent 上的两个失真
第一个失真最隐蔽:模型学得非常好,学的是 teacher 的表达而不是 teacher 的判断。工具调用的正确与否,很大程度上体现在”这一步该不该调、参数取什么、拿到报错后是重试还是换路径”,而 token 级损失对这些没有任何梯度压力,因为决策对了但话说得糙、或者话说得漂亮但决策错,在词表概率上的差异远小于风格差异。用文本相似度做验收的团队,会稳定地蒸出一个”很像但不会办事”的学生。
第二个失真来自格式层的差异被算进了损失。teacher 与 student 的采样温度不同、工具调用的模板不同、系统提示词的措辞不同,这些都会让同一条轨迹上的概率分布对不齐,而损失函数无法区分”这里分歧是决策分歧”还是”这里分歧只是模板换了个括号”。工程上的处理办法是把这些差异从损失里剔出去:对齐只在动作层做,文本层只用格式约束而不做概率拟合。
四、轨迹要能被复现,记录项比损失函数更早决定成败
如果学生要学的是决策,那么一条轨迹必须能被原样重放。下面六项记录,缺任何一项,重放就退化成”读一遍日志”。
| 记录项 | 为什么必需 | 缺失后的后果 |
|---|---|---|
| 工具返回值快照 | 学生的目标不仅是当时调了哪个工具,还包括读到返回之后的下一步选择 | 无法重放,轨迹只剩文本,回到第一档损失 |
| 环境时钟与外部状态版本 | 同一动作在不同时刻的返回结果本就不同 | 复现差异被误读成模型能力差异 |
| 随机种子与解码参数 | 要把”采样造成的不同”和”决策造成的不同”分开 | 温度与采样差异被当成错误去拟合 |
| 被拒动作与拒绝原因 | 弃权、校验失败、权限拦截本身是一类要学的行为 | 学生只见过成功路径,遇到拦截就盲目重试 |
| 重试次数与每次的差异 | 判断成本有没有被学进去 | 蒸出的模型完整继承无效重试的习惯 |
| 工具描述与模板的版本标识 | 工具说明文本一变,动作语义就变 | 跨版本样本互相矛盾,训练越久越糊 |
这六项在大多数现成的 Agent 框架里是不齐的。补齐的工作量通常比想象中大,因为它要求返回值落库时带上下文标识、要求外部调用可幂等重放、要求权限拦截也写成事件而不是异常。这三件事任何一件偷懒,轨迹就不可复现,后面所有的目标函数改造都是空谈。
五、师生工具集不一致与状态维护,是两处必须提前定的决策
工具集不一致时的三条路各有代价。做映射表最直接,把 teacher 的工具名与参数映射到 student 的动作空间,代价是映射不到的动作必须显式丢弃并记录丢弃量,否则训练集与推理集行为不一致。做动作空间裁剪是更保守的选择,只保留两边都有的工具来生成轨迹,代价是放弃了一批高价值长任务。只蒸成功子轨迹最省事,也最容易自欺:学生没见过失败与恢复,一旦上线遇到报错,行为完全超出训练分布,偏差会集中在这里暴露。
状态维护的蒸法要单独设计,不能靠”把整段上下文喂进去”混过去。长上下文的压缩策略要一致:teacher 用什么规则摘要历史,student 就要在同一规则下看到同样的摘要,否则两边对齐的不是同一个状态。跨轮记忆的对齐同理,哪些字段进记忆、什么时候写、写入的是原始内容还是判定结论,都要版本化。第三件容易被漏掉的是弃权行为要不要一起蒸:teacher 在不确定时选择追问或拒答,student 若只学”总是给答案”,看起来指标更好,实际是把最贵的一类错误留到了线上。
六、评测三件事与上线后要盯的三项指标
评测设计要跟着目标层一起改,否则改完损失函数仍然在用文本相似度验收。三件事缺一不可。
- 离线重放:一组可复现的任务集,输入固定、工具返回值可用录制结果替代,让同一条轨迹能被不同模型各跑一遍。做不到这一点的评测,比较的其实是环境而不是模型。
- 在线只看结果:评分口径以任务是否完成、代价是多少为准,不给输出文本打相似度分。允许把文本质量单独列成一维,但不许它参与决策能力的评价。
- 泛化检查:把 student 放到 teacher 轨迹里没出现过的工具组合上,看它会不会重新拼出可行流程。这一项是唯一能区分”学会了决策”和”背下了流程”的检查。
上线后盯三项指标:工具调用成功率、无效重试率、越权动作数。三项里最重要的是无效重试率,它是轨迹级代价最直接的代理,也是第一档损失最容易偷偷教给学生的东西。这三项不需要和任何人比较,需要的是版本之间的纵向对照,因此它们必须从第一次部署就开始记录。这类改造在洹拓自己维护的模型服务上属于常规工程量,我们的判断标准只有一条:任何一次目标层更换,先问轨迹能不能原样重放,能重放再谈方法优劣。