
上门的不再是浏览器:识别与接待 AI 智能体的四张服务端清单
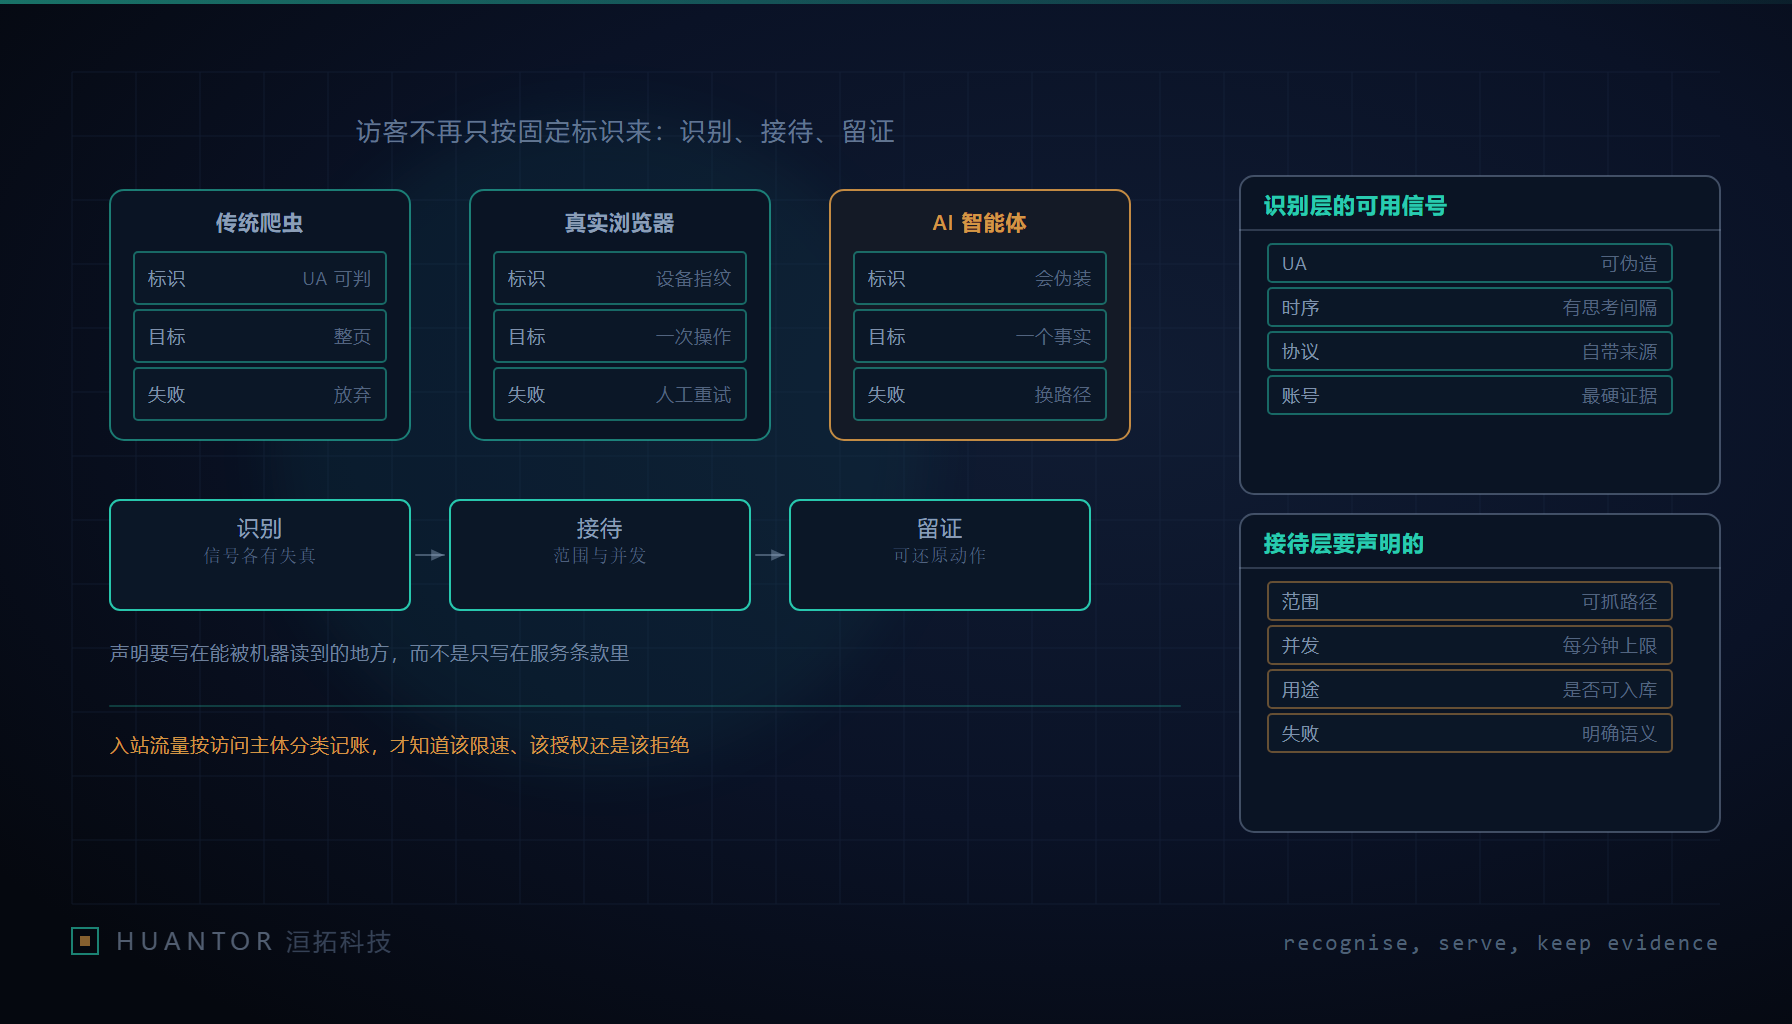
一、先承认一件事:访客的画像变了
一个调查团队在页面里留下一个邮箱地址,随后开始收到自动投递的来信。写信的不是人,是替人跑任务的智能体,内容围绕同一个问题:某个地点的哪个入口人最多。为拿到这个数,智能体在几个站点之间反复试探,一条路走不通就换一条,来回折腾了不止一天。
这件事对我们做官网、做业务系统的人有一个直接含义:入站流量里开始出现一类主体,它既不按固定 UA 跑的脚本那样机械,也不是坐在屏幕前的人。它会读页面上的文字说明,会自己拼 URL,会因为一个报错换一种做法。拿老的爬虫治理思路对付它,就像拿门轴上的锁去管一个会自己找钥匙的人。
先把两类访客放在一起看清楚差别。
| 维度 | 传统爬虫 | 智能体访客 |
|---|---|---|
| 标识 | UA 固定、由代码写死,容易批量伪造,也容易被运营方当成唯一判据 | UA 常常直接复用真实浏览器或宿主运行时,伪造与否不是重点,重点是它未必对自己的能力有准确描述 |
| 访问目标 | 整页文本,抓回去做索引或镜像 | 结构化事实:一个数字、一句话、一个接口字段,拿回去喂给推理链 |
| 频率形态 | 匀速、按队列推进,间隔方差小 | 带思考间隔:读一段停很久再请求下一段,间隔方差极大,像人又不像人 |
| 失败行为 | 记一条错误、跳过或整轮放弃 | 换路径:改查询参数、试接口、找页面里的说明、甚至给对方留邮件 |
| 可核验性 | 靠 IP 与 UA 猜,事后难以归责 | 若绑定了账户或密钥,可以追责;匿名访问时同样只能猜 |
差别最关键在最后一行。传统爬虫治理的默认动作是”封 IP”,前提是流量同质、封掉不心疼。智能体访客一旦带着账户来,封 IP 就变成了封掉一个签了协议的调用方,代价完全不同;而它不带账户来的时候,封 IP 又封不准,因为它会换出口。所以服务端要备三段东西:识别、接待、留证。三段各自有字段和判据,缺一段就退化成拍脑袋。
二、识别层:可用信号与它们各自的失真
可用于识别的信号就那么几类,每一类都有确定的失效方式,写规则时必须把失效方式一起写进注释。
UA 与协议头。这是成本最低的一层,也最不可信。宿主运行时会把 UA 伪装成完整浏览器;反过来,大量正规自动化(监控探测、CI 里的链接检查、搜索引擎预览)用的 UA 看起来”不像浏览器”。UA 适合当分流依据,不适合当判定依据。
JS 执行能力与指纹一致性。在页面里放一段必须执行脚本才能补全的隐藏字段,能过滤掉完全不会执行 JS 的抓取。代价是它同样会挡住无障碍工具、翻译代理和某些隐私浏览器。至于给访客植入难以删除的追踪标识,我们不采用:识别应该建立在自有信号和对方自愿声明之上,而不是靠藏。
行为时序。人浏览有滚动、鼠标轨迹、焦点切换,请求节奏跟阅读进度相关;智能体的停顿集中在”读之后、请求之前”,请求内部又异常整齐。时序特征能做评分,不能做拦截,因为混合流量里真人代跑脚本的情形无法区分。
账户与密钥绑定。这是唯一能把置信度顶上去的信号。愿意登录再让智能体操作的访问,天然可归责。工程上要做的不是”逼所有人登录”,而是把匿名访问与认证访问的行为差异记成两条不同的策略线,认证线给更宽的配额和更细的审计。
来源声明。一部分智能体框架与工具协议会在请求里带上自己是谁、代表哪个宿主、执行的是哪个工具;网站侧也可以像 robots 协议那样,把”允许自动化访问到什么程度”写成机器可读的文本。这类自带声明不可信但极有用:对方说了什么,与你观察到的行为是否一致,本身就是一条强特征。
识别层的输出不能是一个布尔值。它至少要有三个字段:判定结果、置信度、依据了哪几条信号。事后有人问”为什么这次访问被拒”,你要能指着这三个字段回答。
三、接待层:把允许与不允许写成机器读得懂的声明
识别出来之后,第二件事是接待。绝大多数站点对自动访问的真实态度是”没态度”——没写过规则,只能靠默认响应去猜。智能体最怕的不是限制,是限制没写下来,因为它会把沉默理解成许可,然后一头撞在真正的墙上。
接待层要显式声明的东西,可以逐条落到具体位置:
- 可访问范围:哪些路径允许自动抓取,哪些只对人类会话开放,哪些必须认证。写在机器可读的声明文件里,同时给一份人类可读的说明页,两者由同一份配置生成,避免各说一套。
- 速率与并发:给一个明确的数字上限和并发上限,并在响应头里回显剩余额度。上限值按自己的负载能力核,不套别人的数。
- 允许用途:允许索引、允许摘要、允许把内容存进对方库、允许用于训练,是四件不同的事,要分开写,不要用”按合理方式使用”这种没法验证的措辞。
- 是否允许入库与再分发:明确写”抓走的内容可否长期保存、可否转喂给其他模型”,并给出联系与授权的入口。
- 错误语义:区分”暂时太忙”(带恢复时间提示的 429)、”这条规则不允许”(403,并说明依据哪条声明)、”这个资源不存在或已下线”(404 与 410)。把三类混成一个 500,智能体会当成临时故障无限重试。
这五条的共同点是要有落点。没有落点的政策只是立场,写了却机器读不到,等于没写。
四、诱饵与投毒:一件双面工具
在页面里埋只有自动化访问才会触碰的东西——藏在注释里的 URL、不显示在渲染结果中的邮箱、对不同来源返回不同水印字段的内容——是发现自动访问最直接的办法。上面那封”深夜来信”,本身就是诱饵起了作用。
但这条线要分两面看。有效的一面:诱饵不会误报,命中即证明有非人工的访问,且带水印的字段还能反查出数据是从哪一次抓取流出去的。危险的一面同样清楚:一旦把诱饵做成”给爬虫返回假数据”的投毒,你就在替对方的推理链制造错误事实,而这些错误事实可能反过来污染你自己的检索结果与对外口径;更麻烦的是,投毒内容一旦被辅助技术或翻译代理取到,受害的是完全无辜的用户。
我们的取舍写进策略里:诱饵只用于识别与取证,不用于给用户喂错内容。命中后的动作分四档——只记录、限速、要求认证、拒绝服务——并且必须能人工撤销,撤销要留原因。同时给三类例外通道留出登记入口:搜索与预览的正规验证渠道、学术研究者、签了协议的合作伙伴。例外不是白名单一次配置永久生效,要有期限和复核人。
五、留证层:还原到”读了哪一段”
留证要能回答一个问题:哪个智能体、在什么时候、读了哪一段、拿去做了什么。前三个服务端完全能答,第四个只能靠对方声明和合同约束。日志字段因此要按这个目标来配:
| 字段 | 作用 |
|---|---|
| 服务端接收时间与请求 ID | 时钟统一,避免拿对方时间戳对齐 |
| 主体标识:账户 ID 或密钥 ID、宿主与工具会话 ID | 把多次请求拼成一次任务 |
| 访问对象:路径、内容版本、返回的字段子集或字节范围 | 回答”读了哪一段” |
| 命中的规则与响应码 | 事后能解释为什么放行或拒绝 |
| 对方声明的用途与来源标识 | 与行为做交叉验证 |
| 识别层输出:判定、置信度、依据信号 | 支撑申诉与规则迭代 |
日志本身要治理。保留期与用途写进对外承诺,不要只存在于运维脑子里;查询权限按角色分,能查全量的人越少越好,且查询行为也要进审计;导出要有次数和水印。这些做法我们在给客户交付时会当作验收项而不是可选项——洹拓经手的几个对外系统里,最后真正扯皮的往往不是”有没有日志”,而是”日志谁能看、看多久、能不能证明没被改过”。
六、四张清单与验收判据
把上面四段压成可交付的东西,就是标题里那四张清单:对照表、识别清单、接待清单、留证清单。每张都要有验收判据,否则它会停在文档里。
| 清单 | 必备内容 | 验收判据 |
|---|---|---|
| 对照表 | 标识、目标、频率、失败行为、可核验性五个维度的两栏描述 | 任一维度能回答”这条规则改了对哪一类访客有影响” |
| 识别 | 每类信号的用途、失效方式、参与判定的权重 | 抽十条被拒访问,人工复核误判率;每条判定能列出依据信号 |
| 接待 | 范围、速率、用途、入库、错误语义五类声明及其落点 | 用一个不带账户的智能体跑一遍典型任务,全程不必猜测规则;三类错误码可分辨 |
| 留证 | 上表六个字段、保留期、查询权限与查询审计 | 随机指一条访问,能在几分钟内还原主体、时间、读取范围与响应结果 |
判据里最硬的是最后一条。做不到,就说明日志只是”存了”而不是”能用”。这套东西不解决”要不要允许智能体访问”的问题——那是业务和法务的事——它只保证一件事:当有人来问”那天到底是谁读了我们什么数据”的时候,你有答案,而不是有一句”我们看了一下没发现异常”。对做交付的人来说,前者是能签字的东西,后者不是。