
树链剖分到底在解决什么:把树上的路径切成线段树能吃的区间
一、问题的根源:树不给”区间”
线段树强在区间:一段连续下标上的修改与查询,都是 O(log n)。但树不是序列——节点编号是输入给的,任意一棵子树、任意一条路径在编号上都可能散得七零八落。于是”把树压成一个序列”是第一需求,最自然的做法是 DFS 序:按访问顺序给每个节点分配 dfn 标号。
DFS 序有一个好东西:子树天然是连续区间。节点 u 的子树就是 [dfn[u], dfn[u] + siz[u] - 1]。所以”修改子树””查询子树和”这类操作,配上线段树立刻解决。
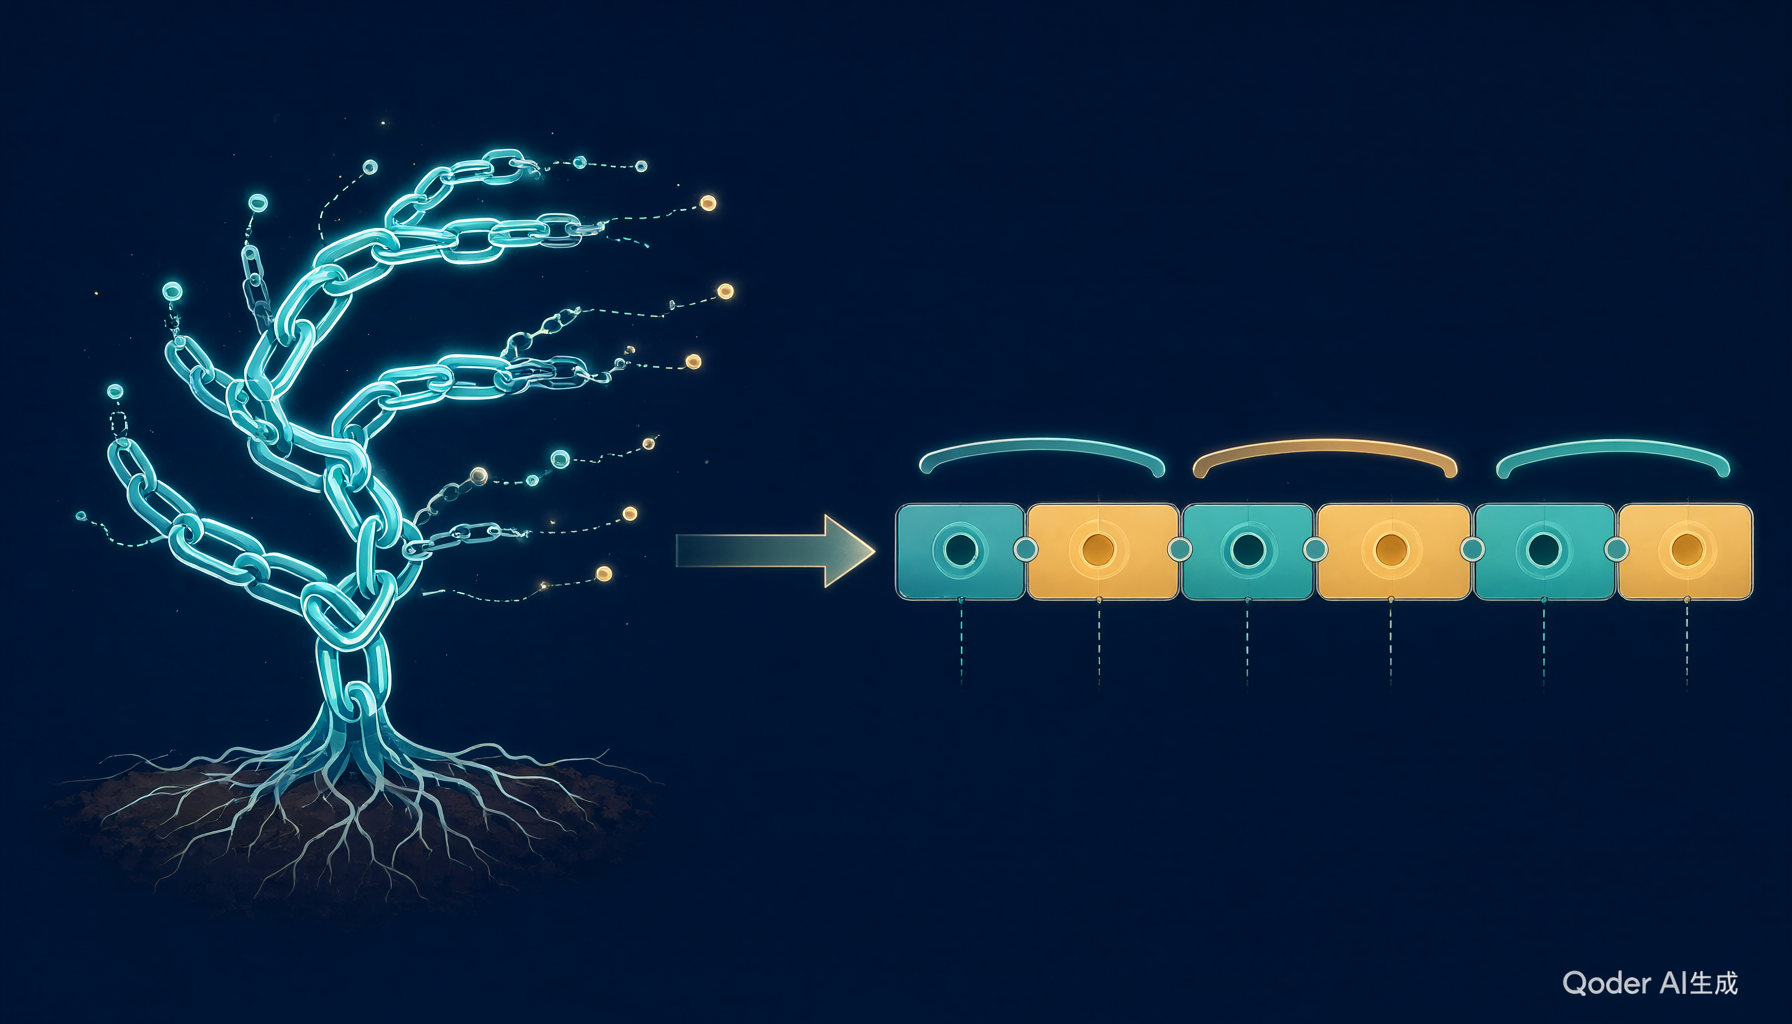
坏消息是路径。u 到 v 的一条简单路径在 DFS 序上通常断成好几截,不连续的区间线段树吃不下。轻重边剖分(下称链剖)的全部聪明之处,就在这个地方:与其抱怨路径不连续,不如改造编号方案本身——选择一种特殊的 DFS 遍历顺序,让”常用的那些路径”在序列上尽量连续。
而实现”尽量连续”的关键,正是轻重边分类:对每个节点,把子树规模最大的那个儿子称为重儿子,连向它的边叫重边;其余是轻边。把只沿重边走的极大连通段定义为一条”链”,DFS 时永远先递归重儿子。这样一条重链上的节点 dfn 连续,且任意 u 到 v 的路径可以被拆成 O(log n) 条链上的若干段——因为从一个点往上跳,每跨过一条轻边,所在子树规模至少翻倍,而规模总共只有 n,所以轻边至多 log n 条。这是整个复杂度分析的核心不等式,值得记住。
二、两次 DFS:各自求什么
实现层面,链剖的预处理就是两次深度优先遍历,各求一组信息,分工非常干净。
第一次 DFS(自底向上)求四样东西:父亲 fa、深度 dep、子树大小 siz、重儿子 son。son[u] 取 u 所有儿子中 siz 最大者。
第二次 DFS(自顶向下)求两样东西:链顶 top 和 DFS 序 dfn。规则是:沿重儿子继续走当前链,top 不变;遇到轻儿子,它以自己为链顶开一条新链。重儿子永远第一个被递归,保证链上 dfn 连续。
const int N = 200010; |
其中 seg 是建在 dfn 序列上的线段树(或树状数组)。剖分各种树上操作的对应关系汇总如下:
| 树上操作 | 剖分后的区间形式 | 复杂度 |
|---|---|---|
| 修改 / 查询子树 | 单段 [dfn[u], dfn[u]+siz[u]-1] | O(log n) |
| 修改 / 查询路径 u→v | 至多 O(log n) 段链上区间 | O(log² n) |
| 询问 u 到 v 路径上的链数 | while 循环跳链次数 | O(log n) |
三、三个最常见的坑
第一个坑:重儿子按”度数”选。错。轻重边的定义对象是子树大小 siz,不是儿子个数。一个节点可能只有两个儿子,但其中一个儿子挂着十万个后代——它才是重儿子。用度数选,O(log n) 的跳链上界立刻不成立,退化案例很容易构造。
第二个坑:把”改子树”和”改路径”当成同一种区间。它们是两种操作:子树是恰好一段连续区间,一次线段树调用;路径是若干段,需要 while 跳链逐段处理。写代码时混淆 dfn[u] 与 dfn[u]+siz[u]-1 的边界,或者在路径循环里把链顶节点本身漏进/多进区间,是调试半天的典型错误。LCA 处理同理:u、v 进入同链后,取深度小者作为区间左端点。
第三个坑:递归爆栈。链剖本身两次 DFS,遇到一条 2×10⁵ 深度的链式树,递归栈直接溢出。竞赛环境可以改栈大小,但更稳妥的是把 dfs1 写成显式栈的后序遍历(先入栈序,倒序累加 siz 并选 son),dfs2 用”沿重链循环下压、轻儿子入栈”的迭代写法。思想不变,只是把系统栈换成自己的栈。
四、洹拓视角:链剖思想在工程里的迁移
回到业务系统。组织架构树、物料 BOM 树、权限树上经常有这类查询:”某节点到根路径上所有部门的预算合计””沿审批链向上找第一个有额度权限的节点”。常见的实现路线有四条,取舍大致如下:
- 递归 CTE(数据库内逐级向上拼路径):实现最直白,无需预处理;但每次查询都是全图遍历级别的成本,深树高频查询下延迟很难看,属于”能用但别依赖”的一档。
- 物化路径(把祖先链存成字符串):读快写贵,节点移动要重写整棵子树的路径,适合结构稳定的组织树。
- 闭包表(预存所有祖先后代对):读写均衡,空间 O(n log n) 到 O(n²) 之间浮动,BOM 这类中等规模树可用。
- 链剖思路移植:按”子树规模优先”重排编号 + 窗口函数或区间汇总表维护路径聚合。它的好处是把”到根路径”稳定切成 O(log n) 段,配合物化的段和小表,查询延迟可预测;代价是树结构变动后要重算编号,适合”读多写少、且必须压延迟尾线”的场景。
判断标准可以做成检查项:查询模式是路径类还是子树类(子树类根本不需要剖分,DFS 序 + 区间更新就够了);树日均变更次数(一天改几千次节点,任何预编号方案都是负担);深度分布是否畸形(链式深树优先物化路径,宽浅树递归 CTE 即可);以及能否接受”预处理结果需要版本号管理”——能,才考虑第 4 条。这类项目里反复出现的教训是:先量查询频率和树形,再选方案,不要拿链剖当锤子见树就敲。