
元素名里装着业务含义时,结构体标签帮不了你
一、先认出这类接口:名字承担的是数据,不是结构
那个场景本身很典型:接口返回一串片段,每个片段用域名后缀做元素名,片段里再放注册、转入与续费的价格。写代码的人第一反应是“这不就是个 map 吗”,然后发现映射框架帮不上忙——值好取,名字才是数据。
识别特征只有一条,但很好用:同一层级出现一族结构相同、名字不同的元素。结构相同说明它们本来是同一种记录,名字不同说明设计者把一组枚举值编码进了标签名。这种做法通常有它的理由:后缀本身就是键,写成元素名对人读报文更友好。把它归到一个类别里(暂且叫它“名值合一”接口),后面所有决策都能从这个类别推出来,不必每次都重新判断。
反面也要认:如果同一层级的元素名字不同、结构也不同,那它就是普通的多分支结构,不该按这一类处理;硬套自定义解析只会白多一层复杂度。
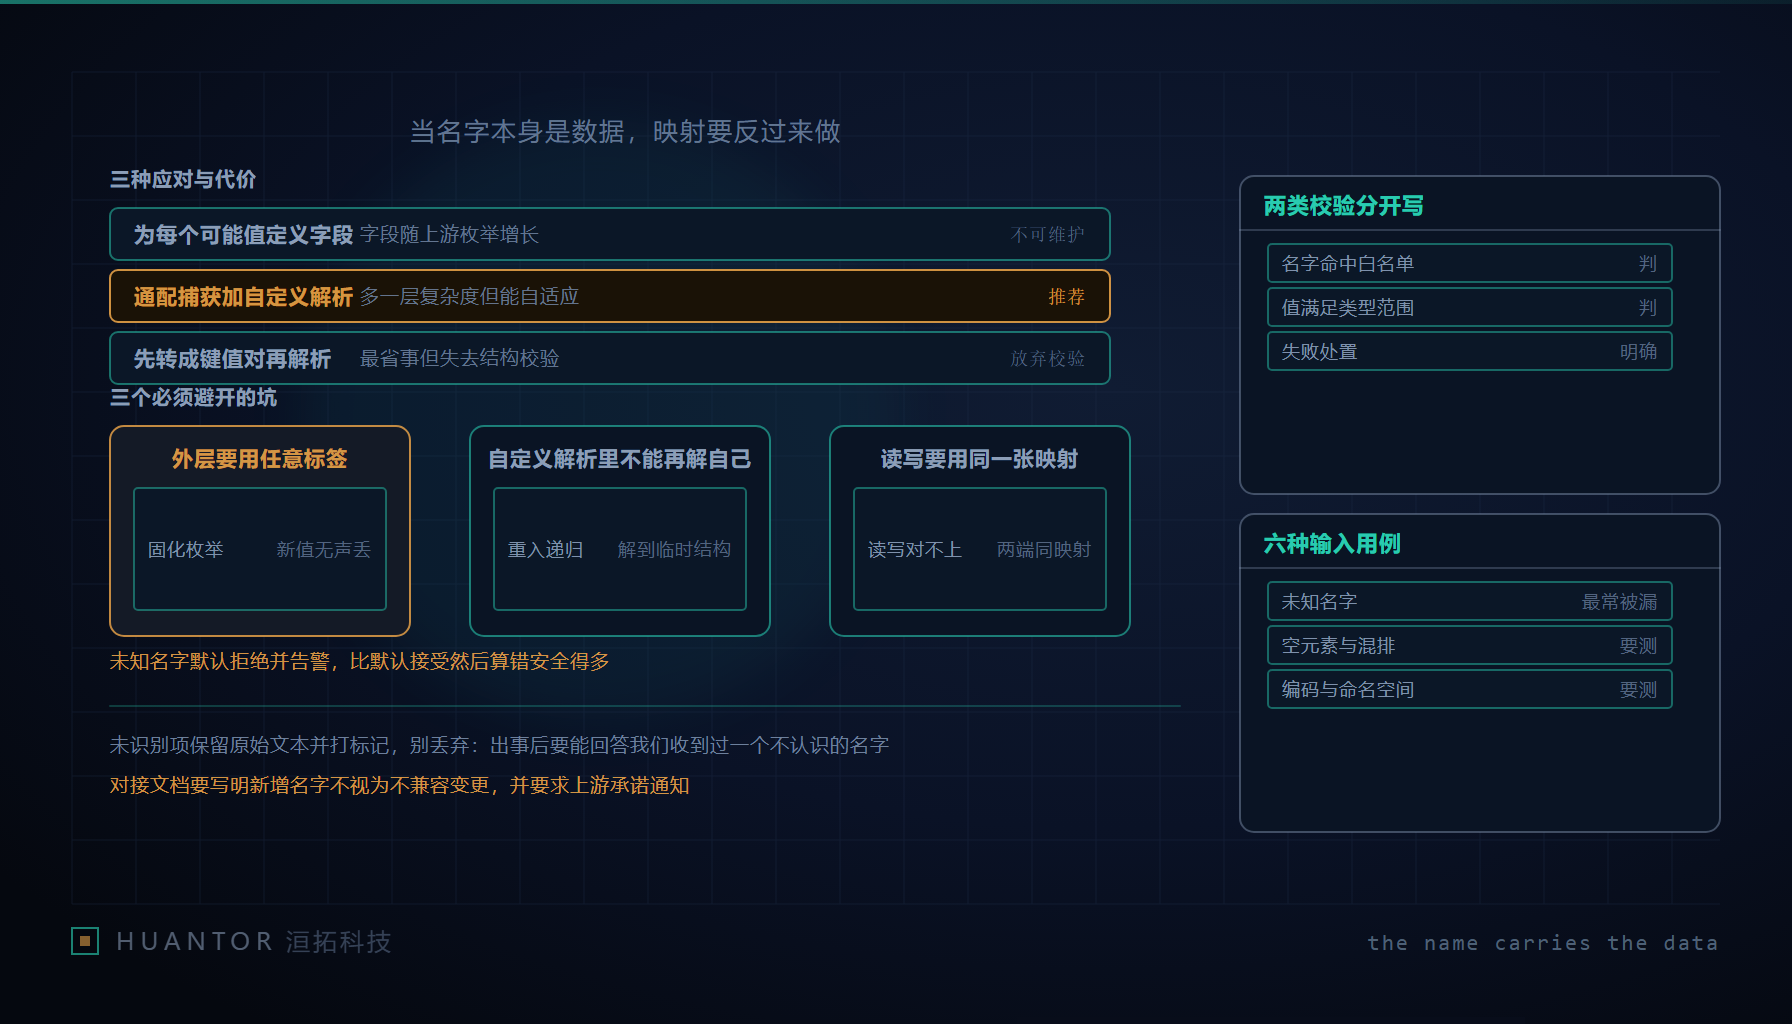
二、三种应对与各自的代价
按投入从小到大排三种,各自的失效方式不同。
- 为每个可能的值定义一个字段。最直观,代价是字段随上游枚举增长:新后缀一来就要改代码、重新发版。这类接口的设计意图恰恰是枚举会增长,所以这条路的维护成本一定爆。
- 用通配方式捕获名字,再加自定义解析。多一层复杂度,但能自适应上游枚举,是这类接口的默认解。
- 把这一层直接转成键值对再交给通用解码。最省事,代价是失去结构校验:上游把字段拼错、少给一层,你察觉不到,只能等到业务算错才发现。
选型标准三个问题:枚举会不会增长(会,则排除第一条);要不要严格校验(要,则排除第三条);响应规模多大(很大,才需要讨论第六节的流式)。三个问题问完,绝大多数场景落在第二条——它不是最优雅的,是唯一同时满足“自适应”和“可校验”的那条。
三、外层为什么必须用“任意元素”这一标签
按来源页的描述,这门语言标准库的解析器只认一个用于捕获元素元信息的固定字段,字段名不可更改,标签无法把局部名自动写进业务字段。解法是实现自定义解析接口:在方法内用一个匿名临时结构体完成一次元素解码——局部名以通配方式捕获,其余字段声明为具体项——再把捕获到的局部名赋给业务字段。
而外层集合必须用“任意元素”这一标签,不能用具体标签。这一条值得单独说,因为它容易被当成排版细节写错。写具体标签,等于把上游的枚举固化进了代码:新后缀到来时,那一段不会被解码,也不会报错,数据就是无声无息地少了。这类丢失比报错危险得多——报错会中断流程,静默丢失只会在月底对账时出现。
反过来,用任意元素标签之后,“上游加了一个我们不认识的值”就从一次代码变更降级成一条数据记录。这正是第二节把选型压在第二条上的原因。
四、递归陷阱:同一个对象上再解一次
自定义解析里最贵的一个坑,来源页点得很准:在自定义解析方法内部,对同一个对象再次解码会无限递归。原因是解码器发现这个类型有自定义解析实现,于是又调回你正在写的这个方法,如此往复。
正解是把这一次解码的目标换成一个新建的一次性结构体(就是第三节那个匿名临时结构体),让它不再携带自定义解析的实现。这个陷阱的通用形态值得单独记住,因为它不止出现在解析里:任何“我正在处理这个节点,然后我又从头处理这个节点”的写法都是同一个递归。转换方法、序列化实现、树形结构的遍历回调,都见过这一形的变体。识别方法是问一句:我这次调用传入的类型,和我当前所在的类型,是不是同一个?
五、两层校验要分开写,未识别项要留下而不是丢掉
名字与值是两层不同的东西,校验也要分两层:名字要命中白名单或模式,值要满足类型与范围。合在一层写的话,你会分不清“我们收到了一个新后缀”和“我们收到了一个已知后缀但价格格式不对”——前者是接口演进,后者是数据质量,处置完全不同。
校验失败的处置要明确写死,可选项就三个:丢弃、标记未识别、整条拒绝。我们推荐中间那档,并且保留原始文本:把不认识的名字连同它的原文一起存下来,打上未识别标记。理由是它让“这条为什么没进统计”有一个可以被回答的解释——三个月后有人问起,你能说出“我们收到了一个不认识的后缀”,而不是“数据本来就没有”。丢弃的代价是永远无法解释,整条拒绝的代价是一个新后缀就能让业务中断。
由此推出新增枚举的默认行为:默认拒绝并告警,比默认接受然后算错安全得多。这里要说清“拒绝”的粒度——拒绝的是那一个名字进入计算,不是拒绝整份报文;被拒绝的那一条走未识别通道留下原文。两者不冲突,合起来才是一套可用的策略。
未识别通道不能只是存着。它要有一个人复看的节律:按周期把未识别清单按名字聚合,出现次数多的那一类要么补进映射表、要么明确记为不支持项,两条路都要留下决定人和决定时间。一个从未被复看过的未识别清单,和直接把数据丢掉没有本质区别,只是把发现问题的时间推后了一次对账。
六、读写对称、流式的分界、开销的正确读法
序列化方向有同一个问题的另一面。业务字段到元素名的还原规则必须与解析规则一致,否则读出来再写回去就对不上,名字在往返中变形。做法是让解析与生成共用同一份映射表:映射表定义一次,两个方向都从它生成,而不是各写一份 switch。来源页也提示,需要同时支持生成时还要实现生成接口——这正好是“两份规则”最容易分叉的地方。
流式与整体解析的分界要按实际压力定。响应规模大到内存吃紧才改用令牌流读取,代价是复杂度明显上升:你要自己管状态、自己处理错误恢复、自己决定一段数据在哪里算完整。不要为了“以后可能会变大”提前上,那一层复杂度会让第五节的两层校验更难写。
开销的正确读法同样重要。多一层解码会带来轻微的内存与处理器开销,常规接口响应规模下可忽略。这句话的实际含义是:不要为了省这一层去写脆弱的字符串处理。字符串切报文省下的那点开销,会以“上游多一个属性就崩”的形式还回来,而后者根本没有测量手段。
测试要覆盖的输入六种,漏得最多的通常是第四与第五种:
| 输入形态 | 这条用例保证什么 |
|---|---|
| 正常一个名字 | 基本映射与赋值正确 |
| 正常多个名字 | 集合层用任意元素标签后仍逐条解码 |
| 未知名字 | 走未识别通道、保留原文、不中断整体 |
| 空元素 | 不误判为缺字段,也不产生幻影记录 |
| 属性与子元素混排 | 名字捕获不被属性干扰 |
| 编码与命名空间变化 | 解码不因声明形式不同而整片丢失 |
最后一件事落在文档上,一句就够:凡以名字承载语义的接口,必须在对接文档里写明“新增名字不视为不兼容变更”,并要求上游承诺通知机制。这一句写清楚之后,第五节的未识别通道才有对应的责任方——上游知道要通知,你知道会收到,两边都不必靠猜。在洹拓的对接文档模板里,这一句和通知方式一起算必填项,缺任一项就不算这份对接文档写完。