
翻译模型搬上显卡:要动的不止一行 device
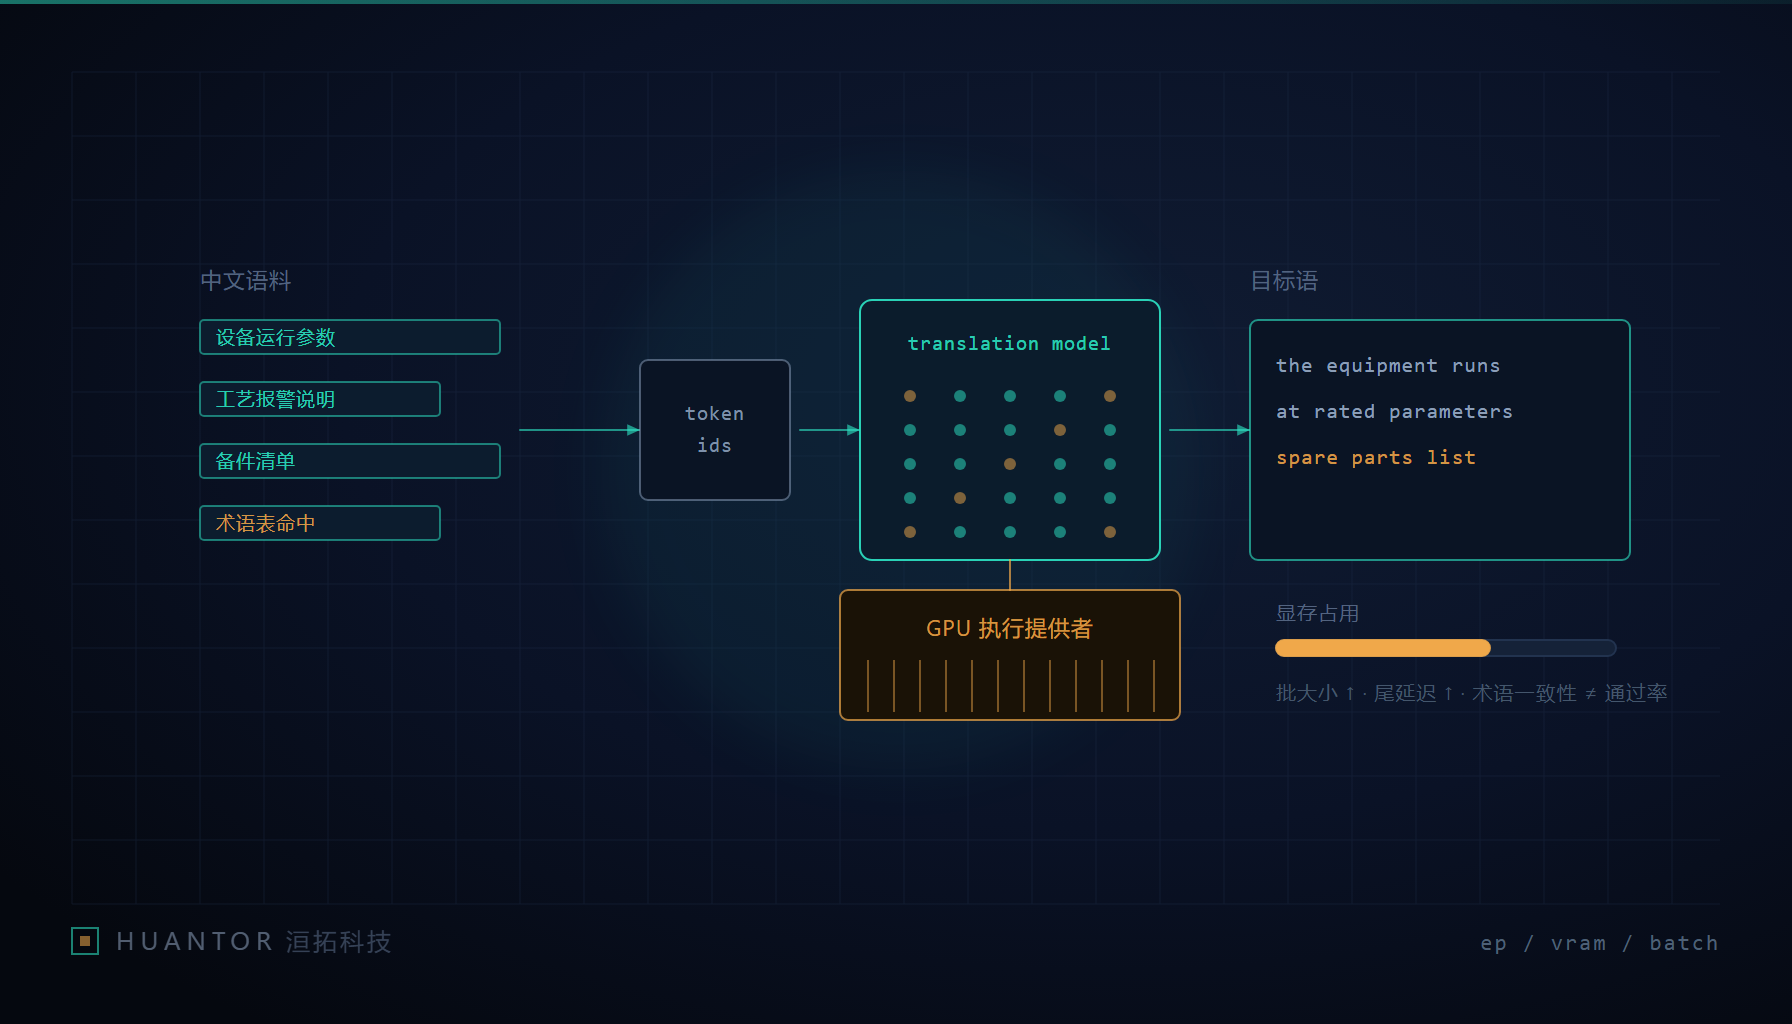
2026 年 10 月看到 HyMT2Sharp 2.0 的介绍,一个纯 C# 实现的腾讯混元翻译模型 Hy-MT2-1.8B 推理库。1.0 版只能跑 x86 CPU,2.0 加上 Vulkan 和 Metal 两个 GPU 后端,CPU 侧补了 AVX-512 与 ARM NEON。测试口径给得很直白:Ryzen 7 5800X 加 RTX 3080 Ti,Q4_K_M 量化,Vulkan 路径预填充 15,834 tok/s、解码 277 tok/s;同一个模型实例在这块卡上大约占 4.3 GB;五种量化(1.25Bit、2Bit、Q4_K_M、Q6_K、Q8_0)的体积从约 440 MB 到约 1.8 GB。
数字好看,但我们在做企业私有化翻译时踩过足够多的坑,知道”从 CPU 搬到 GPU”从来不是一行 device 参数的事情。下面把我们自己的判断摊开讲。
一、CPU 到 GPU 之间隔着算子清单
托管实现自己写推理,意味着每一类算子都要有对应的 GPU kernel:矩阵乘、RMSNorm、RoPE 位置编码、注意力里的 softmax 与掩码、KV 缓存的追加与切片。翻译模型比通用对话模型多几个麻烦点:一是解码步数长,序列长度直接压到 KV 缓存上,显存不是常数而是随上下文增长;二是采样策略要可复现,同一篇文档两次跑出来不一样,客户不会接受;三是术语注入往往要在 prompt 或解码约束层面做,纯 GPU 加速帮不上这段。
所以我们看这类库的第一件事不是分数,而是”哪些算子在这块卡上有回退路径”。混合后端是最实际的形态:主干矩阵乘走 GPU,长尾算子留在 CPU。这会带来一种很难查的问题——数值路径不同,输出就可能不同。原文也承认了相邻的一件事:Vulkan 解码比 llama.cpp 的 CUDA 路径要慢。我们的读法是,跨引擎的比较要在同一台机器、同一份权重、同一套 prompt 下重跑,否则厂商的参考数字对我们毫无意义。
二、量化档位、词表与显存这三笔账
量化不是压缩率问题,是质量问题。 翻译比闲聊对量化更敏感:闲聊只要流畅就可用,翻译要求”这一句里的这个零件名不能改成别的”。低位量化最容易丢的恰恰是低频 token 的判别力,而专业术语全是低频 token。1.25Bit 和 2Bit 那两档我们的用法是离线初筛和演示环境,交付给客户的默认从 Q4_K_M 起步,法律、医疗、招投标文件直接上 Q8_0,宁可少并发也要保住术语稳定。
词表与 tokenize 是托管实现的重灾区。 原文给了一个数:词表 120818。这么大的词表在纯托管代码里做 BPE 合并,热点是查找与切片,做不好会让 GPU 空等。我们的经验是:词表要一次性建到只读结构里、禁止每次请求重新分配,中文长句的切片边界要和标点对齐,否则”一个词被劈成两半”造成的翻译漂移在批量任务里会累积成大片的返工。
显存要按”实例 × 上下文”算,不是按权重算。 权重 440 MB 到 1.8 GB 只是起点。真正吃显存的是那 4.3 GB 级别的实例占用,以及 KV 缓存随上下文的增长。另外有个坑必须写进部署文档:原文提到在 NVIDIA 上 Vulkan 路径不还显存。我们的处理办法是把显存回收当作外部约束来设计——按实例池规划、超时销毁、进程级重启窗口,而不是指望运行时把显存吐回来。GGUF 可以从任意可 seek 的 Stream 加载这一点,对我们反而是好消息:模型文件可以放在只读介质里,走内存映射,避免每次启动都完整拷一遍。
三、15,834 与 277 这两个数字怎么读
这两个数是 prefill 与 decode 两条不同的成本曲线。预填充是并行算提示词,接近矩阵乘的峰值;解码是自回归逐 token 生成,受带宽与串行依赖限制。翻译的产出量取决于解码,所以决定”这篇文档要等多久”的是 277 tok/s 那一条。粗略地按我们的经验换算是:一页 A4 中文正文大约 300 到 500 字,对应输出侧 500 个以内的 token,也就是几秒钟的解码时间,再叠加术语提示词的预填充开销。这里要强调,字到 token 的换算系数是我们项目里的实测估计,不是原文给出的口径。
更关键的是这两个数字无法直接外推成吞吐,因为原文没有给批大小。没有 batching 的解码,显卡利用率通常很低,串行队列会把 277 tok/s 变成”每分钟几篇”。所以我们从来不用单卡 tok/s 去承诺交付产能,而是先在客户环境里跑一份样本包,测”每小时完成多少千字”这个他们真正关心的指标。
长文本切分也只能我们自己定策略。原文没提这块。我们的规则是三档:句子边界优先,其次是段落,最后才是硬切;切分点必须携带前一段的末尾若干句做上下文,否则代词指代和称谓会在段落接缝处丢掉;表格、编号条款、代码块这类结构禁止跨段切分,宁可整块降级走人工。
四、API、自建、只做后编辑:三条路线怎么选
这是洹拓科技给客户做翻译方案时的固定判断表。单位成本一列写相对量级,因为各家语料量和币种差异太大。
| 方案 | 术语一致性 | 数据出域 | 单位成本 | 适合谁 |
|---|---|---|---|---|
| 通用大模型 API | 中,靠提示词维持,长文档易漂移 | 是,需走客户数据出境与合规评审 | 按 token 计费,量小时最优 | 偶发翻译、市场物料、无敏感内容的团队 |
| 本地私有化部署 | 高,术语表与约束解码可常驻 | 否,语料不出内网 | 前期硬件与实施投入大,边际成本低 | 招投标文件、工艺文档、医疗与法务等长期高频且敏感的语料 |
| 只做译后编辑(人工 + 机器初稿) | 高,以人工为准 | 视初稿来源而定 | 人力主导,按千字计 | 关键对外文本、首次建术语库的阶段 |
我们的倾向很明确:语料敏感且量稳定,才谈自建;量不稳的先走 API 加术语表;对外发布的核心文本无论走哪条路都要过一遍人工。三条路可以叠加,不是互斥。
五、术语库定制的落地顺序
私有化翻译的项目失败,八成不是模型不行,是术语库没建起来。我们按这个顺序推:
- 先从客户已有的双语对齐语料里抽高频名词与固定表述,产出一版候选术语表,不追求全覆盖,先覆盖 80% 出现频次。
- 术语表必须由客户业务方逐条签认,工程师代签的一律在验收时返工。
- 把签认的术语表做成约束注入而不是纯提示词祈祷,并留一份”未命中术语”日志,每周回灌。
- 建 200 句左右的回归集,覆盖易错术语与敏感句式,每次换量化档位、换后端、改切分策略都重跑一遍。
- 上线后按月出一致性报告,把漂移最大的三类词回炉。
回归集这一步最容易被省掉,也正是把”翻译质量”从主观感受变成可判定指标的唯一手段。我们的原则是:宁可少一档量化、少一路并发,也不要在没有回归集的情况下动推理栈。
把翻译模型搬上显卡,工程价值确实大——同一块卡把过去要几十秒的一句话压到几秒。但真正决定项目能不能交付的,是算子覆盖、量化对术语的影响、托管分词的稳态、显存池的回收策略,以及术语库有没有人签认。这些做扎实了,GPU 才只是加速;做不扎实,它只是把错误更快地生成出来。