
重试注解里的 exclude,含义和你想的正好相反
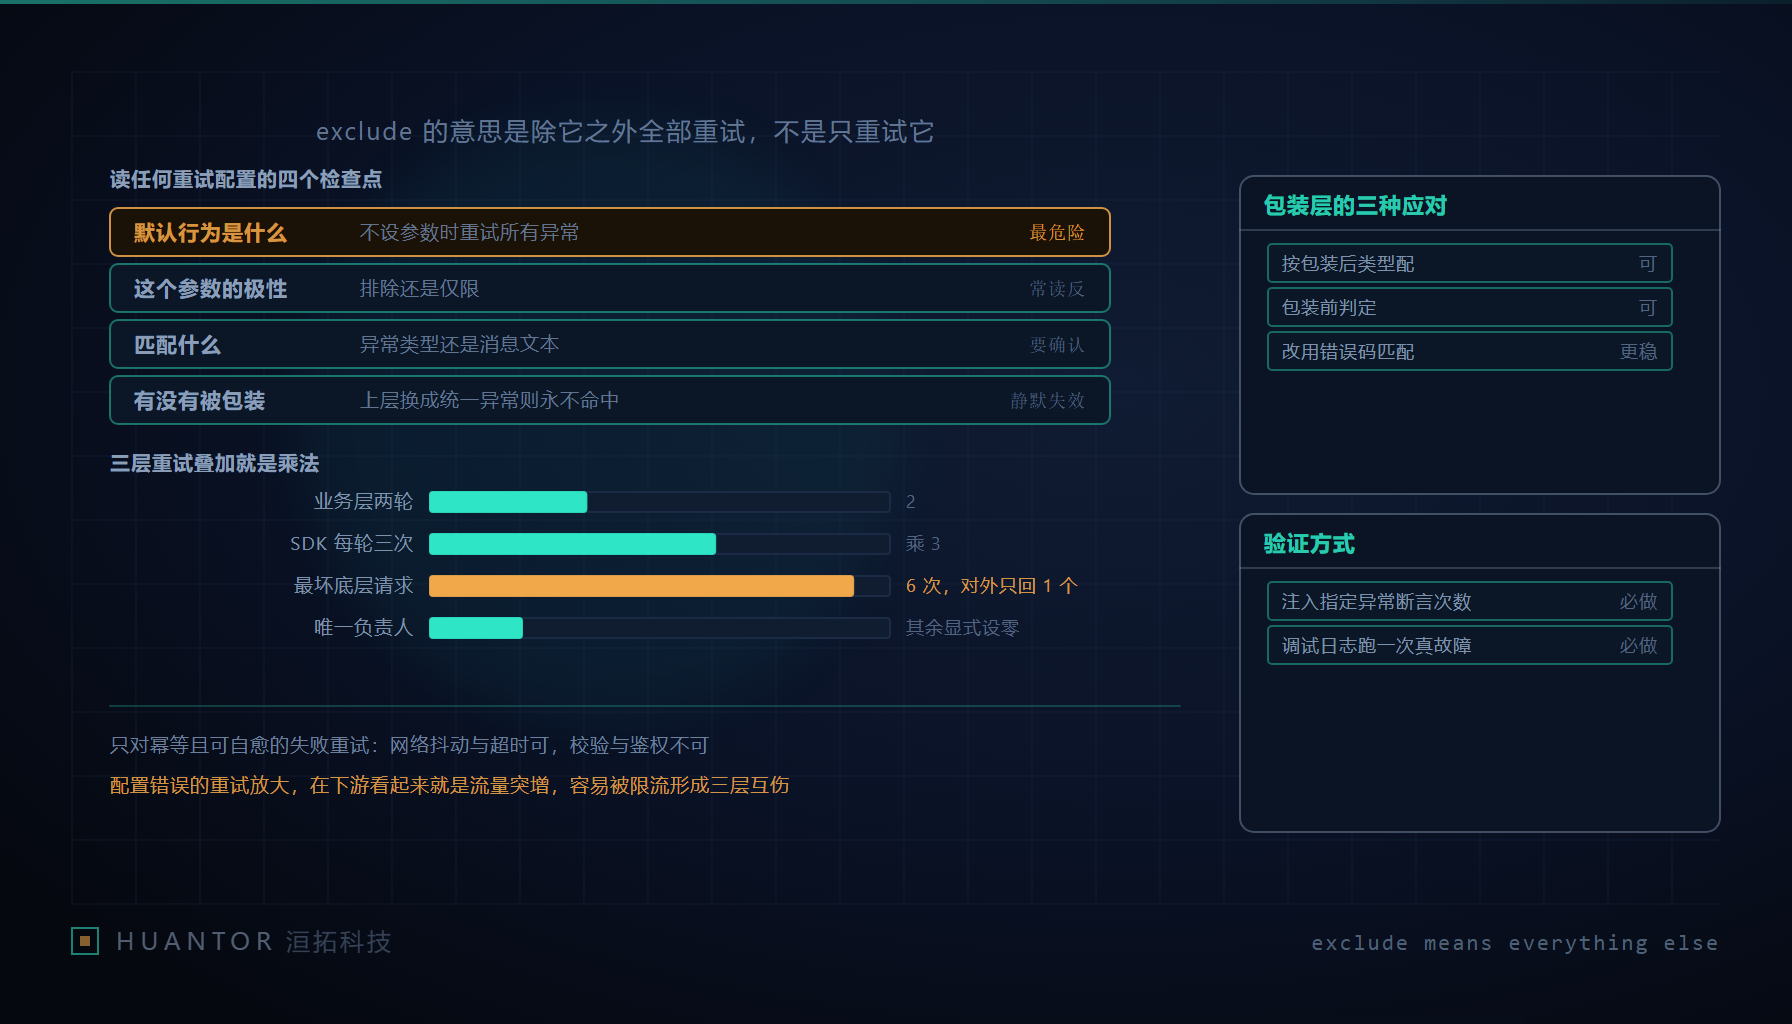
一、“排除”不是“仅限”,而默认值连护栏都没有
那篇排查记录里最值得抄下来的是一句话:某个主流 Java 重试框架的注解里,exclude 的含义是“除该异常之外全部重试”,不是“只重试该异常”。这两个意思完全相反,可它们写在同一行配置上时,读的人会按自己的直觉挑一个。更麻烦的是紧接着的那个默认:当包含类的参数没有设置、exclude 又是空的时,这个注解的行为是重试所有异常。
一个不加任何限定的“重试所有异常”是危险的缺省。理由不是它多跑几次,而是它会把确定性失败拖进重试循环。业务校验不通过、参数非法、库存不足,这类结果重试多少次都是同一个答案;等待期间它占着线程、占着连接、占着下游的配额,把一次快速失败改造成一次慢速失败。响应时间被拉长,错误还在原地等着。
故障的形状大致是这样:配置人在 exclude 里填了一个校验类的异常,心里想的是“只重试超时”。这一行配置真正的意义却是“除了校验异常,其余都重试”。于是数据库连接池耗尽也被重试——池里本来就没有可用连接,每一次重试都是瞬间失败并归还,把仅剩的余量磨干净,同时把上层等待叠成一条很长的尾巴。看上去是“数据库变慢了”,实际是一次配置读反了。
这类东西在洹拓接手客户系统时会被单列成一项复核。判断一个重试配置是否可读,标准不是它看起来多谨慎,而是把默认值遮掉之后还能不能确定行为。
二、读任何一份重试配置的四个检查点
四个检查点按顺序问,缺一问就有一类故障漏在外面。
- 默认行为是什么。什么参数都不填时,它是“什么都不重试”还是“什么都重试”。前者漏配的代价是故障时少做了补救,后者漏配的代价是故障被放大。
- 这个参数的极性是排除还是包含。同一对参数同时存在时,要确认哪一个生效、能不能同时给、同时给了谁优先。
- 匹配的是异常类型还是异常消息。按类型匹配会被包装破坏,按消息匹配会被文案改动破坏,两者的失效方式不同,修法也不同。
- 原始类型有没有被上层包装掉。这一条决定了前三条写在纸上的配置在运行时到底有没有被读到。
第三问在实际项目里经常被跳过:很多团队写重试配置时并没有想过框架拿什么去比对,他们默认比对的是异常对象的可读属性。来源里推荐把异常类写成完整限定名,这是同一件事的另一面——写法要显式到不会产生歧义。之所以要显式到这个程度,有两个理由:一是同名异常类分布在不同的组件里,只写短名时你无法确定被匹配上的是哪一个;二是类加载器不一致时,按名比对本来就会失败,短名让这种失败更难被发现。
三、包装层:按类型匹配为什么永远不命中
来源给的失效三因里最难查的是包装。网关层与消息通知处理层有一个共同的坏习惯:为了对外统一,把任何内部异常换成一个统一异常再抛出去。这个动作单独看是合理的,对重试配置却是致命的——注解按类型匹配,而原始类型已经不在栈顶,匹配永远不命中;于是重试要么不发生,要么退化成按默认全量发生。
三种应对按侵入程度排:
- 按包装后的类型配置。最直接,代价是配置与“哪一层负责包装”耦合,包装层一改配置就失效,而且丢掉对不同失败原因的区分能力。
- 在包装发生之前判断。把重试边界挪到包装层内侧,让重试看到原始异常。代价是重试点会散落在多个位置,必须有统一约定说清哪些层允许设重试。
- 用错误码而不是异常类作为匹配依据。把“这次失败是什么性质”编码进一个稳定字段,重试判定读这个字段。三种里只有它能穿过包装层,前提是全项目对错误码有统一产出与登记,不允许各处自行拼串。
三因里另外两条同样会在真实环境出现:类加载器不一致,或者同一组件被重复引入了不同版本。这两条的共同表现是“配置完全一样,行为却和文档不同”,排查时应该先查依赖树里这个组件出现了几次,再去怀疑注解本身。
四、废弃参数与两套配置叠加:两种静默失效
另一条值得单独说的是版本关系:include 与 exclude 已被标记废弃,改用 retryFor 与 noRetryFor。新名字把极性写在了词面上,这正是它能防住第一节那种误读的原因。真正的坑在过渡期那一段:被废弃不等于被删除,旧参数通常还能编译、还能通过启动,只是不再被底层策略识别。配置看起来写了,行为一点没变。变体稿里那条补充说的是反方向:实际运行在旧版本时,注解配置不被底层模板识别。两个方向都指向同一句结论——编译通过不代表配置生效。
确认新参数真正生效有两种做法:把该框架的日志级别调到调试级跑一次,看它读到的是哪一套参数;或者用第六节那组注入式断言。来源给的调试口径是前者。我们交付时把它写成一次演练而不是长期开着,调试级日志在生产环境的量足以把真正的线索冲掉。
第二种静默失效来自叠加。注解方式与切面方式同时生效时,两套策略是叠加而不是覆盖,实际最大重试次数是两者的乘积而不是较大值。切面方案自己还有一个入口:纯切面写法里,“哪些异常不重试”配置在重试策略对象的忽略异常列表上,不在注解上。所以团队约定要写成一句可检查的话:同一处只允许一种配置方式。评审时按方法检查,两处命中即打回。
五、该重试什么:判据、幂等落点与退避三写法
重试的上界判据只有一条:只对幂等且可自愈的失败重试。网络抖动与超时属于这一类,它们有相当概率在下一轮成功。校验失败、鉴权失败、业务规则不通过不属于,为它们花的每一次重试都是纯浪费。注释里不要只写“这里重试三次”,要写“这里重试,因为失败原因是网络抖动,且该接口对同一业务键重复调用没有副作用”。写不出后半句的,通常就不该有前半句。
幂等必须与重试同时存在,落点是三件东西:
- 去重键:由调用方生成并随请求传递。让被调方在接收时计算,重试恰好落在接收与处理之间时算不出同一个键。
- 幂等表:记录键与首次处理结果,命中时返回第一次的结果,而不是重新执行一遍。
- 判定依据用业务键而不是请求实例。一次逻辑请求在重试下会变成多个实例,按实例去重等于没去。
次数与退避的写法是三条:次数要小;退避要带抖动,否则一批客户端会在同一时刻集体回来;总耗时要有上界,而且上界由调用方的超时决定,不由重试逻辑自己决定。这三条共同决定一件事——下游故障时,这套重试是在帮忙还是在帮凶。
容量视角容易被漏掉:一次配错的放大,在下游看来的形状就是流量突增。下游于是触发限流,限流制造更多超时,更多超时喂给重试,三层互伤的连锁就此成立。我们做微服务改造验收时,会把下游限流阈值与上游重试总预算放进同一张表,两边数字必须互相解释得通。
六、把语义写成可执行断言
配置读对了,最后一步是让它可核验。核心动作是在测试里注入指定类型的异常,断言重试发生了 0 次或 N 次——这一句把“排除还是仅限”从一个人的直觉变成一条会失败的用例。
最小用例集四行:
| 注入的异常 | 期望重试次数 | 这条用例防的是 |
|---|---|---|
| 超时类 | N 次 | 该重试的行为被“默认全量重试”掩盖成看起来正常 |
| 校验类 | 0 次 | 确定性失败被拖进重试循环 |
| 被包装成统一异常之后的超时 | 按约定明确一种 | 包装导致按类型匹配失效 |
| 连接池耗尽类 | 0 次 | 资源型失败被放大成整库故障 |
第三行是这张表里唯一需要额外设计的一行,因为它要造的不是一个异常,而是“包装已经发生”的那条真实调用链;第四行同理,资源耗尽很难在单元层面注入,通常得放到集成层做。
再加一次演练:在预发环境人为制造一次下游超时与一次校验失败,把框架日志调到调试级,确认参数真被识别、次数真按预期。这一步专抓第四节那两类静默失效——它们不会让测试变红,只会让配置退化成注释。
我们复盘客户系统的重试配置时还有一条收尾做法:把“这一处为什么存在”写成一行文字挂在配置旁边。写不出那一行的,就是这一轮该删掉的那一处。