
把一立方公里冰当探测器:极端环境工程的标定、数据链路与维护
一、这类项目和工业现场是同一个问题
据公开报道,有科研团队把一立方公里的极地冰体当作探测介质,从布置到拿到结果走了三十余年。物理原理不在本篇范围内,只看它的工程形态,这个项目有四条特征:传感器撒在大体积介质里;有效信号淹没在本底噪声中;介质与环境本身随时间变化;每个部署周期里留给现场维护的窗口都很短。
把这四条搬到工业现场几乎不用改词:长距离管线上成规模分布的振动与应变测点、井下传感网、沿海风电场的结构监测、大型厂区的能耗与环境感知网络,同样是大范围、强噪声、时变环境加有限维护窗口,差别只在预算和文档规范上。洹拓在工业传感网交付里遇到的麻烦,多数能在这类项目的方法清单里找到对应解法,下面六节就是按这个对应关系写的。
二、本底标定:先回答“没有信号时是什么样”
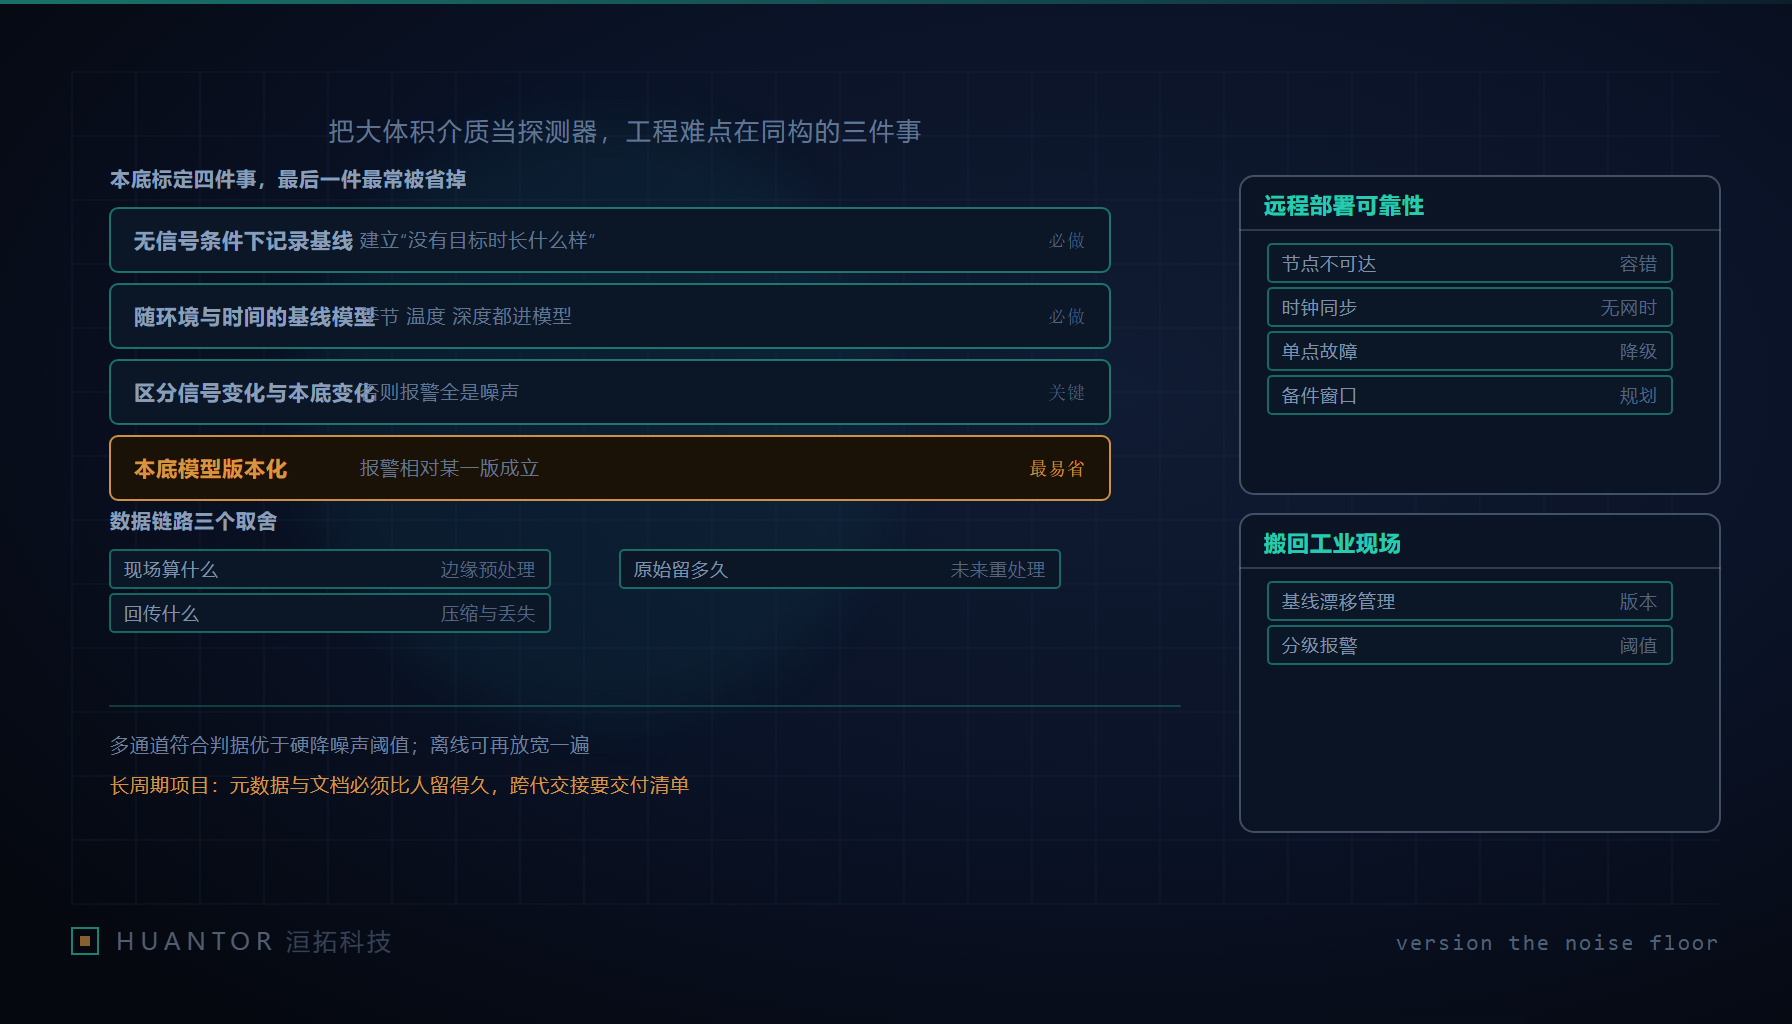
第一件事是在无信号条件下记录基线:所有通道同时采样,把噪声谱、幅值分布及其随时间的变化写成模型。麻烦在于“无信号条件”往往不可得,工程上退而求其次是分段处理,把确认没有目标事件的时段挑出来当基线样本,并把挑选规则连同样本一起记录,否则下一轮标定挑出来的时段和这一轮不一样。
第二件事是建立随环境与时间变化的基线模型。温度、气压、湿度以及介质的季节性状态都会移动噪声水平,所以基线不是一个数,而是一条随协变量变化的曲面。这一步要留的字段包括:建模用的时段、纳入的环境变量、拟合方式、残差分布。
第三件事是区分“信号变化”与“本底变化”。报警环节最容易犯的错,是把本底抬升当成事件增多。做法是双轨并行:事件通道和参考通道(只测环境、不含目标信号)必须同步采集;任何一次报警都要能用参考通道的数据解释或者排除。
第四件事是把本底模型版本化。每一条报警都是相对某一版本的本底模型成立的,所以模型本身要当作交付物来管:
| 字段 | 内容与要求 |
|---|---|
| 基线模型标识 | 唯一编号,写进每一条事件记录 |
| 生效时段 | 起止时刻,附当时的环境条件摘要 |
| 参考通道集合 | 用了哪些通道、哪些位置来建基线 |
| 拟合方式与参数 | 可复现,不接受只写“经验阈值” |
| 残差与质量标记 | 分布统计,以及被剔除的时段和理由 |
| 取代关系 | 替代哪一版、更换原因、由谁批准 |
三、信噪比:不去硬压噪声,而是提高有效选中率
直接压噪声的诱惑很大,代价是把有效事件一起削掉。另一条路是提高有效事件的选中率,具体有四种做法:
- 多通道符合判据。单通道越界不算事件,要求在空间或时间上相关联的若干通道于同一窗口内共同越界,并把随机符合的概率本身当作设计量来算。
- 触发条件分级。一级触发宽,只负责占用缓冲区;二级触发严,只留下值得保留的样本。两条之间要有第三条路:可疑片段暂存、事后回看,而不是全部丢弃。
- 离线重处理。现场用严格阈值保吞吐,数据落库后允许放宽阈值再筛一遍。这要求现场不只存结论,还要存足以支持重算的原始或准原始数据。
- 判据版本化。触发条件与符合窗口要和本底模型同样对待,否则同一批数据在不同时期会得到不同结论,而且无法解释差异从何而来。
四、数据链路:现场算什么、回传什么、留多久
链路的取舍要预先决定,不能到部署现场临时拍板。要写成一组有答案的问题。
现场能算什么?只做时间同步、质量检查与触发判决,还是做特征提取?每加一步现场计算,就把一次不可逆的处理写进了数据里,将来无法回到处理前的状态。必须回传什么?判据是能否离线重处理:凡是触发时刻附近的一段原始波形都必须回传;只回摘要省事,代价是永久失去重算的机会。压缩与丢失策略怎么选?允许有损的部分要写清判据,宁可把片段标记为可疑,也不要静默填补,静默填补会让下游所有分析都失去怀疑的可能。原始数据留多久?留得太少,未来的新算法就没有历史可比性。这条要当成对未来的负债来评估:存储介质与检索成本可以谈,可比性一旦丢了就谈不回来。
五、远程部署:不可达是常态,降级要预先定义
节点不可达不是异常而是常态。协议上要把离线当作可预期状态来处理:状态与数据分开上报;离线期间数据落入本地缓冲;恢复后按优先级补传;缓冲写满时按预先定义的顺序丢弃,而不是随机覆盖。丢弃顺序要能审计,事后要能回答“这一段到底是没有还是被丢了”。
时钟同步在无法联网的条件下必须自洽。节点本地有独立时钟源,靠周期性的一次校准加事后线性或分段修正来对齐;每条事件记录里要写清当时采用的同步方式与不确定度,否则跨通道符合判据会失真,把时钟漂移误判成事件时序。
单点故障后的降级路径要预先定义并让使用方知情:一部分节点失联时,系统是继续报警、降低灵敏度还是停止判定。三种选择对应不同的责任分配,不能在代码里默默选一个默认值。
备件与部署窗口要放在一起规划。维护窗口每个部署周期只有一小段,就意味着窗口之外坏掉的节点只能等到下一段才能处理。可行的做法是备件冗余加降级运行策略:把“缺若干节点时判据仍然成立”算进设计余量,而不是把所有指望放在及时维修上。
六、超长周期项目里,文档要留得比人久
超长周期项目真正的组织问题,是技术栈换了几轮、人也换了几轮。要交付给下一代的不是代码,而是三样东西:元数据模型(每个字段的含义、单位、采集方式与已知缺陷)、处理链的版本记录(哪一版脚本产出了哪一批结果)、判据与基线的演进理由。缺任何一样,后来者只能靠猜,而猜错一次的代价要用很长的时间去偿还。
搬回工业现场,最小动作清单是四条。把基线漂移管理做成常规作业,按参考通道出固定周期的趋势报告,而不是等报警堆起来再查;异常检测做分级报警,事件量与参考量同屏给出,让值班的人有能力排除本底抬升;边缘预处理逐路评估,明确哪些特征必须在现场算、哪些一律回传原始量;断连容错把缓冲容量、补传优先级与丢弃顺序写成配置项,并按周期演练一次“断连若干天再恢复”的完整流程。
本底基线模型的版本化做法与大规模传感网的断连容错清单,是两项不需要额外预算就能着手的工作。极端环境项目的经验并不神秘,它只是把“没有第二次机会”这件事写进了每一份表格里。