
一个格子能装多个值,整张表的数据模型假设就被改了
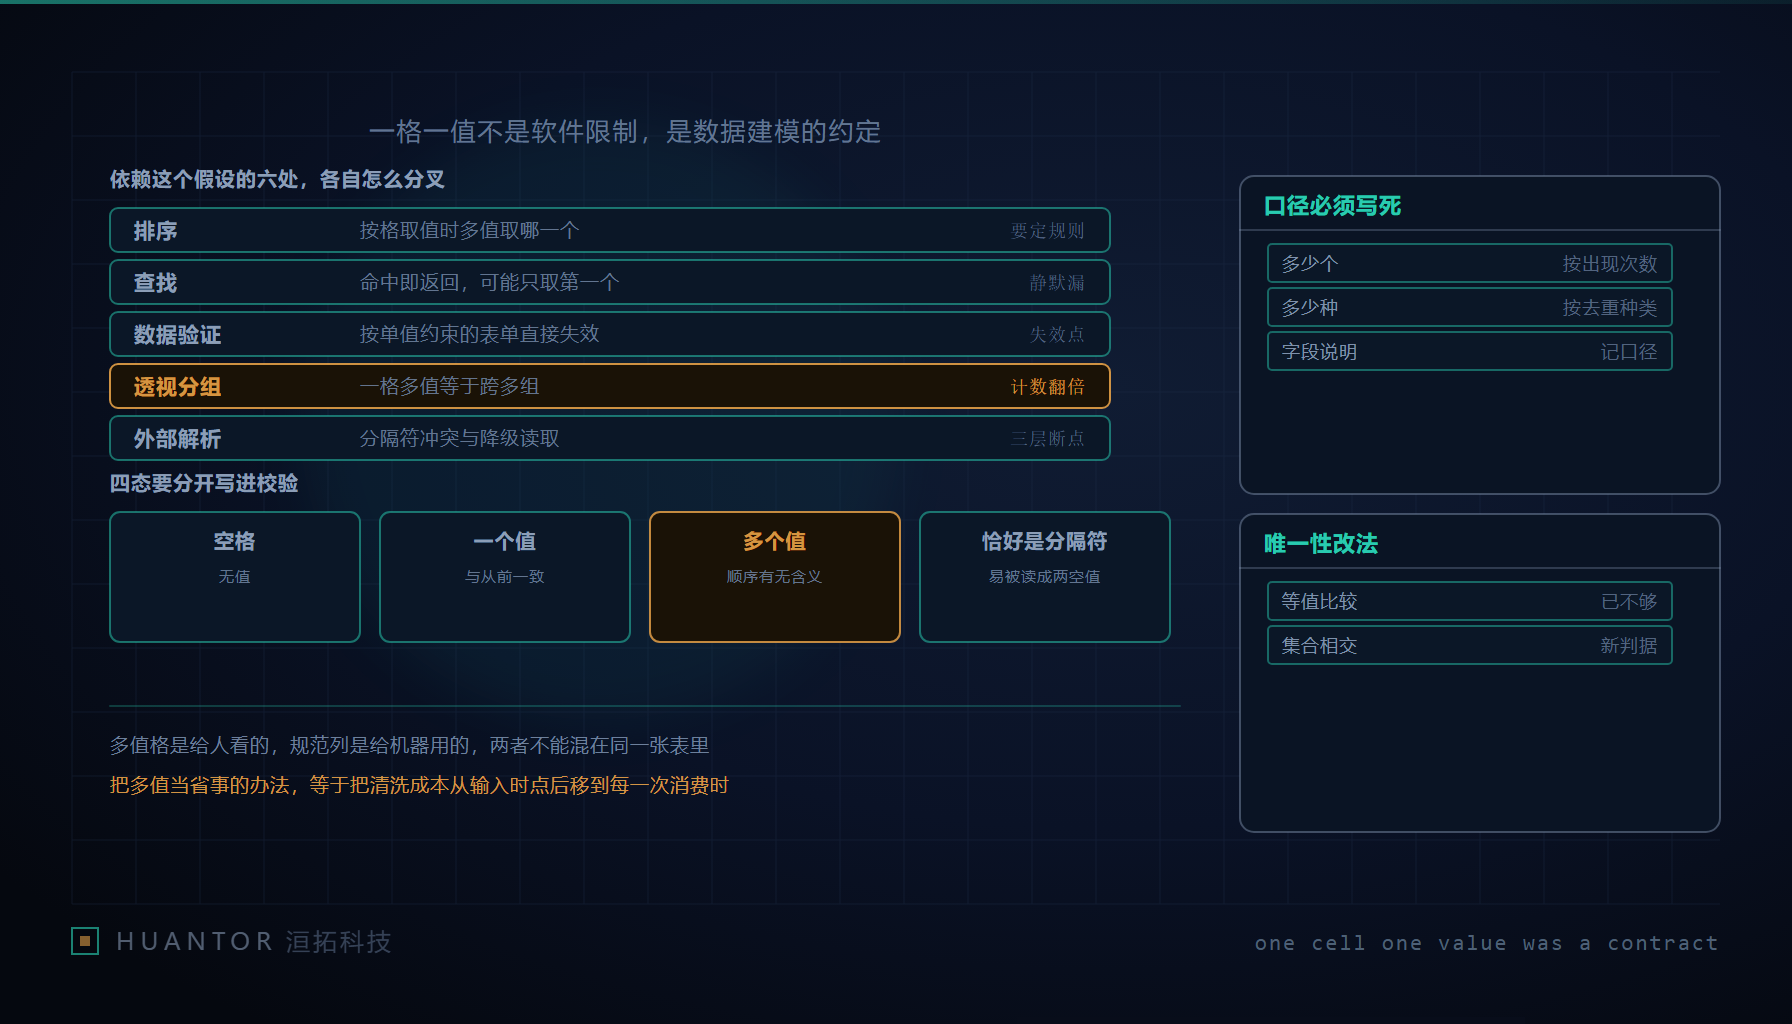
一、被依赖的不是一句限制,是一条建模约定
一格一值长期以来是一个默认假设,而不是软件做不到。围绕它,一整套机制都已经按“格内只有一个可比较的值”来构造。这个假设一旦被官方能力打破,分叉不是一处而是六处。
| 依赖它的机制 | 原本的做法 | 格内多值之后要回答的问题 |
|---|---|---|
| 排序 | 按格取值比较 | 按第一个成员、最后一个成员,还是按拼接后的整串排?三种排法给出的顺序互不相同 |
| 公式计算 | 返回单值 | 返回值可能是一列;参与运算时是隐式塌缩成一个,还是把下游一并变成多值 |
| 查找 | 命中即返回 | 命中判定从“相等”变成“包含”之后,返回的是整格内容还是被命中的那个成员 |
| 数据验证 | 按单值设约束 | 约束作用在整格文本、每个成员,还是成员数量上,三者含义完全不同 |
| 透视分组 | 按格取值分组 | 同一行可能落进多个组,各组行数与占比的加和不再等于总数 |
| 外部系统按列解析 | 一列一值一行 | 对端把整格当一个值,成员之间的分隔符被当成内容本身 |
这六处分叉有一个共同特征:不会报错,只会给出一个“看起来也算合理”的结果。排序按首个成员排,仍然是有序的一列数;命中判定改成包含,仍然能查到东西。真正变化的是含义,而含义不会在任何一层提示里出现。这就是为什么这类改动的影响面要在功能上线之前逐条推演,而不是等报表对不上再回头找。
二、三种形态要先写成业务定义,再对应到功能名
对外宣布的三个能力是列表、单元格内数组和嵌套数组。工程上不必先记功能名,要先把三者对应的业务语义分开定义。
- 列表:同一个属性的多个同类取值。语义重点是“这些值同级、无内部结构”,典型问法是“这一项涉及哪几种”。
- 数组:按位置有序的一列值。语义重点是位置本身承担含义,第几个成员对应什么要能说明白。
- 嵌套数组:多维结构。一旦引入维度,格内就有了行与列的关系,与前面两种不在同一档。
三者能不能互换,取决于业务是否关心顺序与维度。这一点必须写成明确的判定,因为最容易被忽略的恰恰是“有序”这一层:如果格内的顺序被赋予了含义,那么排序规则、去重规则和比对规则都要跟着改,比较的不再是一个值集合,而是一个序列;如果顺序没有被赋予含义,那么成员之间的排列就是噪声,任何依赖它得出结论的公式都是在读噪声。实践中大量表格处在两者之间没人说清的位置,这才是问题所在。
一个可执行的做法是在字段说明里加一栏“格内顺序是否承载含义”,取值只有“是”和“否”。填“是”的字段禁止参与去重与等值比对;填“否”的字段在入库前强制做一次成员排序归一。两种处置方式不同,但都比“没定”好。
三、四态校验:空格、单值、多值、恰好是分隔符
一格一值时代,校验只有两种状态:有值与没值。一格多值之后要区分四态,缺一态就会出错判。
- 空格:确实没有信息。
- 一个值:这是多值能力的合法退化情形,不能因为“只填了一个”就按空处理。
- 多个值:进入集合语义,后续按集合规则处理。
- 一个值,但它恰好就是分隔符字面量:这一格既不是空也不是多值,它是“一个看起来像分隔符的值”,很多脚本会把它判成两个空成员。
第四条不是理论上的边角,它是导入脚本报错最常见的出处。校验规则要按这四态分别写判据,而不是笼统一句“按分隔符切分后统计非空个数”。切分之前先记录原始格的状态,切分之后才能解释“为什么这一行变成两条空值”。
四、导入导出的三层断点要分别定策略
跨边界时的兼容问题不是一层,是三层,混在一起说“保持兼容”等于什么都没说。
- 文本格式层:导出成逗号或制表符分隔的文本时,成员之间的分隔符与字段分隔符直接冲突。处置方式只有两种,转义或者改用另一种序列化形态,选哪一种要写进对接约定,不能让两端各自猜。
- 软件版本层:较旧的读取方遇到新形态时,降级方式要明确——是读成一段纯文本、读成第一个成员,还是整体判定为不支持并报错。三者对使用方的影响不同,报错反而是最诚实的那一种。
- 语言环境层:跨区域设置时字符集与数字格式(千分位、小数点符号)本就容易错位,格内多值会把错位放大成“成员数量都对不上”。
三层要各自给出结论并落在同一份对接说明里。判断依据也很简单:一层出问题时的现象不同,第一层表现为列数漂移,第二层表现为内容读不出来或被截断,第三层表现为数值离谱。能把现象对上层次,排查就不会变成猜。
五、清洗、主键与唯一性:从等值比较改成集合判定
数据清洗侧新增的成本是结构性的。一格多值意味着处理链上要多两步:先拆分,再归一。拆完之后行数一定膨胀,于是原来定义的主键不再唯一,去重规则必须重新定义——这是最容易被漏掉的一步,很多人拆完列就直接拿旧主键做唯一约束,结果要么插入失败,要么静默丢弃。
唯一性的判定方式本身也变了。原本“一列一值一行”的键,现在同一个键可能出现在多个格内、多个位置。重复检测从等值比较变成集合相交:两个格的成员集合有交集就算命中,还是必须完全相等才算命中?这是两种业务规则,前者会把“部分重叠”的记录判成重复,后者会放过它。选哪一种要按业务定,并在检测逻辑的注释里写清,不要留给下一个人猜。
洹拓做数据接入的项目里有一条更硬的约束:凡是供系统读取的区域,保持一列一值一行,不允许出现多值格。需要人在格子里并列填写的场景,可以放在录入区,但录入区与对接区必须在物理上分开,中间用一次显式的拆分与校验步骤连接。多值能力用来改善人的输入,不用来充当数据结构。
六、计数口径两种写法,与内部规范的保留建议
报表口径会被连带改掉。“多少个”和“多少种”这两个问题,在一格一值时是同一件事的两种问法;在多值下不再等价,因为按出现次数累加和按去重种类统计会给出两个都合理的数。计数规则要么按出现次数、要么按去重种类,必须在字段说明里写死,并同时给出“一个格内有重复成员时算几次”这一条边界。否则两个人各出一份报表,数字对不上,讨论会退化成“你的表错了”。
对企业内部长期在用的表格,我们的建议很保守:把一格一值作为内部数据规范保留下来,多值能力只用于人的输入,不用于机器对接。这不是拒绝新功能,而是把成本放在能被控制的时点。把多值当省事的办法,等于把清洗成本从输入时点后移到每一次消费时——同一份数据被读十次,就要拆十次,而且十次里只要有一次规则理解不同,就会产出一个错结论。这是最贵的一档。
给业务方讲这件事,一句话就够:多值格是给人看的,规范列是给机器用的,两者不能混在同一张表里。