
手写一张 BMP 卡在哪:字节序、字段偏移与行对齐
位图格式里 BMP 常被当成入门题:没有压缩,没有熵编码,头部字段少,规范几页就看完。但我们复核过几段”自己拼 BMP”的代码,故障表现几乎一样——文件生成了,大小看着也正常,解码器打开却是全黑、斜切、上下颠倒,或者右边多一条彩色竖带。排查一遍会发现,BMP 难的地方不在内容多,而在它把二进制格式的三个基本功一次考完:字段偏移、字节序、行对齐。
还有一层现实原因:手写 BMP 的需求通常出现在不该出现的地方。受限运行时里没有图像编码库、只需要固定位深度的一个子集、或者许可与体积不允许引入第三方依赖。这些约束本身合理,代价是格式规范里那些”参考解码器不会告诉你”的细节,全要自己实现并自己验证。
一、文件是字节序列,不是结构体
第一个要放弃的习惯,是照着规范里的 C 结构体去声明一个类然后整体序列化。BMP 的文件头是压缩(packed)布局:字段之间没有为了对齐而插入的填充,总长恰好 14 字节,其中 4 字节的像素数据偏移量落在偏移 0x0A 上,这个地址在多数平台上并不满足 4 字节自然对齐。语言层面的结构体在内存里会自动补齐,直接按内存布局 dump 出来的字节和文件里要求的字节差好几处空档。
正确的做法是先写一张偏移表,再按表逐字段落字节。以最常见的 24 位无压缩(BI_RGB,BITMAPINFOHEADER)为例,各字段的偏移、长度与约束如下。
| 偏移 | 长度(字节) | 字段 | 取值要求 |
|---|---|---|---|
| 0x00 | 2 | 文件签名 | 固定为 0x42 0x4D,两个单字节不参与字节序 |
| 0x02 | 4 | 文件总长 | 整个文件的字节数,小端 |
| 0x06 | 2 | 保留 1 | 必须为 0 |
| 0x08 | 2 | 保留 2 | 必须为 0 |
| 0x0A | 4 | 像素数据起始偏移 | 头部长度加调色板长度,24 位无压缩时是 54 |
| 0x0E | 4 | 信息头长度 | BITMAPINFOHEADER 为 40,写在偏移 0x0E 处 |
| 0x12 | 4 | 宽度 | 有符号,单位像素 |
| 0x16 | 4 | 高度 | 有符号,正数表示行自下而上,负数表示自上而下 |
| 0x1A | 2 | 颜色平面数 | 固定为 1 |
| 0x1C | 2 | 位深度 | 1、4、8、16、24、32 之一 |
| 0x1E | 4 | 压缩方式 | 0 表示 BI_RGB(不压缩) |
| 0x22 | 4 | 像素数据长度 | 不压缩时规范允许填 0,建议填真实值 |
| 0x26 | 4 | 水平分辨率 | 单位是像素每米 |
| 0x2A | 4 | 垂直分辨率 | 同上,72 DPI 约等于 2835 |
| 0x2E | 4 | 实际使用颜色数 | 0 表示按位深度取默认值 |
| 0x32 | 4 | 重要颜色数 | 0 表示全部重要 |
14 加 40 等于 54,也就是说没有调色板时像素数据正好从第 54 字节开始,0x0A 处填 54。位深度是 1、4、8 时,信息头之后要有调色板,每项通常 4 字节(依次是蓝、绿、红、一个保留字节),起始偏移变成 54 + 调色板项数 × 4。项数按位深度取颜色总数,1 位是 2 项、8 位是 256 项。16 位与 32 位常见用 BI_BITFIELDS 携带三个通道掩码,掩码放在信息头之后还是像素数据之前存在版本差异;更老的 BITMAPCOREHEADER 只有 12 字节且宽高是 16 位。这几处按你参照的格式规范文档确认,不要靠某个解码器的行为反推。
二、三条最容易写反的规则
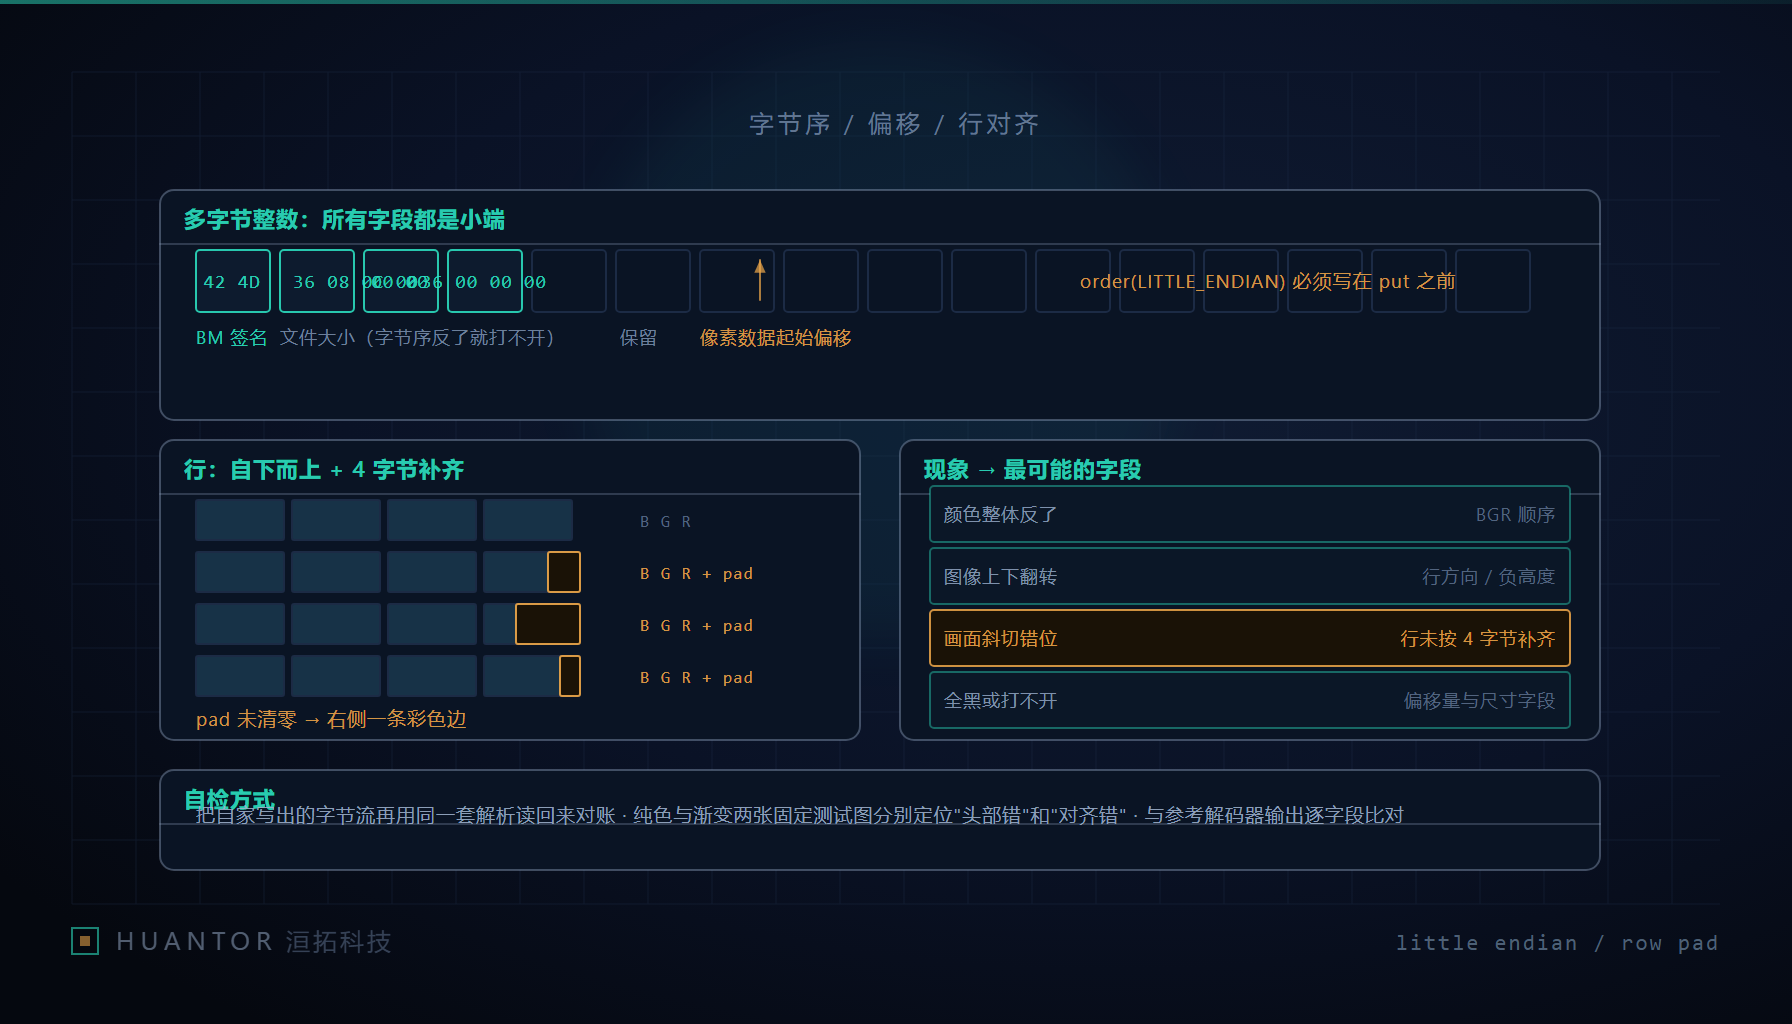
所有多字节整数是小端。 签名之后的文件总长、偏移、宽高、分辨率全部低位在前。Java 的 ByteBuffer 默认字节序是大端,这是坏文件的第一大来源:putInt(54) 在大端下写出 00 00 00 36,而解码器读到的是 36 00 00 00,也就是 54 变成 905969664,第一反应往往是”文件坏了”而不是”字节序错了”。签名和单字节字段不受字节序影响,这让问题更难看出来——头部开头两个字节是对的,损坏从第三字节才开始。
像素是 B-G-R 顺序。 24 位无压缩时每像素三个字节,先蓝后绿再红。写成 R-G-B 的画面能正常显示,但颜色整体是反的:天空发橙,肤色发青。这一条和”小端”是独立的两个坑,可能同时踩。
行自下而上,且每行按 4 字节补齐。 高度为正时,像素数据的第一行对应图像最底行。24 位下一行占 width × 3 字节,要向上取整到 4 的倍数,多出来的 pad 字节要显式写 0。宽 3 像素的图,一行 9 字节,补齐到 12 字节,行内 3 个填充字节;宽 5 像素是 15 字节补到 16。忽略补齐时,第二行整体左移一位,画面呈现逐行递增的斜切。
行长的算法建议写成一处,读写共用:
// 每行字节数:先算位宽总和,再向上取整到 32 位 |
三、ByteBuffer 上顺序要设在写之前
ByteBuffer 的四个约束值得单独说清,因为报错信息都不指向真实原因。第一,allocate(n) 的容量固定,写超不会扩容,直接抛 BufferOverflowException;数组访问式的绝对写入越界抛的是 IndexOutOfBoundsException,两者不同,看异常类型能立刻判断自己走的是相对路径还是绝对路径。第二,order(ByteOrder.LITTLE_ENDIAN) 只影响调用之后发生的多字节读写,已经写进去的字节不会被重新解释,所以必须在任何 putInt 之前设置,读回校验时同理再设一次。第三,相对写入会推进 position,remaining 是 limit - position,写完最后一段像素后如果 remaining 不等于 0,说明算错了长度——这是一个免费的自检断言。第四,用绝对写入(putInt(index, value))可以按偏移表逐字段落笔,可读性更好,但偏移要自己保证不重叠。
static byte[] toBmp24(int[] argb, int width, int height) { |
入参用 int[] 承载像素是为了把颜色顺序显式暴露出来:0xAARRGGBB 的低位字节是蓝,所以第一个 put 不加移位。如果上游像素是预乘 alpha 或者来自 BufferedImage 的不同类型,先转成统一表示再进这个函数,不要在编码循环里混着做转换。
四、自检的顺序:先读回,再看测试图
写完就相信它是对的,是这个环节最常见的失误。可行的自检分三层,按成本从低到高排。
第一层是自家读回:用同一个 ByteBuffer 思路把刚生成的字节再解一遍,逐字段和写入值比对,并检查 b.position() == b.limit()、remaining == 0、文件大小字段 == 数组长度、偏移字段 == 54、row × height + off == size 这几条等式。能读回不等于别人能读,但至少排掉字节序和长度算错。
第二层是固定测试图:先只跑纯色与渐变——整幅纯红、纯绿、纯蓝各一张,一张从左到右的水平灰度渐变,一张上半白下半黑的图。纯色暴露 BGR 顺序,渐变暴露行内偏移与补齐,上下两色图暴露行方向。三张都过了,再跑宽度为 1、2、3、5 的窄图,专门压行对齐。
第三层是比对参考解码器:把同一份像素既交给标准库编码,又交给自家编码器,逐字节 diff。头部字段允许存在约定差异(比如 0x22 填 0 还是填真实长度),像素区应当完全一致;像素区有差异时,先怀疑 pad 是否清零、行顺序是否反。
故障现象与字段的对应关系可以背下来:
| 现象 | 最可能的字段或规则 | 怎么验证 |
|---|---|---|
| 颜色整体反色 | 像素写成 R-G-B | 纯红测试图,读回首像素三字节顺序 |
| 画面上下颠倒 | 高度符号与行写入顺序不一致 | 上半白下半黑图,只改高度符号看是否翻转 |
| 图像斜切、错位逐行递增 | 行未按 4 字节补齐或行长算错 | 宽度换成 4 的倍数看现象是否消失 |
| 右边缘一条彩色竖带 | pad 字节残留未清零 | 检查补齐循环写入是否为 0x00 |
| 打不开或提示截断 | 文件总长与实际字节数不符 | 读回 0x02 与数组长度比对 |
| 全黑、全灰或尺寸异常 | 像素偏移指进头部区域,或宽高字段字节序写反 | 十六进制查看 0x0A、0x12、0x16 处取值 |
| 只有几种颜色或色带分层 | 位深度与调色板项数、起始偏移三者不一致 | 核对 0x1C 与 0x0A 之间的调色板长度 |
五、什么时候手写,什么时候不该
不该手写的场景比想象中多:只要运行时里有可靠的图像编码入口,或者有维护活跃的编码库,就让它做。手写换来的收益只有”完全掌控字节”,代价是规范细节、兼容性差异、边界尺寸的测试全部自己扛,而 BMP 的解码端分布在操作系统查看器、浏览器、嵌入式设备、第三方 SDK 上,你无法预测哪家对”允许为 0”的字段做了严格要求。
必须手写的判断标准也具体:目标解码器只支持固定位深度子集;输出要在无堆分配或受限环境里完成;需要精确控制字节以满足协议或存储约束;引入库的许可或体积不可接受。这四条中任何一条成立才值得动手,且要限定只实现一个子集(比如 24 位 BI_RGB),其余组合显式拒绝并在文档里写清。
六、洹拓视角:这套检查对任何二进制格式都成立
BMP 只是一个便宜的练习对象。真正做接口对接时,同样的五条规则换成不同名字出现:长度前缀、对齐、字节序、有符号与变长编码。我们把它整理成一份写完任何二进制输出都要过的清单。
- 先产出偏移表:字段名、偏移、长度、字节序、有无符号、是否允许为 0,表格比记忆可靠,也直接可以作为交付文档的一部分。
- 总长度字段一律最后回填:先算出各段长度与偏移,再写头部,不要边写边猜。
- 对齐规则读规范原文:是按元素自然对齐还是按固定边界补零,补的是 0 还是重复上一字节,两种写法都存在于不同格式里。
- 字节序在缓冲区创建处一次性设定,读写两侧共用同一处定义;同一结构里混合大小端时,禁止依赖任何默认值。
- 为边界值单独写用例:长度 0、宽度非 4 倍数、最大值、负数高度(或等价的符号位字段),这四类是坏文件集中区。
- 实现只覆盖一张”最小组合表”上的格式组合,其余明确报错而不是尽力尝试——静默降级产生的坏文件最难查。
- 输出后立即用自家解析器读回一次,并把”读回是否等价”作为单元测试断言,而不是靠肉眼打开图片确认。
字段偏移、字节序、对齐这三件事不会因为换了个格式名字就消失。手写一张 BMP 卡住的地方,和对接一份设备报文卡住的地方,通常是同一个位置。