
博客从老 CMS 搬到新引擎:内容兼容的五个断点
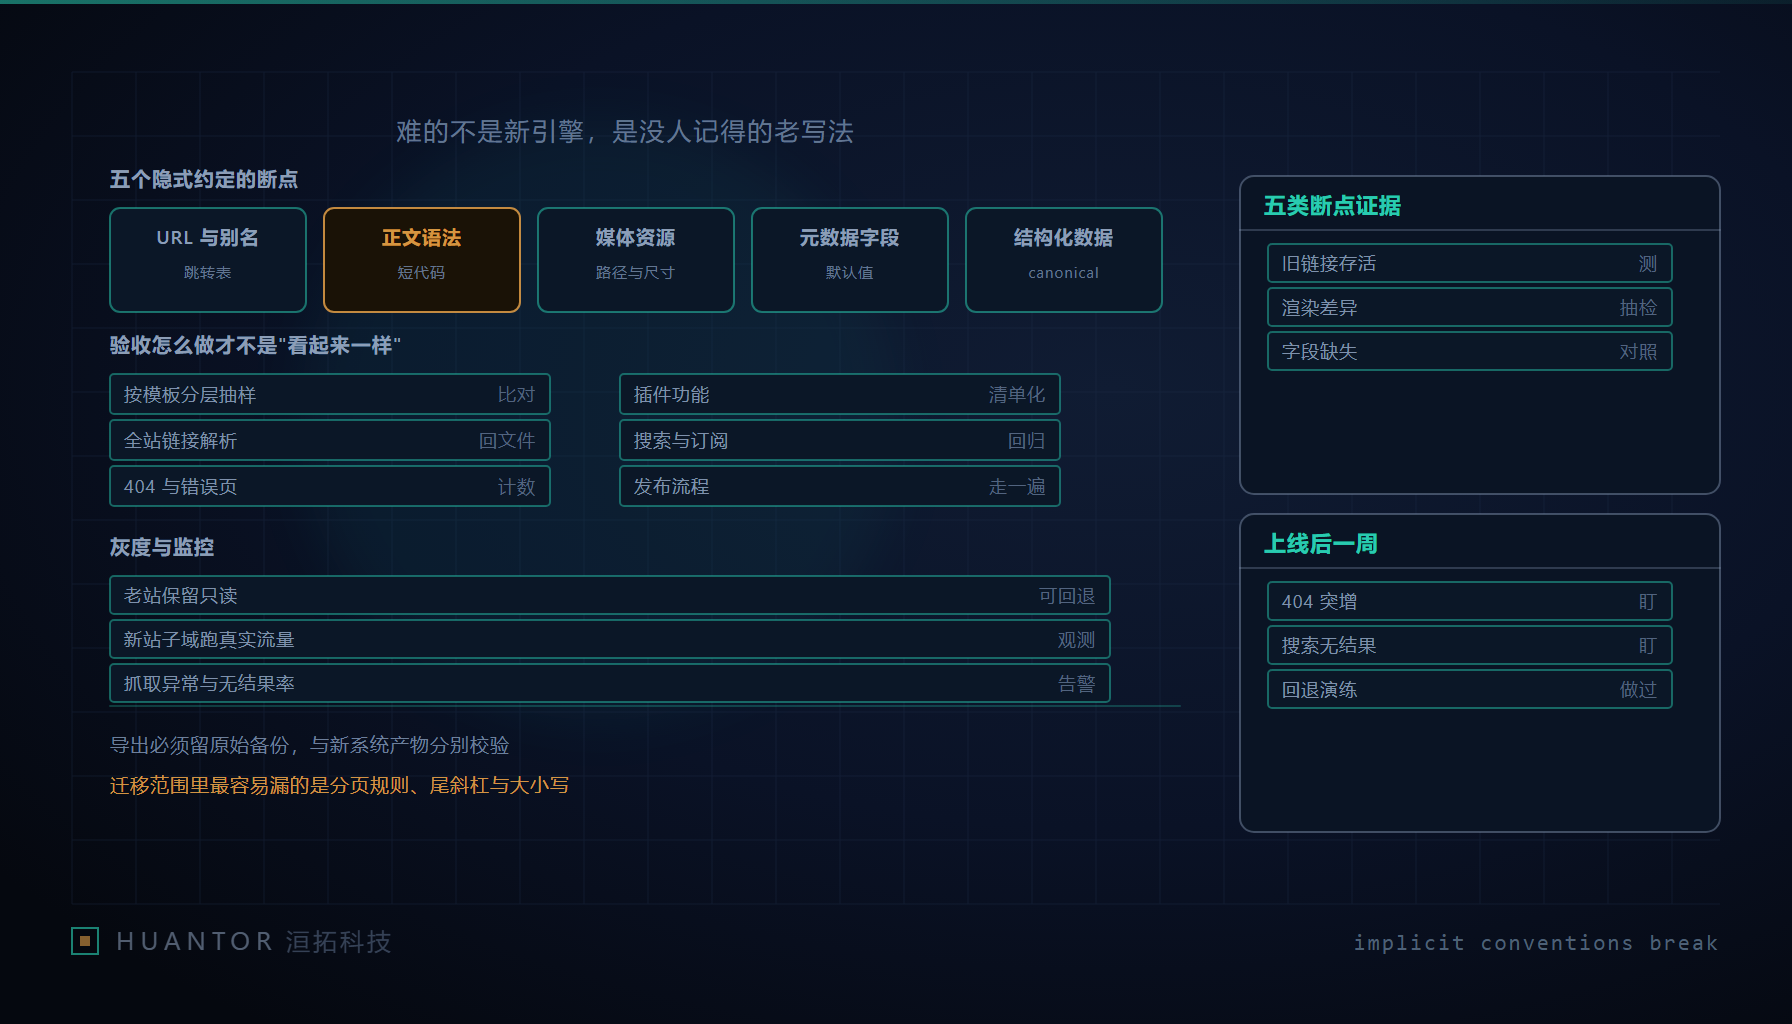
一、真正会掉的是隐式约定,而不是功能清单
据公开报道,有公司发长文记录了把主站博客从一个装了十几年的内容管理系统迁到内部开发并开源的新引擎的过程。它没有公开工具链、耗时与内容规模,这些也不该被拿去当任何人的迁移预算。值得学的是它暴露的那类问题:迁移方案评审时大家比的是功能列表,上线后被发现的却是渲染差异——而功能列表里根本不会出现这些条目。
原因是内容管理系统里有一大类约定是隐式的:某个语法是老插件顺手补的,某段短代码只有三个模板认识,某个字段留空时系统会自动填个默认值,某条地址规则是重写规则里一行看不眼的配置。这些东西在老系统里工作得很好,好到没人记得它们是“加进来的”。搬到新系统,新引擎不知道这些约定,也不会报错,它只会静默变样:短代码原样显示在正文里、摘要变成了正文开头那一截、缩略图尺寸全变。静默变样比失败更难发现,因为它只在老内容里出现,而老内容没人逐篇看。
所以迁移的第一件事不是选引擎,是把隐式约定盘成显式清单。判断标准很简单:凡是“去掉某个插件或某行配置就会变样”的能力,都属于隐式约定,都得进清单。
二、断点一与断点二:地址与正文语法
URL 与别名是第一个断点,也是唯一会直接影响外部流量的。要盘的不是当前能访问的地址,而是历史上被外链引用过的所有形态:手工设过的别名、分类与标签页的地址规则、分页参数的写法、尾斜杠与大小写的处理、带查询参数的旧链接、还有历史上从别的域名迁过来时留下的跳转链。做法是把老系统的别名表与地址规则整份导出,生成一张“旧地址到新地址”的跳转表,然后做旧链接存活测试——从导出表里随机和历史高流量两头各取一批,逐个请求,断言每一跳都落到明确目标且不产生循环。跳转表要保留原始形态,不要“顺手规范化”,否则半年后没人知道某条重定向当初为了谁。
正文语法是第二个断点,特征是错得各不相同。要逐项过:短代码及其参数形态、正文里内嵌的原始 HTML、脚注与锚点、代码块的语言标记与行号、表格对齐写法、列表嵌套深度、图片标题与懒加载属性、数学公式与图表标记、以及被删掉但正文里还留着引用的资源。每项都要拿真实老文章验,而不是构造样例——构造样例只会覆盖你想到的那几种写法,而十年内容里全是没想到的写法。
三、断点三与断点四:媒体资源与元数据
媒体资源的断点有三处。附件路径的组织方式(按年月分目录还是平铺,文件名里有没有被改写过的痕迹)决定文件能不能找回来;缩略图尺寸约定决定同一张图在新引擎里是不是变成另一种裁法;外链图与防盗链决定图片是否直接不显示,而且是悄悄不显示。要额外盘的是“资源存在但没有文章引用”和“文章引用了但资源已丢”这两个方向,两边都要有计数,只查一边会得出虚假的通过结论。
元数据是最容易被“字段名对上就算迁完”糊过去的一层。要逐字段写清来源与默认值语义:作者(老系统是按用户标识存的,新系统按什么存,账号已注销的历史署名怎么表示)、分类与标签(是一对多还是多对多,历史分类名与新分类名要不要改名,改名要不要保持旧地址)、摘要(有没有正文里显式填过,没填时老系统怎么生成)、发布时间与更新时间(哪个字段进结构化数据、哪个进界面显示、修订历史与更新时间是不是同一件事)、状态字段(草稿、定时发布、私密、密码保护在各引擎里的默认值常常不同)。默认值差异是隐式约定的典型:老系统把空摘要当“用正文开头”,新系统当“不输出摘要”,看起来都正常,列表页却一片空白。
四、断点五与五断点映射校验表
结构化数据与 SEO 是第五个断点,因为它的影响要到搜索引擎侧才看得见。sitemap 的生成范围(是否排除某类页面、分页是否收录)、canonical 的取值来源(带参数地址与规范地址的判定)、OG 与 Twitter 卡片的字段来源(标题、描述、图片分别取自哪个字段)、JSON-LD 里的类型与时间字段、以及历史页面的标题模板。这一层最难,因为页面渲染完全正常、内容一字不差,只是标签里的字段换了来源。
| 断点 | 盘什么 | 映射到什么 | 校验方法 | 静默失效的样子 |
|---|---|---|---|---|
| 地址与别名 | 别名表、分页与大小写规则、历史跳转链 | 新路由规则加一张跳转表 | 旧链接存活测试,断言无循环无 404 | 外链进 404,权重与流量一起掉 |
| 正文语法 | 短代码、内嵌 HTML、脚注、代码块、表格 | 新引擎等价语法或显式改写规则 | 真实老文章分层抽样比渲染结果 | 短代码原样显示在页面上 |
| 媒体资源 | 附件路径、缩略图约定、外链与防盗链 | 资源目录结构与尺寸生成规则 | 引用双向计数,逐文件解析存在性 | 图片位置空白但不报错 |
| 元数据 | 作者、分类、标签、摘要、时间与状态 | 字段映射表加默认值说明 | 字段级空值率对比,抽样核对含义 | 摘要或更新时间整列为空 |
| 结构化数据 | sitemap、canonical、OG、JSON-LD | 模板字段来源清单 | 逐类页面比对标签字段来源 | 页面正常,抓取到的元信息错位 |
五、验收方法:分层抽样、链接解析与回归清单
抽样比对要按模板类型分层,而不是全站随机。文章页、分类页、标签页、归档页、单页、搜索结果页各抽一批,每类内部再按“内容年代”和“是否用过特殊语法”分——稀有写法的分布高度集中在旧内容里,随机抽样会把它们全抽丢。判定标准写成“渲染产物逐块比对”,只看视觉像不像会漏掉标签层面的差异。
链接解析是另一件必须机器做的事:抓全站产物里出现的每一个内部链接,逐个解析回文件是否存在、是否存在于预期路径、是否被跳转表覆盖。这件事只能全量做,抽样没有意义,因为坏链接永远是那几条不起眼的。同时统计错误页与 404 计数,把“渲染出错误页”也算成失败而不是通过。
回归清单按用户可达路径列,不能只测详情页:
- 首页与各级列表的分页边界,包括最后一页与带排序参数的页面
- 站内搜索:结果页、无结果页、拼写容错,以及老索引迁不迁的问题
- RSS 与订阅链接:地址是否不变、条目里的链接是否指向新地址
- 评论与归档页:历史评论是否可见、时间线是否完整
- 管理端发布流程:草稿、定时发布、修订历史、权限,逐项跑一遍而不是只看有没有这个入口
- 插件依赖:把“这个功能其实来自插件”单独列一张表,写明新引擎靠什么补,补不上的明确写“此能力暂缺”,不要留成空白
六、灰度、上线后监控与一条校验纪律
灰度方案洹拓内部一般按三步走:老站整站转只读,只允许浏览不允许编辑,避免两边同时写;新引擎先在子域上跑真实流量,用跳转表把老地址接过来,观察一个完整抓取周期;确认无异常再把主域切过去。回退路径要在切之前实测过一次,包括跳转表能不能整体停用、老站产物是否还完整可发布。
上线后的监控只盯四项就够:404 突增(按来源页分组,能直接看出是哪条跳转规则漏了)、抓取异常(搜索引擎侧的抓取错误与索引覆盖变化)、页面渲染报错(模板层报错常常只影响个别历史内容)、站内搜索无结果率(这是内容或索引没迁干净的最早信号)。四项都要在切主域之前接好,不能上线后再补。
最后一条纪律看着多余,却是这类迁移里最省事的保命动作:老系统导出的原始数据必须留完整备份,并且和新系统的产物分别校验,不能只信“看起来一样”。原始备份是唯一的仲裁依据——当新引擎渲染出的结果和记忆中的老站有一点差别时,只有拿原始数据回查,才能判断是内容本来如此,还是迁移把它改坏了。校验脚本要能对同一份原始导出重跑,这样新引擎修了渲染问题之后,不必回头再手工搬一次内容。