
Agent 的编排路线之争:把路径写死,还是让模型自己走
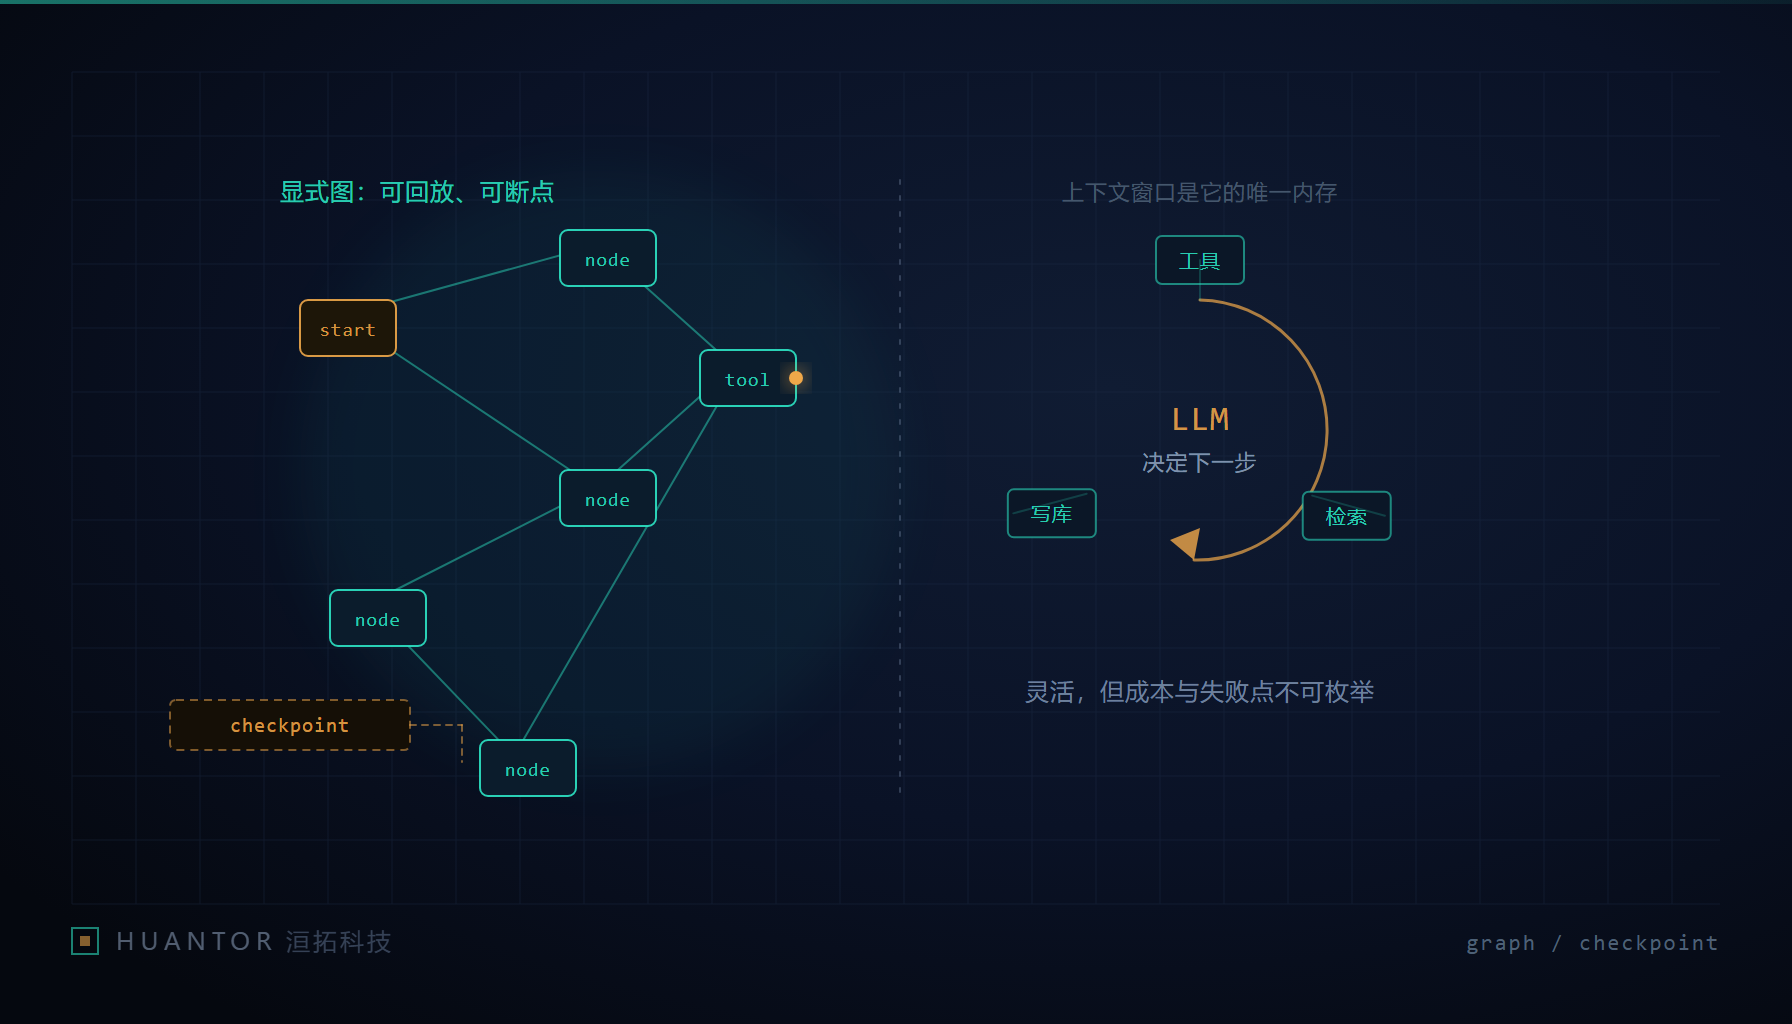
读到一篇讲 Koog 编程模型的文章,正好把我们内部讨论了很久的一件事摆到台面上:Agent 的编排到底该由谁决定下一步。文章按四层来讲 Koog 的编程模型——PromptExecutor、Strategy、Tools、Features,环境要求给的是 JDK 17 以上、Kotlin 2.2.0 以上、Gradle 8.0 或 Maven 3.8 以上,最基础的构造就是一个 AIAgent 把 promptExecutor(例如 MultiLLMPromptExecutor)和 llmModel 拼起来;策略分四类:Basic 预定义策略、Graph-based 图策略、Functional 函数式策略、Planner 规划式策略。
工具侧的写法也很有意思:一个普通函数打上 @Tool 和 @LLMDescription 就能被框架登记进工具注册表 toolRegistry,模型输出的工具调用再由注册表分发执行。图策略里节点和边是直接写死的,文章给的例子大致是这样一段声明式代码:用 strategy<String, String>(“Simple graph-based agent”) 起一个图,节点由 nodeLLMRequestOnlyCallingTools 和 nodeExecuteTools 这类构造声明,边用 edge(nodeStart forwardTo …) 连出去,需要条件时用 onToolCalls { true } 做闸门。Planner 那条路则不同,它让模型自己出计划,或者用 GOAP 算法做 A* 搜索,节点带 precondition 和 cost。
这两段读起来像 API 目录,其实是两种工程哲学。下面讲我们的取舍。
一、两条路线的真实差别不在灵活度
把”图/状态机”和”模型自主决策”摆开对比,最常见的说法是前者死板、后者灵活。我们做了几个项目之后的结论不一样:两者的差别在于错误出现在哪一层。
显式图把控制权交给人,代价是要提前枚举状态与转移,写起来累;收益是每一次运行都能落到”当前在哪个节点、因为哪条边跳到了下一个”这种可描述的位置上。出问题时你能定位到”这条边的条件判断错了”,而不是”模型在想什么”。自主决策反过来,开发阶段极快,原型几天就能演示;但故障是分布式的——同一个输入两次走出不同路径,你无法用一行断言描述它本该走哪条。
我们的判断标准很朴素:这个流程出错之后,能不能用一句人话向客户解释清楚”是哪一步错”。解释不清楚的流程,就不该交给模型自主编排。
二、显式编程模型真正要解决的四件事
如果决定写状态机,麻烦才刚开始。这四件事是任何一类框架都绕不过去的,Koog 的文章对后两件没有展开,我们用”这类框架通常”来讲。
上下文如何传递。 图里的节点不是共享一个巨大的对话历史,而是各取所需。这类框架通常会把节点输入显式建模成”上一节点输出加选择器”,而不是让所有历史无脑拼进提示词。我们的实践是给每个节点声明输入契约,只带该节点用得上的字段:一旦全量历史往下游灌,token 成本随节点数线性上涨,而且早期错误会被后面所有节点反复引用。
节点记忆与检查点。 单个节点内部往往要跑多轮工具调用,这类框架通常提供一个可序列化的对话存储,把节点内轮次存住,节点之间只传结构化结果。这样做的真正价值不是省 token,而是把”记忆”的边界和节点边界对齐,让每一段记忆都有明确的生命周期。
失败后从哪恢复。 文章里没有出现检查点或恢复机制的说法,我们按自己的做法讲:长流程必须有可重放的执行日志,记录到”节点 + 边 + 该次输入摘要”这个粒度。失败时优先只重放失败节点,而不是从头跑整条链——尤其当某个节点已经写了外部系统时,从头重放就是制造脏数据。幂等性没法保证的节点,必须单独标成”只能人工确认后续跑”。
工具调用的边界与重试。 工具的可见范围要按节点收窄,不是全局共享。Koog 例子里那个只调用工具的节点就是好设计:把”决定调什么”和”真的去调”拆成两个节点,中间就天然有了审批位。重试策略我们一般定三层:网络类错误自动重试且退避,参数校验失败回退到上一个决策节点并附失败原因,业务规则拒绝则直接走人工分支,绝不自动重试。
三、哪些流程必须写成状态机
这是洹拓科技给客户上 Agent 时的判定清单,命中任意一条就必须显式建图。
- 涉及资金、库存、权限变更或对外承诺的动作节点。
- 有合规留痕要求,需要证明”当时按什么顺序执行了哪些步骤”。
- 单次运行成本超过一个可设上限,需要在节点粒度做预算截断。
- 步骤之间的先后是业务事实而不是偏好,例如必须先取物料清单再做工艺参数比对。
- 存在必须人工确认的闸门,且闸门不能靠提示词”提醒”模型。
- 需要用同一份输入做回归测试,路径不可复现的框架根本没法写断言。
反过来,这几类可以放开让模型自己走,用 Functional 那种函数式编排反而更合适:
- 开放式检索与归纳,比如把一堆现场巡检记录整理成待办清单。
- 探索性分析,用户自己也不确定要几步才到答案。
- 草稿生成类,产出后面必然过人工审核。
- 步骤少、工具同质、失败无副作用的轻量助手。
Planner 那条带 precondition 和 cost 的搜索路线,我们的定位是”介于两者之间”:它看起来是模型出计划,但每个动作有前置条件和代价,于是计划本身是可校验的。这一类机制适合排产、路径规划这种”组合空间大但有硬约束”的问题,不适合对话式任务。把它当成通用规划器用,通常会在约束不完备时生成看似合理却违反现场规则的步骤。
四、上线前我们坚持的三条硬约束
- 路径可导出。 每一次运行都要能打印成”节点序列 + 命中边的条件”,客户审计时这张图比任何解释都管用。
- 预算可截断。 单次运行的 token 与工具调用次数设上限,超限走人工,不设上限的 Agent 迟早会在某个循环里烧掉一天的费用。
- 回归集先于新节点。 任何新增节点,先补进回归用例再上线;没有用例的新节点等于往状态机里塞了一个不可测试的分支。
Agent 框架之间的差异,短期看是特性列表,长期看就是编程模型这一层。我们的立场不激进:该写死的地方老老实实建图,该放开的大胆让模型走,但放开的部分必须留好出口——成本上限、人工闸门、日志重放三样齐全,才叫可控的灵活。