
语音记忆基准考的不是转写:说话人、语气与跨会话怎么测
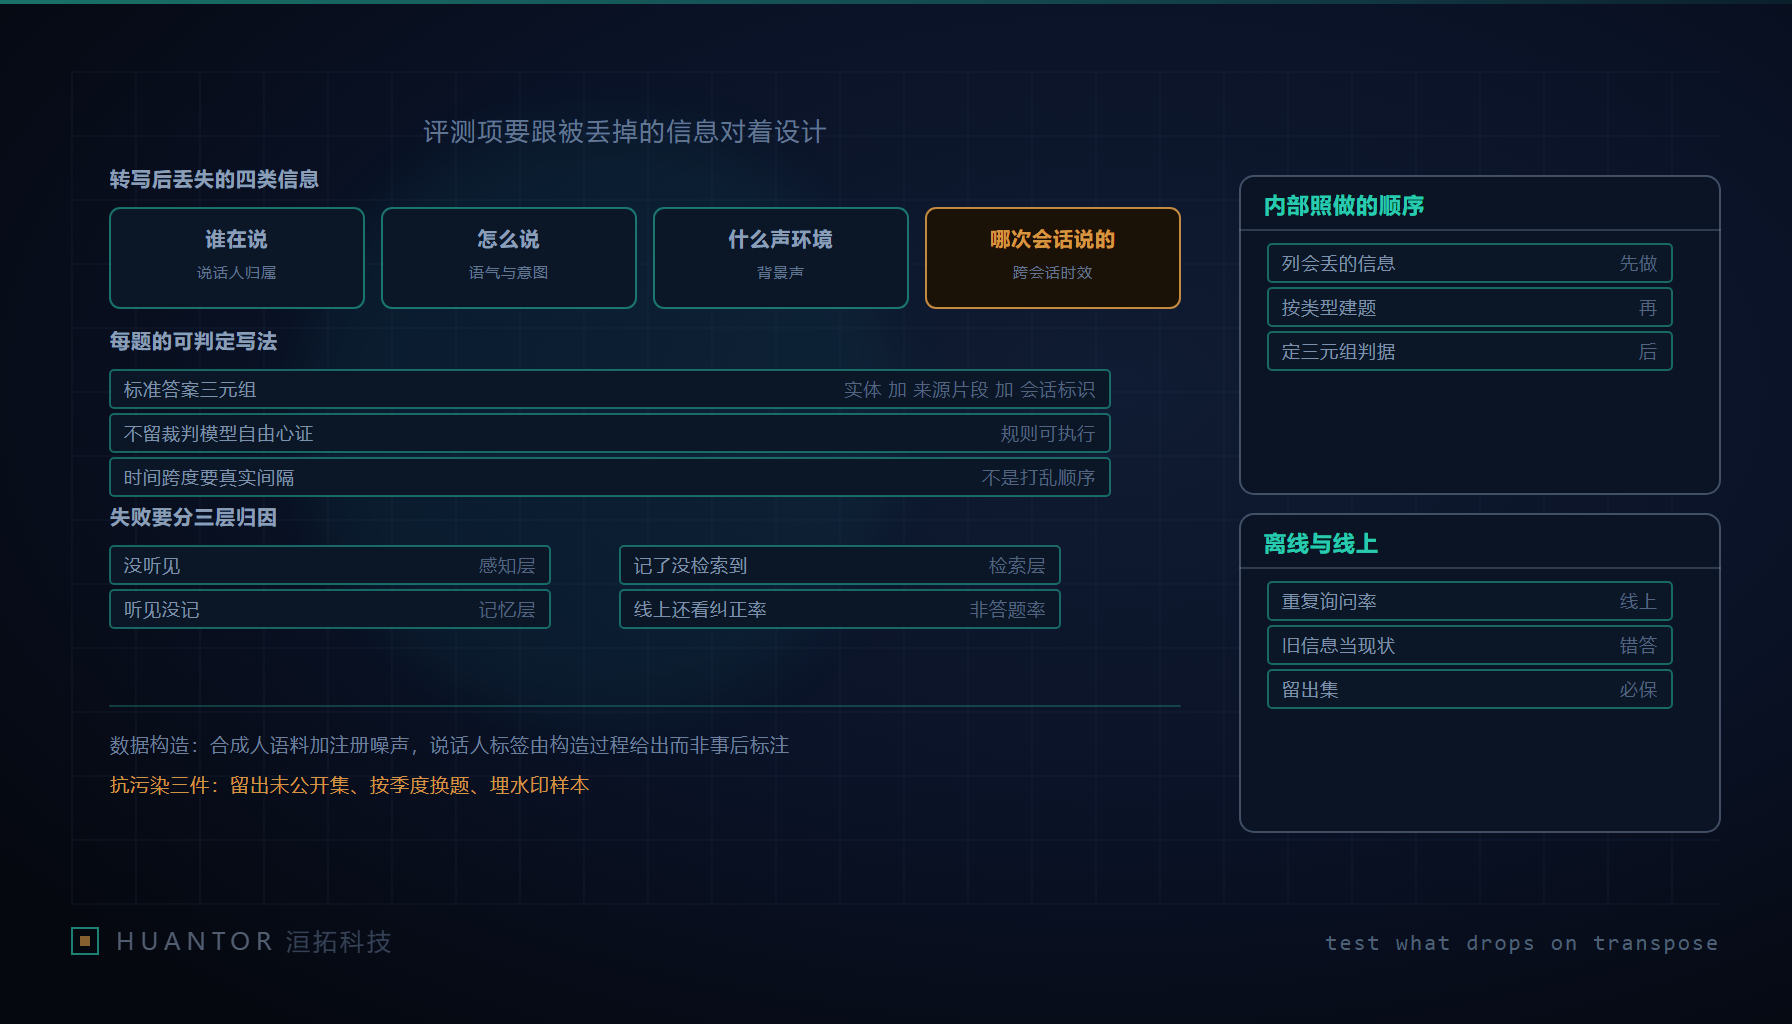
一、转写丢掉的是信息类别,不是杂音
据公开报道,有新基准专门针对音频模型“记不住谁说的、怎么说”这个问题,指出现有评测的两处缺口:一是说话人身份、语气和背景声只存在于音频信号里,一转写就没了,而现有基准大多只考词汇内容;二是真实交互散落在相隔一段时间的多个会话里,多数评测却在单会话内出题。
这个批评对工程侧的价值不在于分数,而在于它把出题方向重新指了一遍。团队做语音相关的评测,常见路径是先接一层转写,把音频变成文本,然后在文本上写题。这条路径省事,代价是它考的是“转写之后还剩什么”。剩下的是词汇,丢掉的是四类东西:谁在说、怎么说、在什么声环境里说、这句话是哪一次会话说的。评测项要跟被丢掉的信息对着设计,否则跑完一圈拿到的读数,本质上是文本理解能力套了个音频的壳。
二、四类可测项与各自的题式
四类信息的失效方式不同,题式也就不能共用一套模板。
| 被丢的信息 | 可测项怎么设 | 判据要看什么 | 答错的含义 |
|---|---|---|---|
| 谁在说 | 同一句内容分别由两个声线说出,问该按谁的偏好处理;或把归属写错再问能否发现 | 结论是否随声线改变而改变 | 多用户场景下的串号风险 |
| 怎么说 | 把同一句话换成陈述、反问、迟疑、玩笑四种说法 | 是否把反问或玩笑当成事实记录下来 | 记忆写入被污染,后续全是错账 |
| 在什么环境里说 | 背景声里带关键线索(设备提示音、门外喊话、施工声),线索不进转写 | 是否把环境声纳入事实或正确排除 | 场景理解缺失,误判当前状态 |
| 哪一次说的 | 同一事实在早先会话说过,后续会话被更正,隔一段时间后提问 | 答的是当前版本还是旧版本,能否说出去向 | 时效管理失效 |
说话人归属这一项最容易被做假。如果题目里同时给了文字姓名标签,模型可以绕开音频答题,测出来的还是文本能力。可用的做法是把归属信息只放在声线里,文字里不出现称呼,或者故意让称呼与声线不一致,看它信哪个。语气一项同理,判据不能只看它复述对了文字,要看它把这句话归成了哪种意图类别。
声环境这一项要谨慎设题。背景声进入事实的边界很窄,把键盘声当成“对方正在打字”是合理推断,把房间里的电视声当成“用户在看某节目”就越界了。出题时要把这两类分开标注,前者答错算能力问题,后者答对反而要算错,因为它在没有依据的地方建立了事实。
跨会话时效这四项里最难做,因为多数评测集根本没有真实的时间维度。把同一批会话随机打乱顺序,冒充“相隔很久”,测不出任何东西:模型只需要按上下文里的先后关系答题。真实间隔意味着题目要考“它愿不愿意相信自己记住的东西已经过期”,这只有把新旧两个版本真的隔开足够远才有意义。
三、判据写成三元组,别交给裁判模型自由心证
语音记忆的题面天然带歧义,如果标准答案只是一段参考文本,再让一个模型去比对语义相近,读数会被裁判模型的偏好带着走。我们的写法是每条标准答案固定三个字段。
- 实体:被考的那个事实对象,标识稳定,不接受同义改写带来的匹配歧义
- 来源片段:这个事实出自哪一段音频的哪个区间,音频标识与起止位置都要填
- 时间戳:这个事实是在哪一次会话、会话内的什么时刻建立的,以及有没有后续版本覆盖它
三元组的意义在于它把“答对了”拆成三件可独立检查的事:答的内容对不对、依据找没找对、找的是不是当前有效的那一版。很多模型会在第二、三项上露馅——结论碰巧正确,但引用了一段并不支持该结论的音频,或者引用了已被更正的旧版本。只看内容对错的评分会把这两类错误算成通过。
对语气类的题,三元组要再加一个意图类别字段,把它归成的类别与构造时给的类别直接比对,不做语义判断。裁判模型只被允许做一件事:把答案里的字段抽出来。判定规则写在代码里。
四、数据构造:标签要由构造过程给出
四类信息里最难的是获取真实标签。事后人工标注说话人和意图,成本高而且不可信——标注者听到的语气和真实用户听到的语气不是一回事。可用的路径是把标签做进构造过程里。
具体是这样:用合成语音生成语料,说话人身份由生成时使用的声线登记表直接给出,不依赖事后辨认;噪声不是随机叠加,而是从一份注册过的噪声库里按标识引入,每题记下用了哪几段、什么强度;多会话的时间跨度按真实间隔生成,同一批素材拉开到不同的时间戳上,并在元数据里记录先后与覆盖关系。这样做还有个额外好处:所有标签天生精确,不需要标注一致性这类补偿指标,也不会出现“两个标注员听出两种语气”的争议。
代价是合成语料与真实音频存在分布差。缓解办法是留出极小的一批真实录音只做校验,不用于出题主线,专门回答“合成出来的结论在真实音频上是否还成立”。
抗污染是构造阶段必须一起做的,而不是事后补的。四件事:留一批永不公开的题集;按季度换题,避免整个社区面向固定题集调参;掺入近实时素材,让背答案的模型无从下手;在题目里埋带标识的水印样本,用来识别有没有人直接把题库喂进训练。
五、失败要分三层,三层修法完全不同
只报一个正确率,团队会把三种病当一种病治。
| 失败层 | 现象特征 | 归因方向 | 修哪里 |
|---|---|---|---|
| 没听见 | 关键音频区间根本没进模型输入,换声线换环境后答案完全不变 | 输入侧:采样与窗口裁剪把信息截掉了 | 观测窗口与音频输入链路 |
| 听见但没记 | 当前会话能答对,隔一次会话就答不出或答成通用假设 | 写入侧:记忆写入只保留了文本摘要 | 写入策略与字段结构 |
| 记了没检索到 | 直接问能答对,绕一句就找不到;或新旧版本同时召回却选了旧的 | 检索侧:召回条件与时效优先级 | 检索键、时间戳与覆盖关系 |
三层的区分手段是现成的:给第二层用“当场问”与“隔会话问”做对照;给第三层用“直接给标识问”与“用自然语言问”做对照;第一层则用注入已知答案的对照样本,看输入通道有没有真的把那段音频带进去。分层的价值在于修的位置完全不同,把“记了没检索到”当成模型能力不足去换底座,钱花了问题还在。
六、离线分数与线上表现之间隔着三个指标
离线只测答题正确率,线上真正难看的是另外三件事。
纠正率:用户说“不是这个意思”之后,下一轮有没有真的改掉,以及改完之后旧版本有没有被清掉。重复询问率:同一件事隔一段时间再问一次,模型是不是又问了一遍用户已经回答过的内容,这个数字在语音场景里比准确率更能反映记忆是否在起作用。旧信息当现状的错答比例:拿已被更正的旧事实回答当前问题,这类错误在离线题里容易被三元组抓到,在线上没有标准答案可对照,只能靠抽样回访和投诉线索发现。
企业内部要照做,不必先建大集,按五步走:先列出业务里所有经由语音或多源输入、并且会在转写或摘要中丢失的信息类型;按类型建题而不是按场景建题;每题定死三元组判据,禁止只留参考文本;建留出集和水印样本;最后把失败三层做成看板,读数按层分而不是只报总正确率。
洹拓把这条写成验收项:语音类能力上线前,如果评测集里没有任何一道题的判据依赖音频独有信息,那这套评测就还没有开始测语音。