
自然语言查数不是让它写 SQL:把 NL2SQL 推到可信的四道闸
业务方在自助问数里提了个问题:”某个自然月里,华东区的活跃用户有多少。”系统生成了一条 SQL,语法正确、执行成功、返回一个数字,还顺手配了一张柱状图。第二天财务月报出来,两个数差了不止一点。复盘时发现生成的 SQL 完全没有语法问题:它选了一张也含用户 ID 的宽表,用了注册状态而不是登录状态,时间边界按创建时间而不是行为时间过滤。错的是语义。
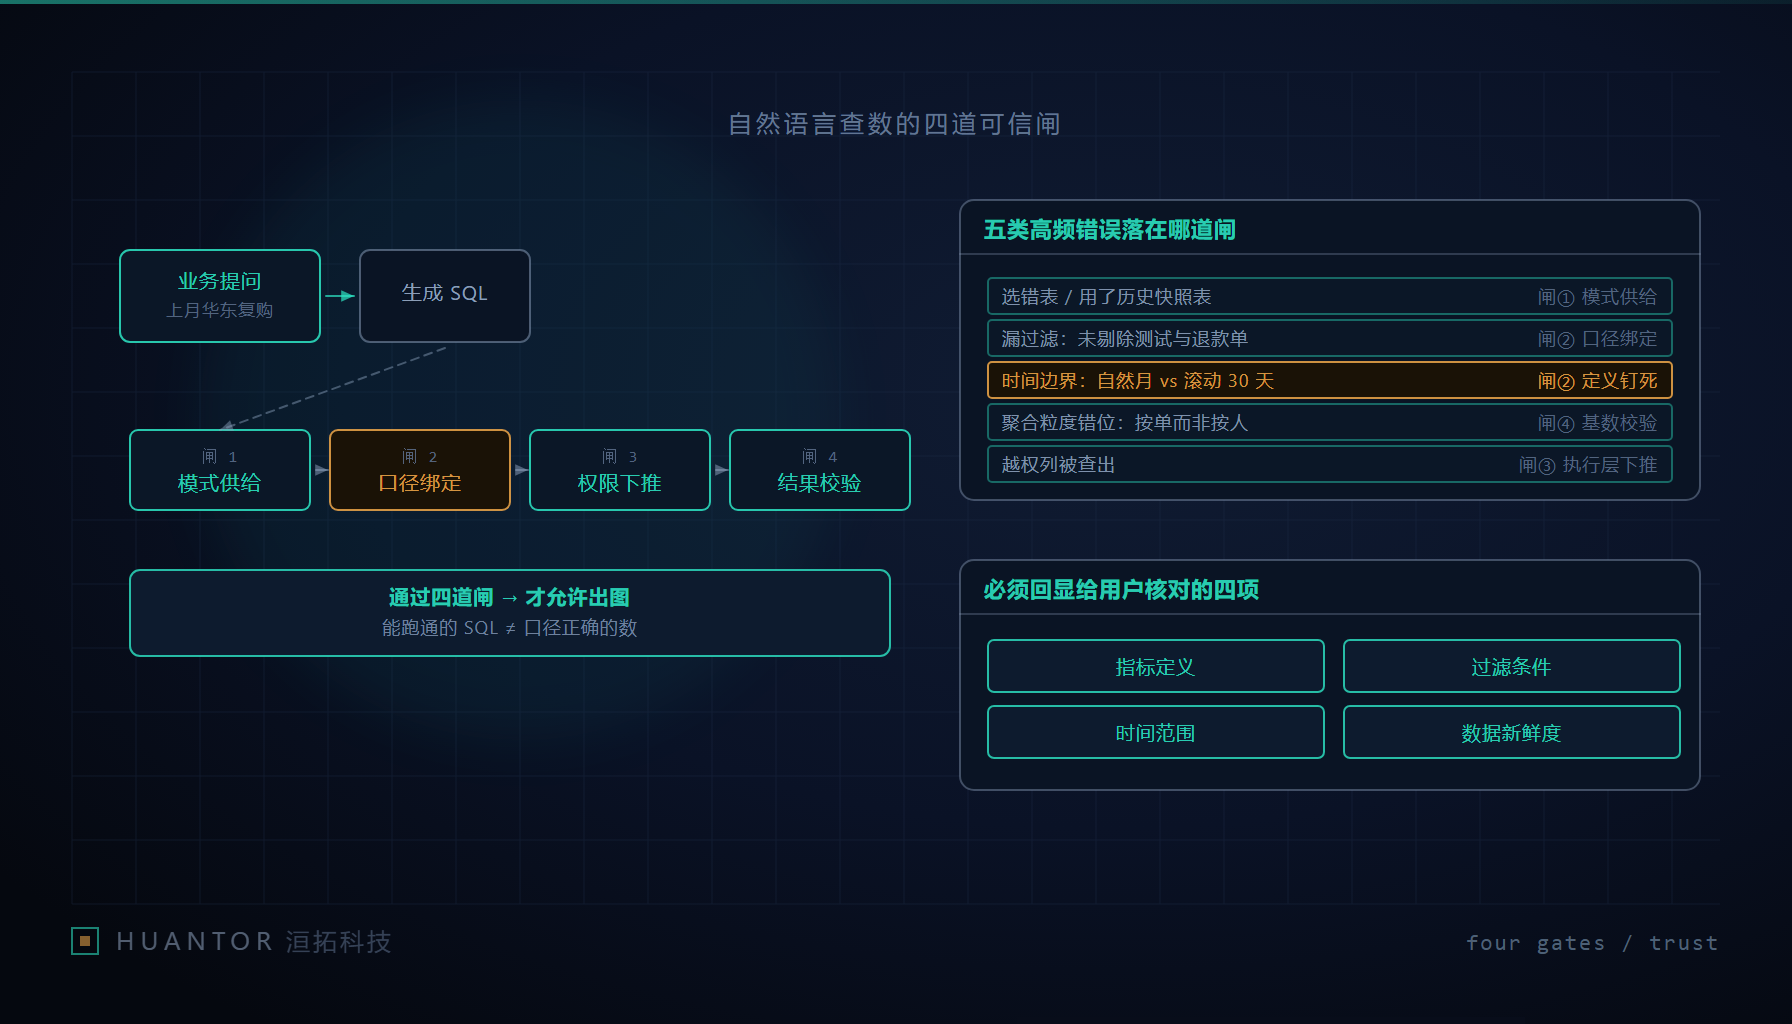
这类项目里最危险的信号恰恰是”执行成功率很高”。模型会把没治理过的库表写得很像那么回事,而图表又给数字镀了一层权威,让没被复核的口径获得决策级信任。要让它敢给人看,靠的不是提示词技巧,而是四道闸。
一、先定义什么叫”敢给人看的数”
标准只有一条:同一个问题在公司三个入口——自助问数、固定报表、BI 看板——得到同一个数,而且任何一个入口都能说出这个数的定义。做不到就不要接可视化,先去做口径。
这条定义也划出了适用边界。问数适合探索:临时拆解一个新维度、验证一个猜想、看一个从没切过的角度。它不适合替代已经定过义的报表。探索得到的结论应当走一遍口径评审、沉淀成指标定义,而不是长期留在自助通道里反复被引用。
二、第一道闸:模式供给,字段注释缺失等于放弃
给模型的表结构是整条链路的第一个收口点,要收四样东西:
- 候选集。不要把整个库的元数据都喂进去。表数量一多,同名不同义的字段就会把选择变成掷骰子。人工挑出允许被查询的对象,其余明确标注”不该用于问数”。
- 字段语义。中文名、业务含义、单位、币种、是否含税、可空原因。注释缺失时模型只能从字段名猜,而字段名恰恰是历史遗留最不一致的地方。
- 枚举值与取值含义。状态码、类型码这类整数列必须给出映射,并且要说明哪些取值在当前业务下已经不再产生。
- 时间与粒度信息。哪个字段是事件时间、哪个是入库时间,分区字段是什么,表是按天快照还是按明细增量,行粒度是”一单一行”还是”一单多行”。
给少量脱敏样例值能显著降低猜错概率,但样例必须是真的不可再识别。
没有这道闸时的故障样子:两张表都有 order_id,模型取了明细表来算订单数,于是一个多行订单被计成三单;日期字段是字符串,比较运算照跑不误,跨年区间漏掉了整整一个月;status = 2 被当成”已支付”,而在另一次迁移后它表示”已取消”。
三、第二道闸:口径绑定,模型只能引用不能自己算
“活跃用户””成交额””当月””留存”这类词,必须在系统里有唯一可引用的定义,包含分子分母、去重键、时间语义(自然月、滚动窗口还是账期)、状态过滤、币种与含税口径、默认聚合粒度。落地形态按可靠性排三档:
| 形态 | 模型被允许做什么 | 可靠性 | 附带好处 |
|---|---|---|---|
| 视图或物化视图 | 只查视图,聚合与过滤已固化 | 最高 | 权限与脱敏天然在同一对象上 |
| 语义层或指标接口 | 输出”指标引用 + 维度 + 过滤条件”,由编译器生成 SQL | 高 | 定义变更一处生效,可追溯版本 |
| 裸库表加提示 | 自由拼 SQL,靠提示词约束写法 | 低 | 几乎没有,只方便演示 |
要点是:定义变更要留版本,并且每次问数结果要能回显”用的是哪个版本的定义”。否则同一个问题在不同日期得到不同答案,没人能解释,也没人敢用。
没有这道闸时的样子:每个部门各算一种活跃,四个都对,加起来不对;月报里的成交额是含税,问数里是不含税,两份材料放到同一个汇报页上才被发现。
四、第三道闸:权限与范围必须在执行层下推
这是最不能省的一道。行级、列级权限要在执行时以调用者身份生效,或者在 SQL 生成前把可见范围展开为硬约束,由数据库或查询引擎的策略来兜。绝不能靠提示里写”不要查询这张表”——提示是建议,不是边界。
具体要落六件事:视图或公共表达式里注入过滤条件而不是在外面拼 WHERE;敏感列走动态脱敏,展示层脱敏等于没脱敏;越权访问要显式拒绝并留下记录,不要静默裁掉列让用户以为数据就是空的;服务账号不能是超级用户,它只应有被策略约束后的权限;导出、分页与聚合接口的权限口径要和查询一致,否则明细拿不到但可以按维度聚合出来;审计要同时留下”谁问了什么、命中了哪些对象、用了哪个口径版本”。
没有这道闸时的样子:一句结构合法的问题就能把所有客户手机号列出来,而系统日志显示”未拦截”,因为它压根没有拦截这一步。
五、第四道闸:结果校验与可否决的交互
执行成功不代表结果可用。上线前要有一组便宜的自动检查,检查不过就拒答而不是硬给数:
- 基数检查:结果行数与相关表基数、维度枚举数量之间的关系是否合理,出现”比总用户数还大的活跃数”直接拒。
- 时间边界检查:起止是否含端点、时区与库一致吗、跨月区间是否漏尾,边界样本要有固定回归用例。
- 量级检查:与同环比历史值比较,出现无法解释的跳变就转人工而不是出图。
- 对账样本:把若干固定指标定期喂给问数通道,与已发布报表比偏差,偏差超阈值说明口径或数据链路漂了。
- 代价检查:全表扫描、无分区限制、缺行数上限的查询先拦下,既防错也防把库拖垮。
交互层的责任同样明确。结果旁边必须用人话回显翻译出来的口径:用了哪个指标定义、哪些过滤条件被加上、时间范围与粒度、数据截止到哪一刻、当前身份能看到哪一部分。再给一个”改一改再问”的入口,让用户能否决——把模型的假设摊开,用户才有机会说”我要的不是这个”。这一屏文字的价值高于图表本身。
六、洹拓视角:按口径正确率评测,上线后盯三个数
评测集要从真实提问里抽:工单、群里的临时需求、报表评论区的追问,都是好来源,自己编的问题会系统性偏简单。打分要按”口径正确率”而不是”执行成功率”,两者可以相差很远——一个稳定产出错误语义的系统,执行成功率接近满分。金标准答案要由熟悉业务的人标注并注明定义版本,且随业务口径变化重新标注,否则评测集会悄悄腐坏成一套过时的正确答案。
五类高频错误与归属:
| 错误类型 | 典型表现 | 落在哪道闸 | 兜底动作 |
|---|---|---|---|
| 选错表 | 两张表都有 order_id,取了明细算订单数 | 模式供给 | 候选表收口,禁用对象显式标注 |
| 漏过滤条件 | 已取消、退款、测试单一起统计 | 口径绑定 | 状态过滤写进指标定义,模型只引用 |
| 时间边界错 | 端点含否不一致,跨时区差一天 | 口径绑定 + 结果校验 | 时间语义显式化,边界用例常驻回归 |
| 聚合粒度错配 | 明细与汇总关联后重复计数 | 模式供给 + 结果校验 | 行粒度写进字段说明,基数检查拦截 |
| 口径混用 | 含税与不含税相加,自然月与滚动窗口混用 | 口径绑定 | 同名只留一个定义,历史别名进映射表 |
上线后要长期看的三个数:拒答率(太低说明校验形同虚设,太高说明模式供给不足)、人工兜底次数(每次都是一条待补的口径缺口)、错数事件按影响分级复盘(每起都要落到”哪道闸本该拦住它”,并把该闸补强)。
NL2SQL 的价值不在模型会不会写 SQL,而在它引用的口径是否已经被治理。库表没治理时,它是一台把治理缺失规模化产出的机器;治理做到哪一层,问数就能开到哪一层。