
系统升级要报名:灰度批次、失败口径与回退窗口
一、报名制把灰度的字段摊开了
据公开报道,有厂商把新系统的首批升级做成招募制,可报名的机型有十几款,报名窗口开到两周多,而且报名不等于立刻收到包。这些描述只说明这件事的形状,不是下面判断的依据,我们也不去评价这套节奏本身。值得注意的是它把平时藏在发布系统里的几个字段亮了出来:谁能升、什么时候升、升不升得上、升坏了怎么办。这四件事在多数团队的正式发布里也存在,只是没人把它们写成用户可见的规则。
灰度发布的常见误区是把它当成“先发百分之几”。比例只是一个数,真正的信息在批次怎么选、每批看什么指标、什么情况下停手。报名制则是另一种批次来源:由用户自己走进来。它有一个必须写进方案的名字,自愿偏差。
二、四档批次各自能看到什么
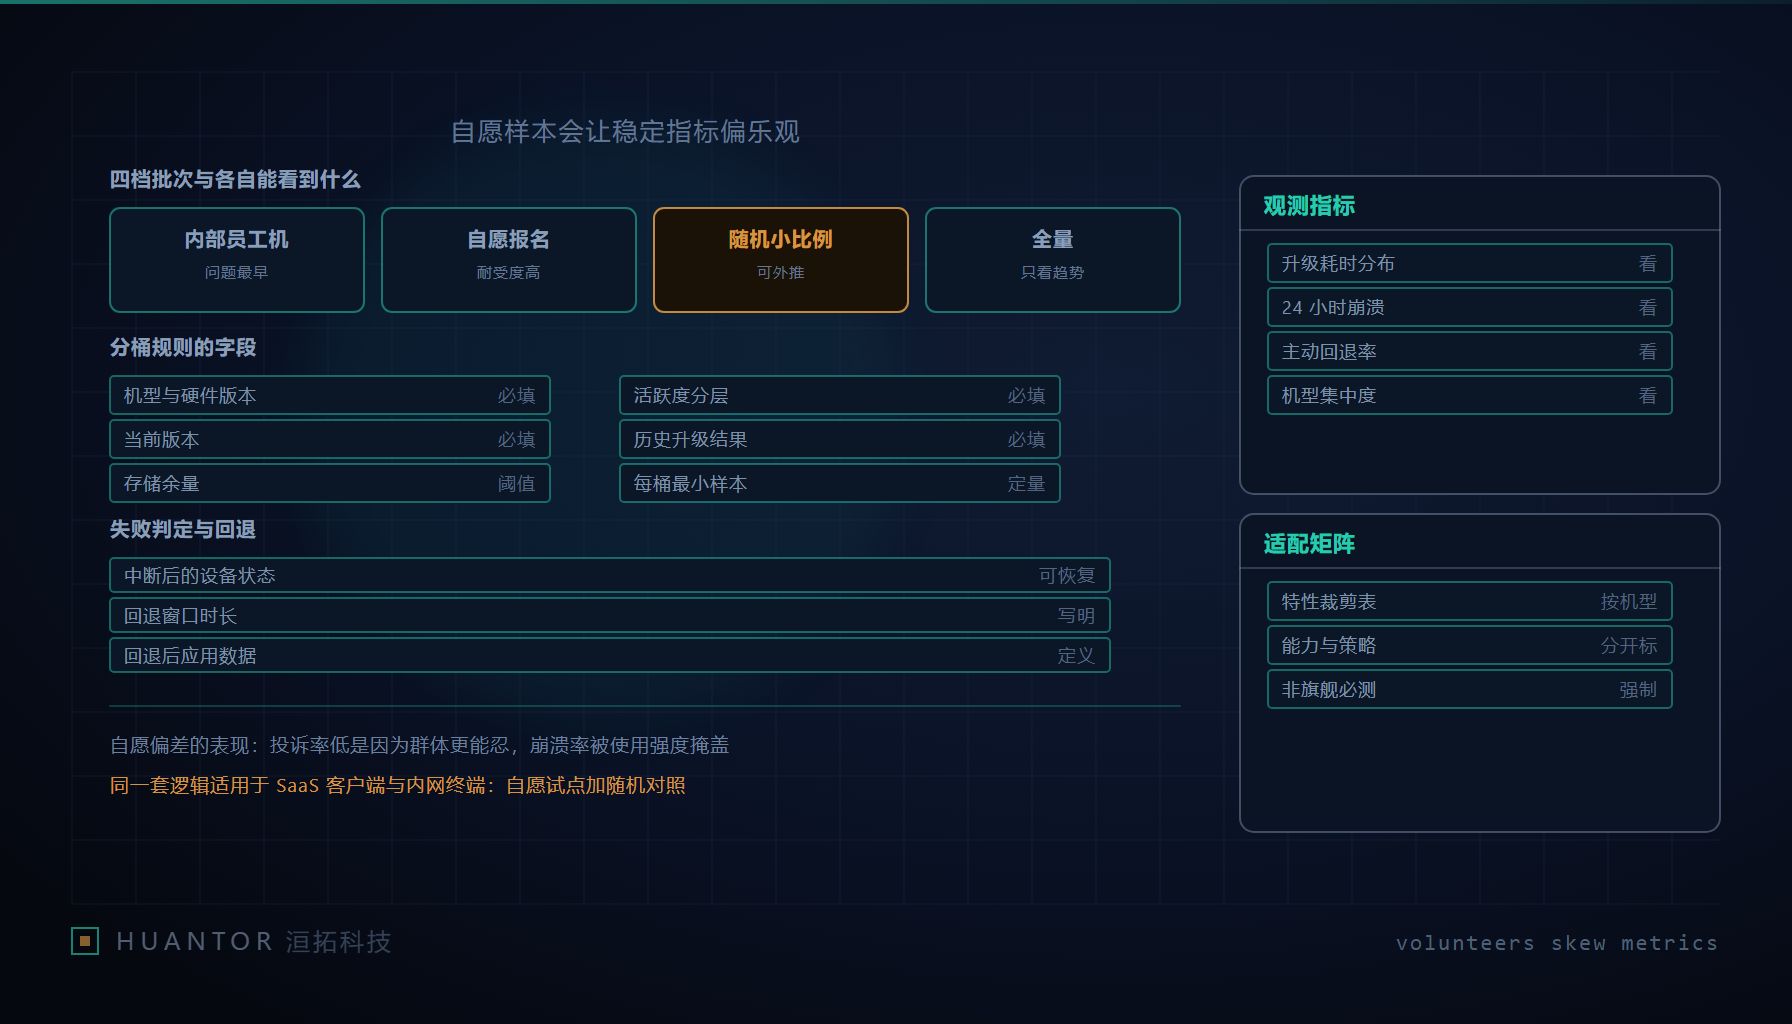
四档的推进顺序没有争议,争议在于每一档的读数能不能外推。
| 批次档位 | 覆盖人群特征 | 能可靠看到 | 看不到 | 该档的停手条件 |
|---|---|---|---|---|
| 内部员工机 | 设备多样但使用行为同质,遇到问题能当面问 | 安装链路、启动阻塞、数据迁移是否报错 | 真实网络与存储条件下的长尾 | 任一硬性失败即停 |
| 自愿报名 | 爱折腾、容忍度高、常带非常规配置 | 极端用法下的兼容问题、社区可自行复现的路径 | 普通用户的困惑与放弃 | 出现不可回退的问题即停 |
| 随机小比例 | 与全量同分布 | 留存、崩溃率、耗电、回退率的可用读数 | 低频机型与低频场景 | 指标越过预设阈值即冻结 |
| 全量 | 全部 | 真实故障面 | 已无法止损,只能补救 | 触发全量冻结后转故障流程 |
自愿档的价值很实:它是个免费的健壮性探针,专门找非常规配置的坑,比如非默认分区方案、被改动过的系统设置、极端存储余量。它的危险也很实:拿它的读数做全量决策。随机小比例这一档在报名制方案里经常被省掉,理由是“已经有这么多人报名了”。这是最不该省的一档,因为它是唯一一份与全量同分布的数据。
三、自愿偏差会把读数写成乐观
三项最容易误判的读数,机制各不相同,要分开处理。
留存与稳定性偏乐观。愿意尝新的人本来留存就高,他们不会因为一个新版就减少使用,于是“升级后使用时长没掉”这类结论在自愿档里几乎必然成立。把它当质量证据,等于把人群差异当版本差异。
投诉率低不等于问题少。自愿群体的耐受度明显更高,遇到小毛病会自己找 workaround,还会在社区里互相解答,客服工单因此安静。这恰好掩盖了普通用户会直接放弃的那类问题:设置项找不到、默认行为变了、旧习惯被打断。要在自愿档里补一类专门指标,把“用户主动回退”和“升级后关闭某功能”单独统计出来,这两个数字比投诉率诚实。
崩溃率被使用强度掩盖。尝新者操作更重、切换更快、后台应用更多,同一批崩溃在自愿档会被摊薄到不同分母上。更麻烦的是他们的设备本身偏新,硬件维度的风险被人群选择替我们过滤了一遍。所以崩溃率必须按机型与硬件版本分层看,不能只出一个总数,总数在自愿档几乎总是好看。
四、分桶字段与每桶最小样本量
分桶的目的不是圈人,是保证每个桶的读数事后能解释。字段少了,出了问题就只能靠猜。
- 机型与硬件版本:同一机型下的存储规格、内存规格要能区分,兼容性问题的分布通常贴在这层
- 当前版本与升级路径:跨多版本直升与逐版升级的中断后果不同,历史升级结果要带上一次的成功或失败标记
- 账号活跃度与使用强度:作为分层变量而不是过滤条件,用来解释留存与崩溃的分母
- 是否被改动过系统权限、存储余量、地域与网络类型:这几项决定链路侧的失败概率,也是自愿档最脏的地方
- 参与过哪一档批次:一个设备只能归一个批次,跨批混读会把对照彻底毁掉
每桶最小样本量不要拍一个统一数。做法是先定“这条指标要能区分多大的差别”,再按该指标的波动反推样本量:事件越稀有,需要的桶内样本越大;崩溃率这类要看出百分点级别的差异,桶内样本要按稀有事件的置信区间算;而“有没有出现某类从未见过的失败”这类判定,一条样本就有价值,靠的是覆盖面而不是量。桶切得过细会导致每个桶都不显著,通常控制在机型与升级路径两层交叉,其余字段只做标记不参与分桶。
五、发布窗口的工程含义
报名到实际推送之间的延迟是一件好事,前提是它被当成可控量来管理。这层延迟给了三样东西:包体分批下发时可以把带宽压力摊开,避免同一时刻大量设备回源拉包;可以在推送前复核这批设备的当前状态,把已经转卖、已经恢复出厂、存储已经吃紧的设备剔出去;留出撤回时间,规则变更或发现问题时不必把已经发出的通知再收回来。
包体下发要按批次与区域限速,并且要有明确的冻结开关:冻结之后已经在下载的设备怎么处置、已经下载完但未安装的是否继续可安装,这两种行为要提前定死,不能现场决定。撤回能力要有版本粒度,能停整条批次,也能只停某个机型段。
窗口期长短本身还影响样本质量。窗口开得很久,报名者的设备状态会漂移,推送时的实际人群与报名时的统计人群不一致,读数就带了一层时间噪声。所以报名时的字段快照要留存,推送前做一次差异统计。
六、失败判定、回退窗口与指标口径
失败要分成三类分别定义,混在一起会导致回退策略失灵。第一类是下发失败:包没到、校验不过、空间不足。设备状态保持在旧版本,无需回退,但要计数并按机型分层看分布。第二类是安装中断:写入过程中断电、恢复或异常终止。这一类最要紧的判定是设备能不能自己回到可用状态,也就是升级过程中断后是否有确定的入口和确定的复原路径,这必须逐机型实测,不能靠推断。第三类是安装成功但体验受损:启动异常、耗电异常、某类功能不可用,需要用户自己决定退回去。
洹拓给这类流程定的规则是这样几条:
- 回退窗口按批次设定并在推送前告知,窗口内允许一键退回原版本,窗口外只能走完整重刷。
- 回退后的数据口径先定义清楚:用户数据保留、应用数据按应用各自策略处理、版本升级过程中生成的派生数据要能识别并清理,避免退回后残留导致再次异常。
- 回退必须可做且被演练过,每个批次的机型抽样里至少覆盖一次真实回退,只测升级不测回退等于只测了一半。
- 全量冻结的触发条件写成级别而不是感觉:出现不可回退的变砖、用户数据丢失、核心链路大面积不可用任一项即冻结;单一机型的体验问题只停该机型段。
观测指标要成对设置,只有分子没有分母的指标不算指标。核心是升级成功率与耗时分布,耗时按机型与网络类型分层;短期窗口看升级后一整天内的崩溃与异常耗电,中期窗口看到之后一周,两个窗口要分别记录而不是合并成“升级后表现”;用户主动回退率是自愿档最重要的一个数;再补一项机型集中度,把客服与社区反馈按机型聚合,用来发现“总数正常但某一两个机型很差”的情况。
与适配矩阵的耦合在这里最容易被忽略。新特性在不同机型上要不要裁剪,要写成一张显式的裁剪表,并且标明每一项裁剪的原因是能力差异还是策略差异。能力差异是硬件决定的,测不了也绕不过;策略差异是我们自己定的,随时可能改,如果不写清,后面接手的人会把两者混为一谈,在旗舰机上测过就以为全量安全。低端与老机型的必测项要单独列出,不允许“旗舰通过即放行”。
这套逻辑并不只属于手机。SaaS 客户端的自动更新、内网终端的补丁推送,遇到的是同一道题:谁先升、按什么分布看读数、什么时候停、退得回去吗。企业客户那边把报名制换成“部门自愿试点加随机对照”就行,自愿试点部门找边界问题,随机对照部门给出可外推的稳定性和回退率,两者缺一不可。