
CC 防护别一上来就拉黑 IP:四层递进的判定线
处置现场通常是这样的:动态接口响应时间抬升,应用服务器线程池打满,数据库连接等待队列开始堆积。值班的第一反应是在安全组或防火墙上按来源地址封禁,封完之后攻击换一个源继续,而真实用户开始投诉打不开页面——移动网络、校园网和企业出口的出口地址是共用的,一个来源地址背后可能是一大片正常用户。
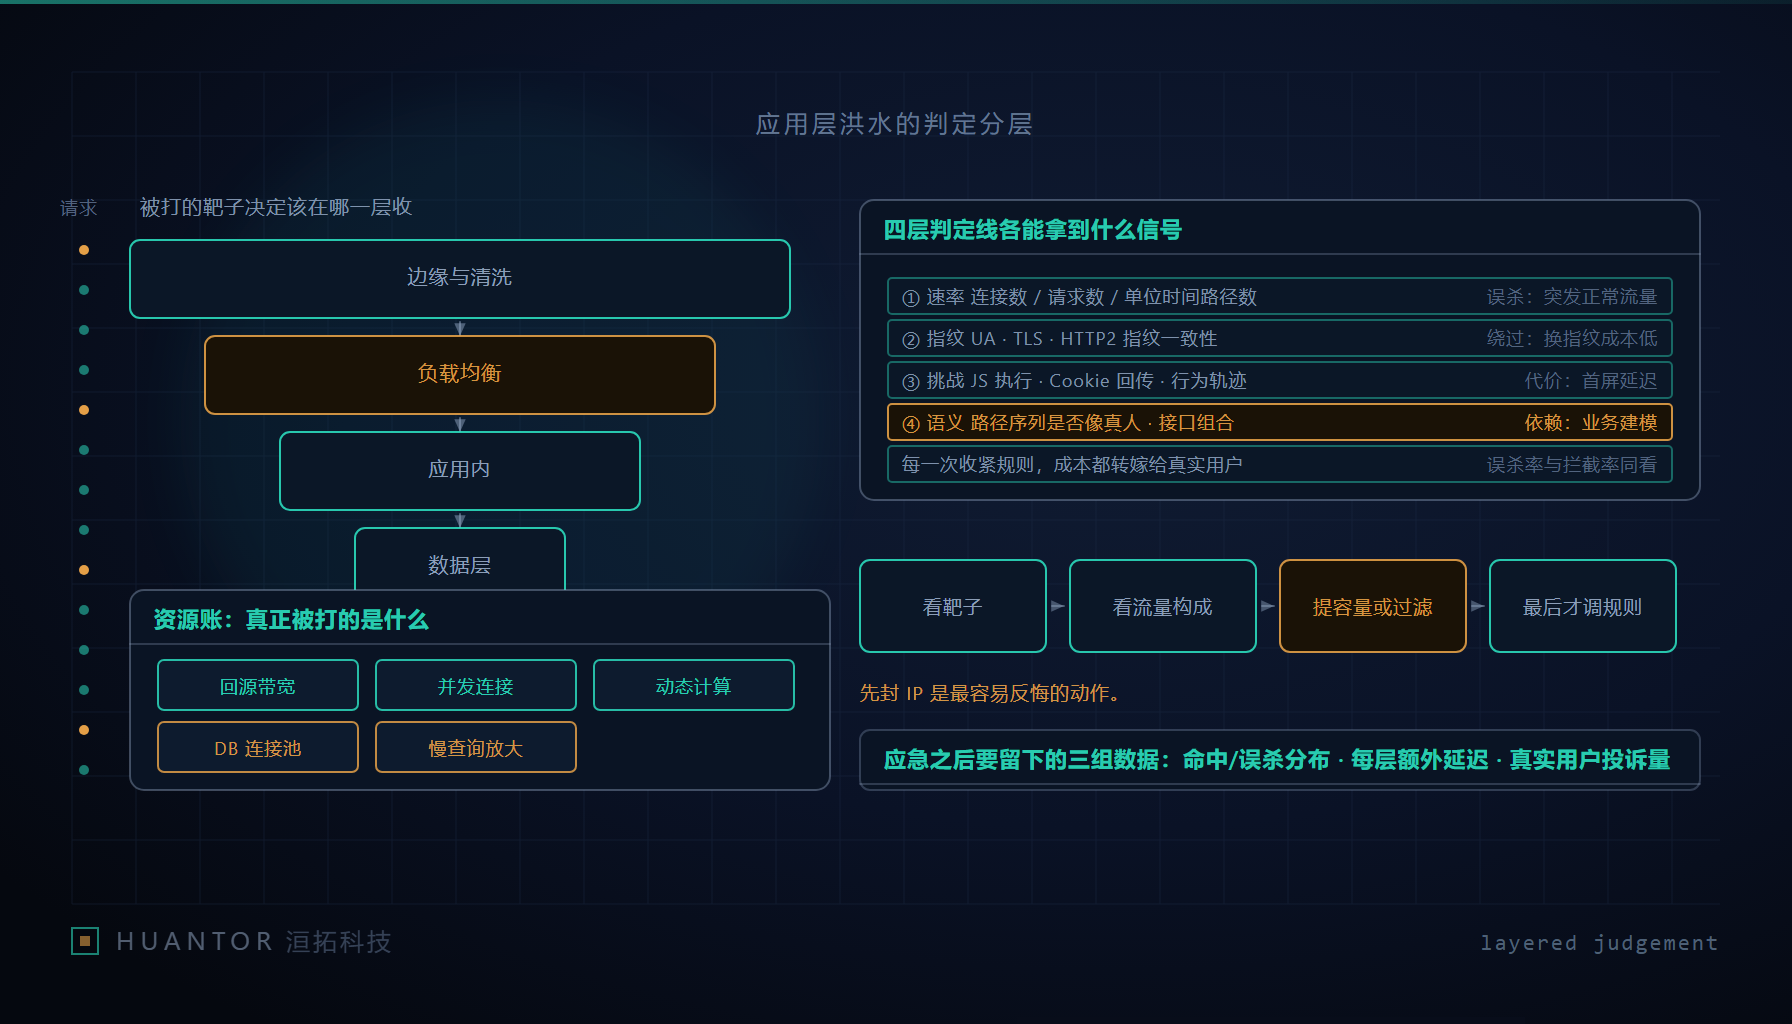
这个反应之所以容易反悔,是因为 CC 属于应用层资源耗尽,判定依据本来就不在”包”这一层。它消耗的是回源带宽、连接与握手开销、动态请求的计算能力,最终落在数据库连接池上。处理层与靶子对不上,动作再猛也只是把成本转给真实用户。
一、先把”扛住”算成资源账:靶子决定该动哪一层
不同靶子对应完全不同的处置手段,混起来谈就会出现”上了防护还是慢”。
- 静态资源与回源带宽:靶子是带宽和回源次数。有效动作是命中率与缓存策略,把请求止在边缘;过滤规则在这里收益有限。
- 连接数与握手开销:靶子是新建连接速率、TLS 握手算力、半开连接占用。有效动作在传输层与负载层,应用规则看不到也来不及。
- 应用服务器计算:靶子是线程池、协程数、序列化与模板渲染。有效动作是按接口的并发上限与排队,加上把重接口降级。
- 数据库:靶子是连接池上限与慢查询。这是最脆弱的一层,也是绝大多数放大效应的终点。
要顺手算一下放大器在哪。不分页的列表、导出全量、复杂搜索、图片原图直出、验证码前置的重查询,这几类接口给了攻击者额外的杠杆。同样一个请求,打静态页和打”无条件多表关联”,消耗的计算与数据库资源完全不在同一尺度上。
二、四层判定线各自能拿到什么信号
- 速率层:单位时间内的新建连接数、请求数、每来源地址与每指纹的请求分布、响应码结构(429 与 499 的比例上升意味着客户端在等不到时主动断开)。信号便宜、实时、无侵入。
- 指纹一致性层:用户申报的 UA、TLS 握手指纹、HTTP/2 客户端特征、请求头顺序与可接受字段,四者是否互相矛盾。关键判断是”一致性”而不是”像不像某个已知浏览器”——声明是主流浏览器却使用脚本库的握手特征,就是矛盾。
- 挑战验证层:下发一段脚本执行任务,要求回传一次性令牌 Cookie 并在短窗口内校验;后续请求带令牌就免挑战。它把成本压给不携带执行环境的客户端。
- 业务语义层:访问路径序列是否构成真实流程(有没有入口页、有没有伴随静态资源加载、动作之间有没有合理停留时长)、接口调用与页面浏览的比例、关键动作之前的行为链是否完整、账号与设备维度的历史模式。
三、每层的误杀来源、绕过成本与延迟代价
每一次收紧规则,都在把成本转嫁给真实用户。所以拦截率必须和误杀率放在一起看,单看拦截率的规则评审都会通过。
| 判定层 | 主要误杀来源 | 绕过成本 | 延迟代价 | 适合先动的位置 |
|---|---|---|---|---|
| 速率 | 正常突发:开工打卡、活动开始、定时任务集中回调、合作方批量同步 | 低,把请求摊薄到更多来源与更长时间片即可 | 几乎为零 | 边缘与负载层,第一道削总量 |
| 指纹一致性 | 老旧设备与旧 TLS 库、企业代理改写请求头、内嵌容器与小程序环境 | 中,需要实现完整的握手与请求栈,但可批量维护 | 无额外往返,仅握手期可测 | 边缘,配合白名单豁免 |
| 挑战验证 | 无浏览器环境的合法客户端:App 内调用、脚本任务、终端设备 | 中高,需要真实渲染环境或托管执行 | 多一次跳转与脚本执行时间 | 页面类入口,API 入口慎用 |
| 业务语义 | 用户直接命中深链接、外部分享直达、合法的批量导出与报表 | 高,要模拟完整业务流程与停留节奏 | 取决于观察窗口,可做到无感 | 应用内,只有这里看得见身份和流程 |
四、限速放在哪:边缘、负载均衡、应用内都要有一层
三个位置的职责不同,不是替代关系。
边缘做总量削减:命中缓存的请求不应该进入任何判定逻辑;未命中的按来源地址与指纹做速率上限,把明显的洪水挡在回源之前。这层规则的优点是更新快、覆盖广,缺点是看不到业务语义,也不知道这个请求属于哪个已登录主体。
负载均衡层做连接与握手的账:新建连接速率、并发上限、半开连接清理、TLS 卸载的算力余量。这层的价值在于它先于应用消耗发生,规则写得再细,应用层也扛不住每秒数万次握手。
应用内必须留一层,理由有两条:边缘规则覆盖不到业务语义,只有这里知道接口代价、调用主体和当前队列水位;而应用单独扛又会被连接数与握手开销先拖死,等不到业务判定生效。应用内的限流要按”主体 + 接口”两个维度设,重接口单独配额,超配优先排队和降级而不是直接返回错误码——把请求排住,比把它弹回去再让客户端重试更省资源。
五、缓存、降级与数据库这条最脆弱的链路
战术价值最高的三件事都在减少”每次请求都算一遍”:
- 未登录路径与低频变动内容做短缓存;把可共享的动态页静态化一小段时间。缓存时间不必长,只要覆盖住同一对象被反复请求的节奏,就足以把放大效应消掉大半。
- 重接口排队而不是并行放大:同一查询参数的并发请求合并成一次执行,导出类任务转异步出任务号,报表类接口按分钟粒度提供快照。
- 读写与重量分离:分析型查询走只读副本,与交易写入用不同账号、不同连接池、不同超时。攻击打的是查询接口时,不应把交易写入一起拖下水。
数据库侧要检查四个具体项:连接池上限是否显式设置(不设上限等于把排队交给数据库,随后是所有事务集体超时);慢查询在并发下是否形成锁等待放大;重查询是否有强制的返回行数上限与扫描代价限制;关键写入接口是否幂等——一个非幂等的下单接口,在重试风暴里造成的业务损失远大于性能损失。可被放大的接口改成幂等且低成本形态,这属于架构问题,不是防护层能补的。
六、洹拓视角:应急动作的正确顺序与复盘留档
处置顺序错了,后面的动作全在反悔。正确顺序是:
- 先定靶子:看被打的是静态还是动态、是应用还是数据库,看流量构成(来源分布、接口分布、UA 与指纹的集中度)。
- 再决定是”提容量”还是”过滤”:真实业务增长与热点带来的高并发,用过滤只会误杀;纯消耗型流量提带宽只是延长被消耗的时间。
- 用代价最低的层先削总量:缓存与命中率优先,其次速率与指纹,最后才到人机挑战。
- 封禁类动作放在最后且范围尽量小,并设定自动过期。默认长时间封禁来源地址是最容易反悔的动作,因为它同时依赖”地址与主体一一对应”这个在移动网络下不成立的假设。
- 规则变更留灰度:只观察不拦截跑一段时间,拿到命中样本再放开。
- 全程保留原始请求样本,事后要能复现”这条为什么被拦”。
挑战方式也有体验边界:低风险路径用静默指纹,高价值动作前才弹显式验证;机器对机器的接口不该走人机验证,而应走请求签名与凭证,否则一定逼出”给内部脚本开后门”的土办法,防护规则当场失效。
复盘至少要留三组数据:每层规则的命中量与误杀分布(用真实用户投诉与工单量做反向指标,而不是只看拦截数)、每层引入的额外延迟、以及资源水位在被拦前后各是什么。另外要留一条边界判断并写进整改项:哪些类型不是防护层能解决的——可被放大的重接口、缺上限的查询、非幂等的写入、把全量导出放在同步请求里。这几项要在架构上收手,靠规则长期顶着只会让误杀率越调越高。抗攻击能力是资源隔离加判定分层的结果,不是某一台设备的效果。