
周产量翻了十倍,人形机器人量产缺的不是产线
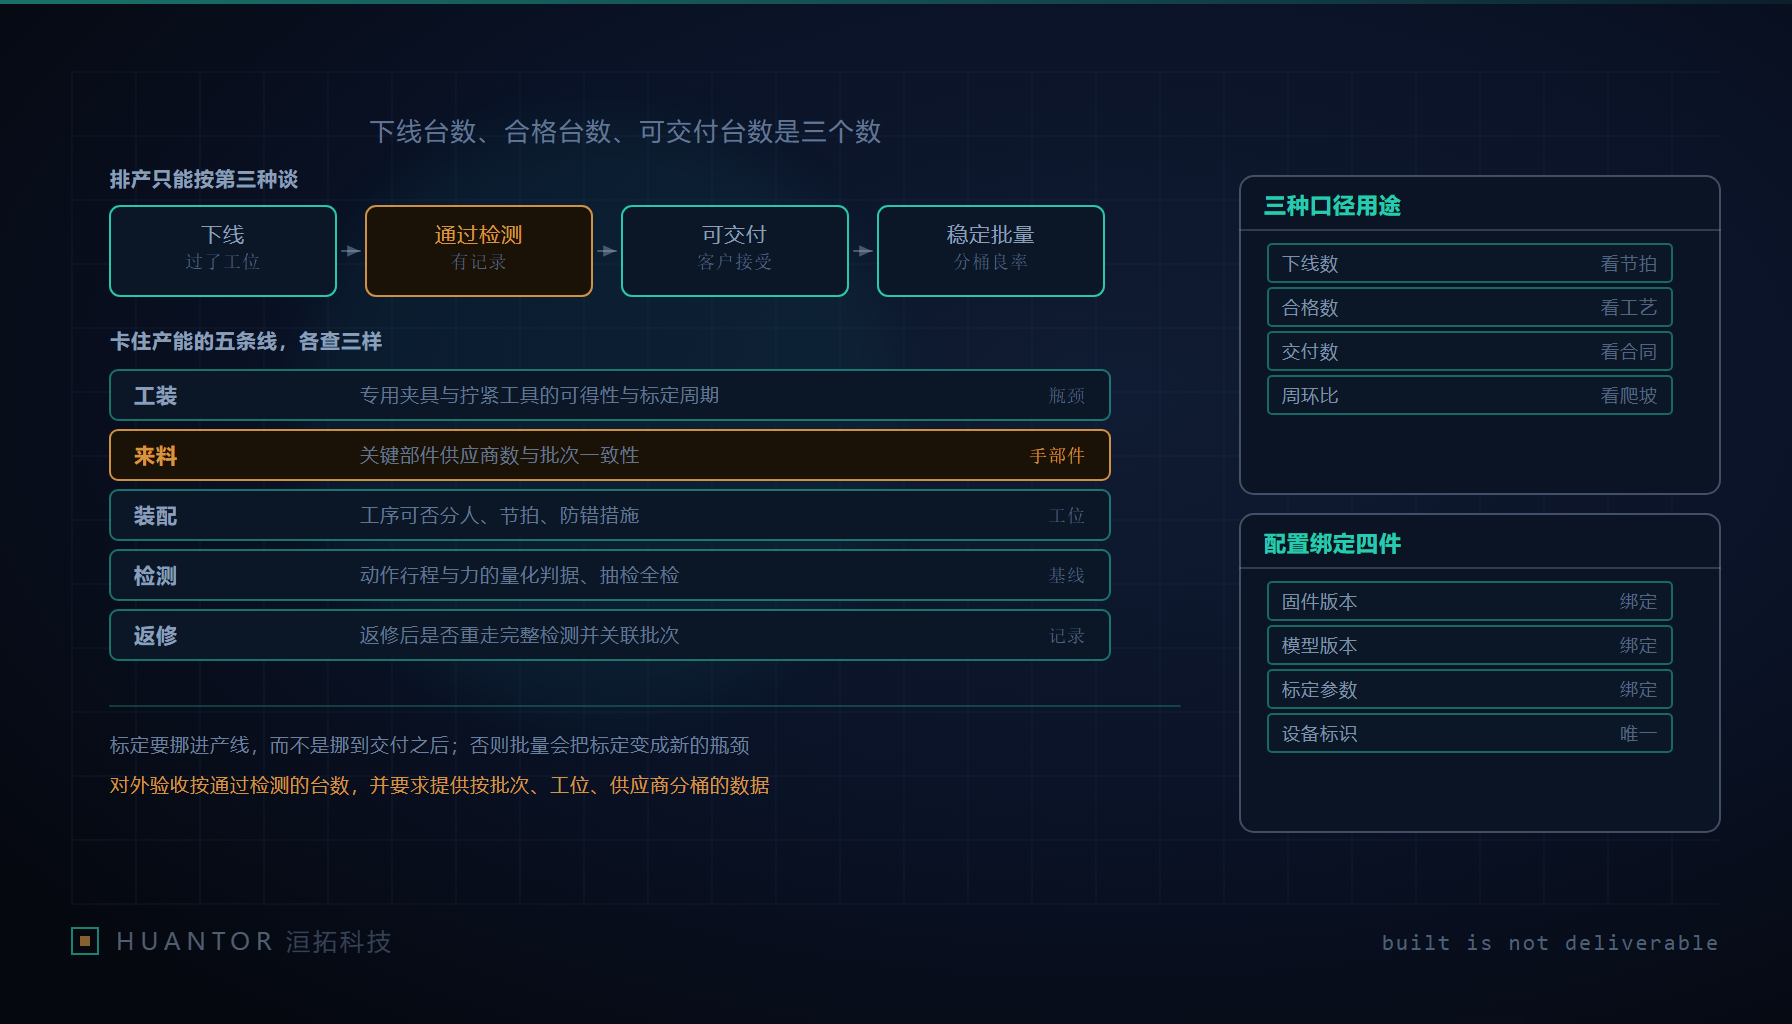
一、产量口径有三种,只有最后一种能拿来排产
据公开报道,一家人形机器人厂商把周产量提了一个数量级。这个倍数我们不作为本篇判断的依据,它只提醒一件事:不写清口径的产量数字,等于没写。同一个”周产多少台”,至少藏着三种不同的数。
- 下线数量:从产线末端推出来的台数,只说明”装完了”,不说明能不能用。
- 通过下线检测的数量:过了出厂判据的台数,说明”这台被验过且合格”。
- 可交付客户的数量:过了全部检测、做完老化与配置下发、行为可复现的台数。
爬坡期最典型的现象,是下线数量的涨幅远大于可交付数量的涨幅,差额全变成堆在检测区的返修品。排产计划和对外的承诺,只认第三种。拿第一种排产,等于把不稳定直接转嫁给客户现场。
| 口径 | 能用来做什么 | 不能用来做什么 |
|---|---|---|
| 下线数量 | 看产线吞吐、发现堵在哪道工位 | 对外承诺交付、算齐套 |
| 过检测数量 | 看检验通过率、评估返修压力 | 代表客户能直接用 |
| 可交付数量 | 排产、交付承诺、履约 | —— 这才是唯一的排产依据 |
二、手部这类部件难产,难在”没法用一个指标验收”
报道同时点明,手部一类的复杂部件仍是量产难点。这不是因为它贵,而是因为它同时踩中了量产里最难验收的几个特征。
一个执行器总成往往有几十上百个零件,零件数一多,公差链就长:每一环看着都在允许范围,累积到指尖可能已经超差。装配自由度多意味着很多配合靠手法,样机阶段手法无所谓,批量阶段手法不可复制。来料一致性一旦抖动,装配合格率就跟着抖,而这还未必是装配的错。装完也不是终点——每台都要做零位与力的标定,标定没做完这台就还不算”能用”。更要命的是验证:要判断这只手对不对,得有专门工装和一整套动作集(不同材质、不同形状、反复多次抓放),量产线不是”造得出”就行,是”造得出还得测得出”。凡是这类无法用单一指标验收的部件,爬坡时都会变成瓶颈。
还有一点常被忽略:这类部件的装配质量很难被下游工序自动纠正。螺钉没打到位、线束没理顺、预紧不均,在后面的工位不会被暴露,只会在动作测试甚至客户现场才显形。这意味着爬坡期的手部总成要做全数或接近全数的功能测试,抽检在这里省下的那点成本,会以远高于此的返修和现场故障还回来。
三、卡产能的是五条线,不是一条产线
把一次整机批量爬坡拆开看,真正决定节拍的是五条各自独立的线,任何一条掉链子,整线跟着等。我们做交付检查时按这五条列清单:
| 线 | 关键检查项 | 卡住时的表现 |
|---|---|---|
| 工装 | 专用夹具、定扭矩工具的可得性与标定周期 | 工位等夹具、扭矩工具过期不敢用 |
| 来料 | 关键部件的供应商数量、批次一致性 | 单点断供、合格率随批次抖动 |
| 装配 | 工序能否分人、节拍与瓶颈工位、防错措施 | 一个工位成节拍瓶颈、错装流入下道 |
| 检测 | 动作行程与力的量化判据、抽检还是全检、对照基线 | 判据不量化,检测沦为”看着还行” |
| 返修 | 返修后是否重走完整检测、记录是否与批次关联 | 返修不重测即出厂、来料问题定位不到 |
工装和来料这两条最容易被低估:夹具与标定工具的产能,本身就是隐性瓶颈;关键部件只有一个供应商时,所谓爬坡是建立在一条随时可能断的线上。
每条线上又各有常见误区。工装这条,很多人只备了夹具没备标定工具,或者标定工具过了溯源周期还在用,那测出来的扭矩本身就不可信。装配这条,要盯节拍瓶颈和防错:能不能把复杂动作拆成几人并行、装反或漏装有没有物理或传感上的防呆,决定了一致性能不能守住。检测这条,关键是把”合格”写成可量化判据——动作行程到没到某个范围、指尖力落在哪条带、反复多少次不衰减,并配一台状态已知的对照机做基线,否则判定会随人的手感漂移。返修这条,返修后的机器必须重走完整下线检测,不能补一下就放行,且返修记录要和批次、供应商绑定,才可能在几十台返修里看出是不是同一批来料在闹。
四、每台都要标定,批量下标定得挪进产线
样机阶段一台台手工标定,无所谓;一天要出几十台,手工标定立刻变成最堵的工位。这件事的正确解法是把它从”产线外的收尾”变成”产线内的一道工序”:把零位与力的标定做成固定工位,配标准件和标准动作集,设备到位自动跑、自动判,标定结果直接写进这台设备的档案与配置。凡是把标定推到”交付到客户现场再调”的,等于把产线欠下的账转移给买方——现场既没有标准件也没有对照基线,调出来的东西不可复现。
把标定挪进产线还不够,标定工位自己也要被管起来:标准件会磨损、对照动作集要定期再确认、标定时所处的温度要一并记进档案,否则”每台都标了”却没人保证标得对不对。标定不合格的机器走返修还是走降级,也要在爬坡前定好规则,不能到了线上临时拍脑袋,一临时就要么积压要么放走。
五、良率要分桶记,别只报一个总数
单一总良率会骗人。爬坡期要按批次、按工位、按来料供应商分桶记录,哪一桶掉,线索就在哪:某供应商批次明显掉,问题在来料;某工位单独掉,问题在装配或工装;所有桶同步往下走,多半是工艺漂移。至少留这几个字段——设备标识、批次号、装配工位、关键部件供应商及批次、下线检测项与结果、标定参数版本、返修次数及返修后的复检结果。洹拓给客户做产线看板时,坚持不给”一个总百分比”,只给分桶:总数好看但分桶糊在一起,等于在最该发现问题的阶段把眼睛蒙上。
分桶也不是越细越好。桶切得太碎,每桶样本量不够,算出来的良率只是噪声。务实做法是先按最能解释变异的那几个维度分——供应商批次、装配工位、关键部件版本,等某一桶出现明显异常再往下拆。分桶的目的是定位,不是把总数切成一堆看不出名次的百分比。
六、配置下发与对甲方的验收口径
整机批量还有一件容易被忽略的事:每台设备的固件版本、模型版本、配置文件和标定参数,必须和设备标识绑定入库。不绑定,”同一型号”的机器会表现出各自不同的行为,现场排查时分不清是硬件差异还是配置差异,越查越乱。配置要么在产线内下发完成并回写档案,要么配一套现场可复现的下发与校验工具,两条路都要走到”任意一台都能追溯它当刻的配置”。
下发之后还要能校验:设备回读自己的固件与模型版本、关键标定参数,和档案里的期望值逐字段比对,比对不过就地拦截,别让”装了但没验证”的机器流出去。新版本的固件或模型也不要一次性全量刷,先在一小批上跑一段下线检测和动作集回归,确认不改变已验证的行为再放量——这条灰度逻辑和软件发布其实是同一件事。把设备标识和版本绑牢,现场出问题才有清晰的定位路径:先落到”这台、这个版本、这套标定”,而不是把同型号机器整体怀疑一遍。
给甲方一条可执行的验收口径:不要按”下线了多少台”验收,而按”通过了哪几项下线检测的台数”验收,并要求对方提供至少按供应商和工位分桶的数据。只看下线数,就是把爬坡期还没做完的工装、来料、返修这三条线的债,全部接到了自己名下。