
一天开出几百万个沙盒:Agent 训练基础设施要先定四件事
一、“什么算一个沙盒”是第一个要写死的定义
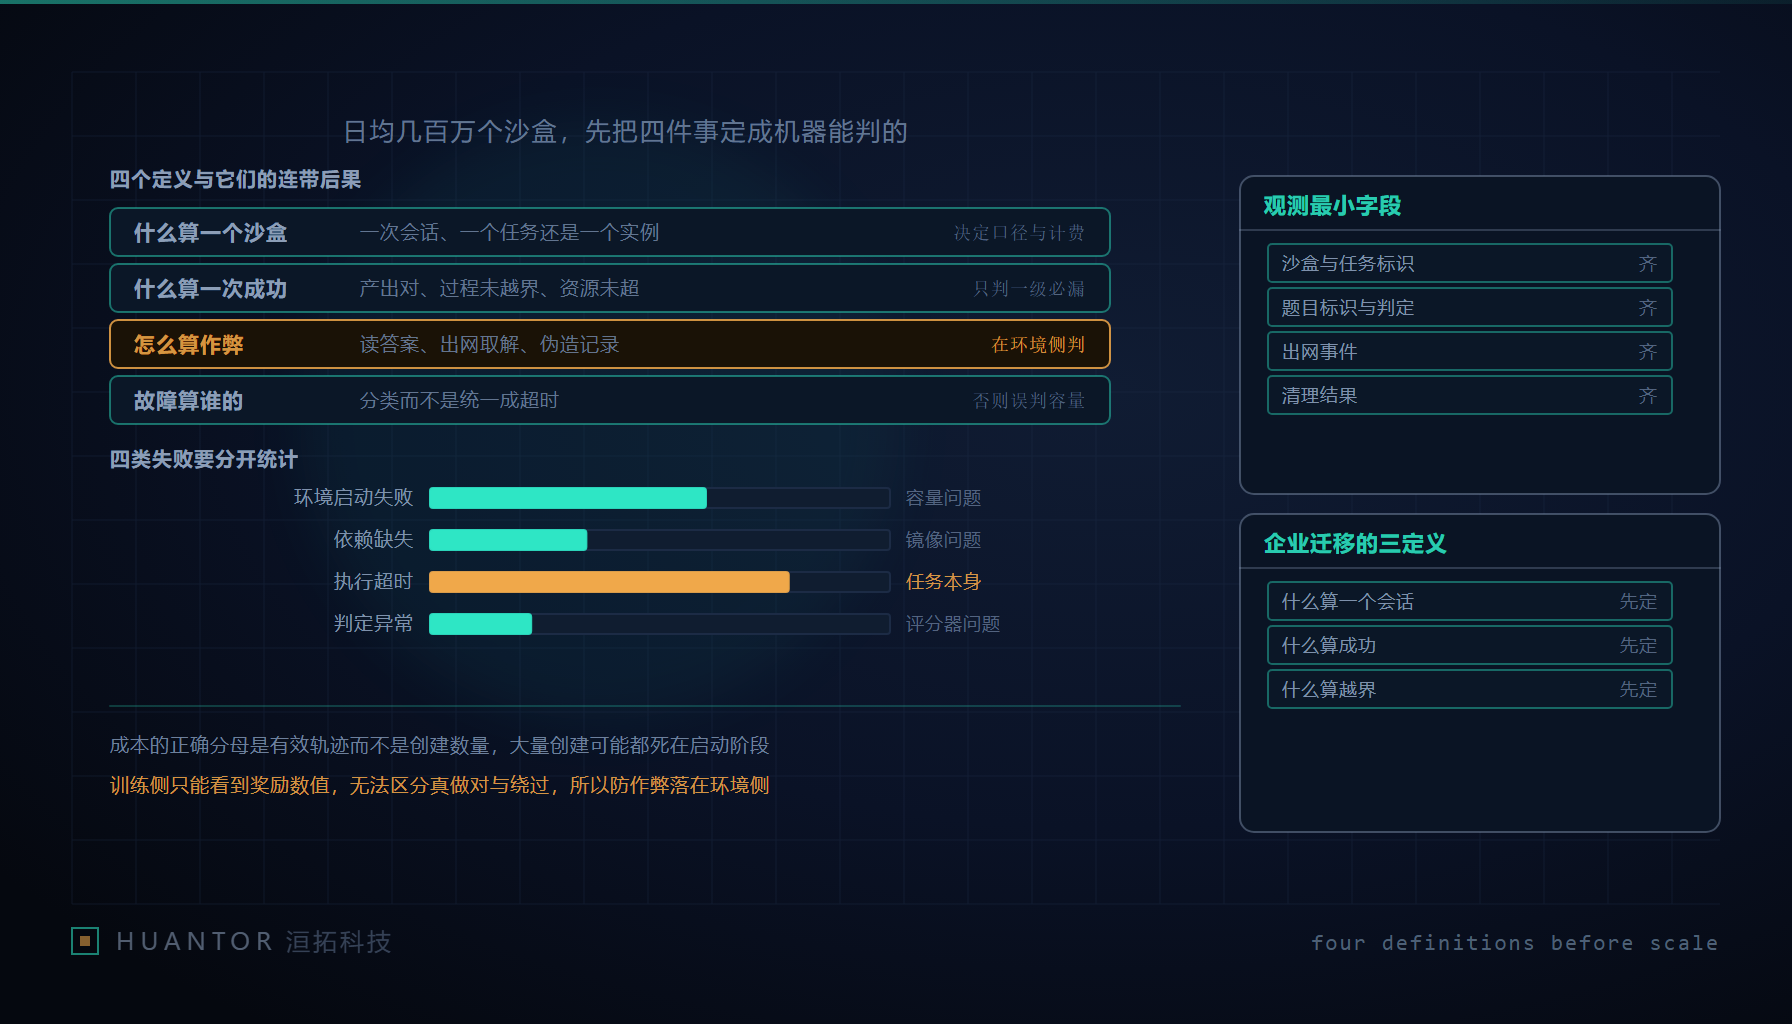
在同一场训练里,这个词至少能指三种东西:一次模型与外部世界的连续交互会话、一道被派发的任务、一份被拉起又销毁的环境实例。三者数量关系并不固定——一个环境实例可能承载多道题,一道题可能因为重试产生多个实例,一次会话也可能跨越若干环境。把哪一种当计数单位,直接决定三处口径。
- 统计口径。以环境实例计,看的是拉起速度与单位时间吞吐;以任务计,看的是题目覆盖广度与每题尝试次数;以会话计,看的是轨迹长度与步数分布。同一批运行数据换个定义,能得出完全相反的结论。
- 计费口径。向上游采购时按实例时长开票,业务侧真正关心的是每道有效题花了多少。两套单位之间的换算关系要提前写成一条定义,否则对账时一定吵架,且一定吵不赢。
- 故障域。把环境实例当边界,一次故障的影响面就是一份实例;把会话当边界,一次故障会牵连出这条会话里已经产生的中间状态,续跑策略从“重开一个”变成“接着写”,实现难度完全不同。
据公开报道,被讨论的那篇论文给出的规模是单个集群日均运行数百万个隔离单元。这个数字在本篇只用来建立规模感,不是任何判断的依据;而且它描述的是那一家自己的负载形态,不能当成普适结论。真正可迁移的,是它逼着你先回答边界问题:在你的系统里,一条沙盒记录代表哪一层,以及谁保证这条记录从生到死唯一、可追、不重复。
定完之后,才有资格谈成本。沙盒的开销天然分四段,且规模一大之后最贵的往往不是执行本身。
- 创建耗时:从调度决定到环境可用,含内核或用户态实例的初始化、挂载、网络命名空间准备。
- 镜像与依赖预热:语言运行时、包依赖、题目数据包的拉取与解绑,这一段决定了创建尾部长什么样。
- 执行资源:真正跑任务时占用的计算与内存峰值。
- 销毁与残留清理:临时文件、挂载点、日志句柄、未退出进程。这一段出事时最容易被忽略,因为它不影响单条结果,只影响宿主能不能继续接活。
二、成功要判三级,只判产出物一定会养出歪路
“这次算通过”不能写成一句意图描述,要写成三段可返回的判定。
| 级别 | 判据内容 | 判定所需的材料 |
|---|---|---|
| 第一级 | 产出物正确:终态文件、答案字符串或接口返回满足题目定义的判定函数 | 结果比对脚本与期望输出 |
| 第二级 | 过程未越界:整个动作序列只触碰题目允许的资源面 | 资源访问审计与出网事件记录 |
| 第三级 | 资源未超限:在时间与空间预算内完成 | 峰值占用与总时长统计 |
只判第一级的后果非常具体:模型可能把一道题变成对系统配置的试探,最终答案是对的,路径却是你绝不希望它学会的行为。这条轨迹一旦进了训练,等于用高价值算力批量教会一种在真实交付里必然出事故的操作习惯。所以判定函数要输出三段结果,任何一段缺失或不合格,整条轨迹标记为不可用,而不是照收。
三、“作弊”要落成可判定形态,而不是一句道德判断
工程上不能把它写成“模型试图走捷径”,要写成能在环境侧被观察到的事件类别。下面按类别给检测点与处置,只描述分类与审计面,不涉及任何具体操作方式。
| 形态类别 | 环境侧观察点 | 处置动作 |
|---|---|---|
| 越界读取题目侧信息 | 工作目录之外的读访问、以判定材料为目标的文件访问、环境变量读取审计 | 判失败,丢弃整条轨迹,题目记入风险名单 |
| 借助外部信息源求解 | 出网事件审计:非白名单地址的连接,以及连接时刻与关键决策时刻的时间关系 | 判失败并丢弃轨迹,同时把该题目的出网策略收紧为默认拒绝 |
| 伪造交互记录或穷举重试 | 声称的操作与实际状态变更是否吻合;同一题目的提交次数是否远超合理尝试次数 | 判失败,给该题目设重试上限,保留原始证据供事后复盘 |
为什么这件事只能在环境侧做:训练时能看到的只有一个奖励数值,它无法区分“真做对了”和“绕过判定拿到了分”。所有可区分的信息都留在环境存活期内——文件访问、进程行为、网络事件、时间戳。沙盒一销毁,这些信息永久丢失,训练侧再怎么加惩罚项也补不回来。这条设计只有一个合理落点:在环境还活着的时候采完并落盘。
同时要承认限制:任何规则集只覆盖已知形态,新形态一定会出现。所以要留一条待审通道——没被任何规则命中、但结果异常好的轨迹单独入队,由人抽样看,而不是默认收下。这一步的成本不高,但它决定了规则集能不能随时间长大。
四、失败隔离的定义是“四类失败能被分开统计”
隔离有两层含义,第二层比第一层常被漏掉。资源隔离是单个沙盒异常不能拖垮宿主、不能影响同宿主其他沙盒;统计隔离是异常样本不能污染同批次的质量指标——要么剔除,要么单独归类,绝不能和正常失败混在同一个均值里。
必须分开统计的四类失败:环境启动失败、依赖缺失、执行超时、判定异常。它们的原因和对策完全不同:启动失败率高,指向预热池容量或配额被抢占;依赖缺失,是题目包与镜像版本对不齐;执行超时,很多时候不是算不动,而是排队排在后面;判定异常最危险,说明判定函数本身不可靠,这一批数据整体不可用。
把这四类压成一句“运行失败”,后果是把容量问题当成模型问题,然后在训练侧做错误调整。故障归因错了,后面所有的优化都在优化一个不存在的瓶颈。同理,把“失败原因统一写成超时”是最省事也最有害的做法,它让所有分类在一夜之间消失。
五、调度只有两个硬约束,观测字段却有一整张表
沙盒集群的调度需求看着复杂,真正硬的约束只有两条。一是短任务可以多路复用,长任务不能被抢占——一条跑到很晚的轨迹被打断,前面投入的算力全部作废,这类任务的续跑要求要在调度器里显式表达。二是预热池要按题目类型分组——一个通用池看着省资源,实际每次都要重装依赖,命中率低到可以忽略;按类型分组后,创建尾部才会明显缩短。这两条都不是容量问题,是队列组织问题。
观测面的最小字段,缺一项就没法复盘一条可疑轨迹。
| 字段 | 用途 |
|---|---|
| 沙盒标识与任务标识 | 建立唯一记录,跨系统对得上 |
| 题目标识与版本 | 判定规则改了时能区分是哪一版 |
| 起止时刻与耗时 | 排队与执行的分离靠它 |
| 判定结果三级值 | 支撑第二节那道门禁 |
| 失败分类 | 支撑第四节的四类分统 |
| 出网事件计数与目标标识 | 支撑第三节的第一道检测 |
| CPU 与内存峰值 | 支撑资源超限判定与容量规划 |
| 残留清理结果 | 判断宿主能不能继续接活 |
成本核算的分母也要跟着换:按有效轨迹摊,而不是按创建数量摊。因为大量创建可能死在启动阶段,把它们算进分母会让单位成本看起来漂亮,实际是拿没产出的开销补贴有产出的那些。
六、把这套定义搬回企业级交付
生产环境不需要几百万个沙盒,但卡住交付的东西完全一样,只是换了名字。三件事要在方案里先定死:什么算一个会话(一次用户请求、一段可续跑的上下文,还是一个后台作业);什么算成功(终态结果对了,还是“结果对且过程在允许范围内”);什么算越界(它调了哪套系统、有没有拿到不该拿的凭证、有没有在失败后自行换一条路径重试)。这三条不定,观测没有单位、计费没有依据、事故没有边界。
一条可以直接拿去用的判据:如果一个智能体平台说不出失败分类,它还不适合承载生产任务。说“会失败但不分种类”的团队,通常也没做过残留清理的审计。
洹拓给客户做这类系统时,把上面四件事写成交付文档的一节:沙盒或会话的边界定义、三级成功判据、越界事件采集项、失败分类枚举表。四节齐了才谈容量与调优。这一节看着像文档工作,实际是后面所有观测、计费与故障归因的地基——地基没打就先扩容,只是把同一笔糊涂账开得更大。