
用例顺序打乱一次,偷依赖的套件就藏不住|洹拓科技
一、固定顺序全绿掩盖了什么
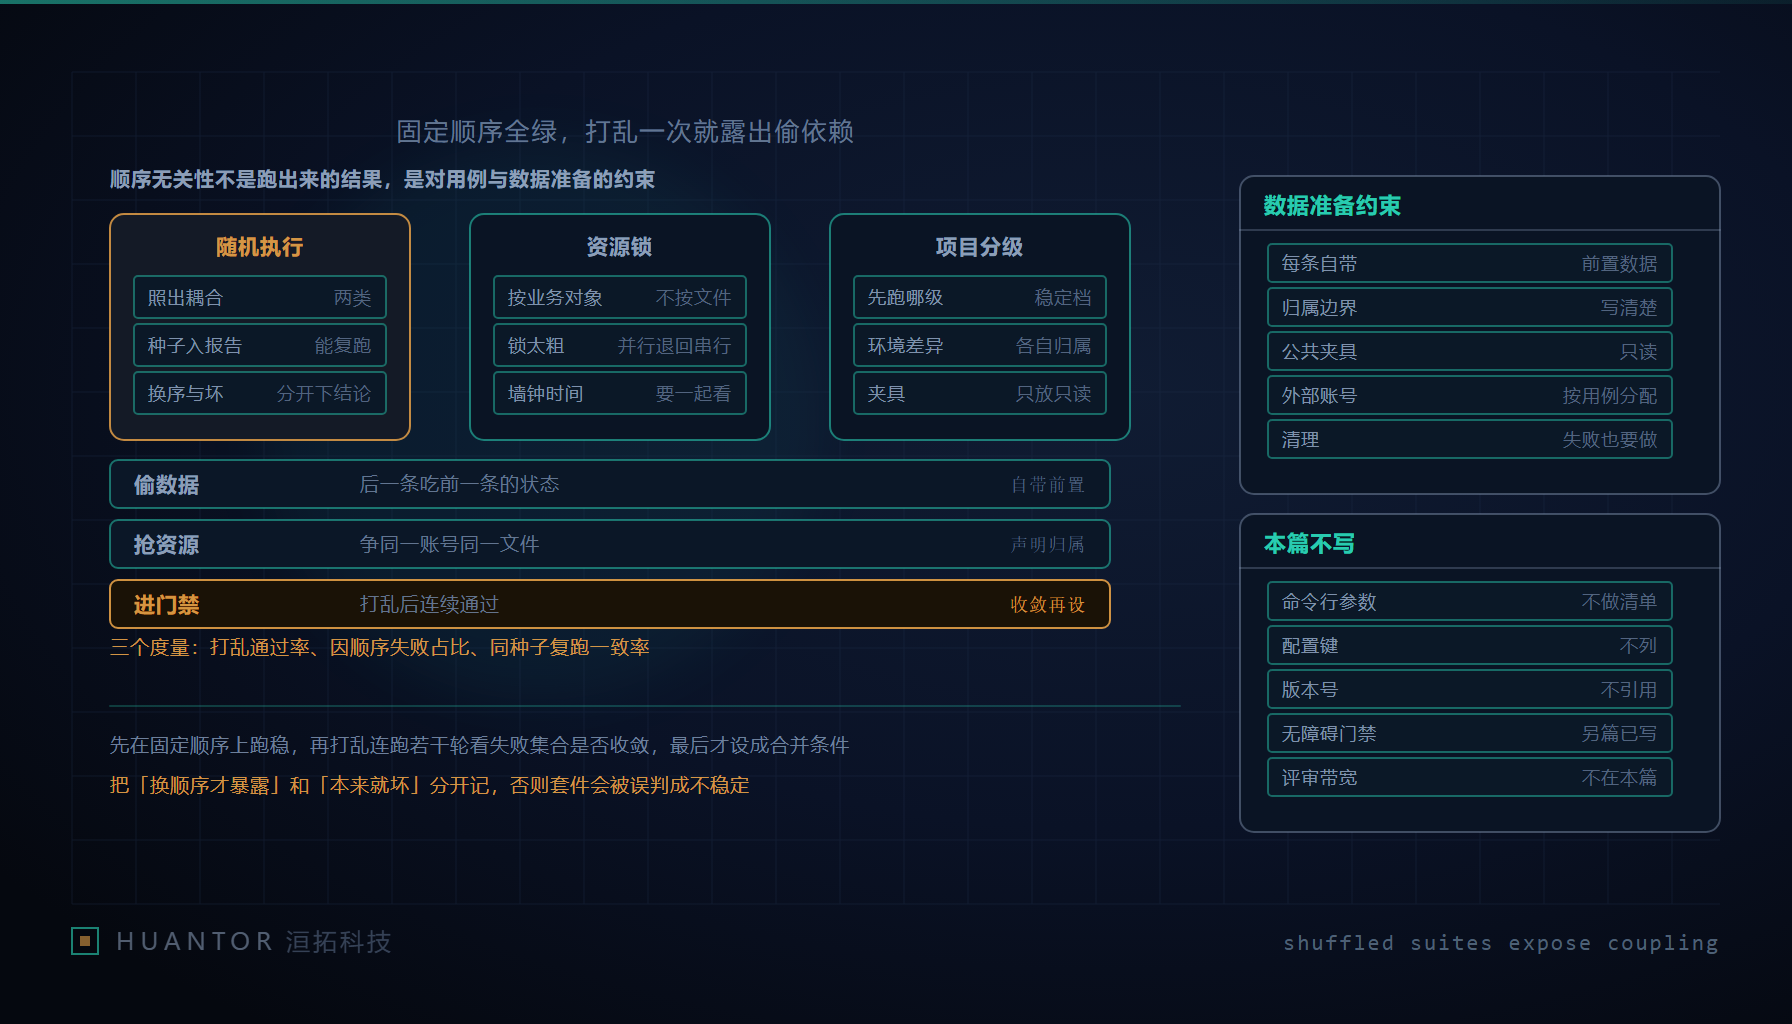
一套端到端测试工具把三项能力摆上了台面:随机执行,也就是把用例顺序打乱再跑;资源锁,声明同一份资源的用例串行执行;项目分级,让不同稳定要求的用例待在不同档位。这三项能力指向同一个顽疾:套件按固定顺序跑一直是绿的,实际却脆弱得很,业务代码改一点,就有一片用例跟着倒。
要先把立场说清楚:顺序无关性不是测试自己跑出来的结果,而是对用例设计与数据准备的约束。打乱顺序只是把“这层约束有没有被遵守”照出来。按固定顺序执行的套件,真正验证的东西往往是“从第一条用例排到最后一条”这条特定路径,而不是每条用例各自成立。执行历史把同一序列写死之后,前面用例顺手创建的数据、悄悄改掉的状态,会被后面用例当成理所当然的前提。这种套件在功能回归上给出的绿灯并不值钱,因为它连“换一条执行路径”这个最低要求都经不起。
二、偷数据与抢资源是两类病
打乱顺序后冒出来的报错,大致分两类,治法完全不同,混起来治会两头落空。
第一类是偷数据:后一条用例直接依赖前一条造出来的状态。典型表现是顺序一换,报错落在“元素找不到”“记录不存在”“列表为空”这一类位置,而且失败点相对固定,总是那几条用例倒霉。根子在数据准备上:某条用例负责建,另一条只管用,两者之间没有任何声明。
第二类是抢资源:并行执行时多个用例争同一账号、同一文件、同一配置项或同一外部租户。典型表现是间歇性的,单跑都过,同时跑就打架;报错内容随负载漂移,这轮是冲突,下轮是超时。根子在资源归属上:同一份资源被多条用例同时改写,却没人登记谁在用。
两类病先用一张清单分开判定:
- 固定顺序下稳定通过、打乱后稳定失败,失败原因指向缺失的数据:偷数据;
- 打乱但单轮串行能过、开并行才失败,报错在冲突类与超时类之间漂移:抢资源;
- 换种子、换机器、换时段都稳定失败,与顺序无关:本来就是坏的,功能缺陷另立问题去修。
第三条尤其要紧。打乱顺序暴露的不全是顺序问题,把功能缺陷也记进不稳定用例的账上,治理就会朝着错误的方向使劲,改了一星期用例,缺陷还在那儿。
三、用例自带前置与资源归属
偷数据的解法是把数据准备的责任塞回每条用例:每条用例自带前置数据,自己创建、自己清理,边界写在用例声明里,旁人读得出来它需要什么、会留下什么。
公共夹具只放只读内容,比如基础字典、静态资源、不会有人改的配置。夹具一旦包含可写状态,它就成了一个全局变量:一条用例改它,所有正在断言它的用例一起漂。很多团队习惯在一轮执行开头跑一遍初始化脚本,建好一批数据留给后续用例复用,这正是偷数据的制度化形态。省下来的那点准备时间,会用成倍的分诊成本还回去。
抢资源的解法是先登记归属,再谈锁。账号、文件、配置项、外部租户这些资源,要有可声明的归属关系:这条用例执行期间,这份资源归它独占。登记在前,锁在后;没有登记,锁无处可挂,只能靠运气错开时间。
四、随机种子要进报告
随机执行如果不记种子,等于把脆弱换成另一种更难对付的东西:不可复现的失败。顺序是随机出来的,失败也跟着随机;下一次跑又是另一个顺序,报错现场再也还原不回来。
所以我们要求随机种子必须进测试报告,和它一起进去的还该有几样东西:
- 本轮打乱后的完整执行序列,用于比对两轮之间的差异;
- 种子本身,用于同种子复跑,原样还原那一轮顺序;
- 失败用例的最后一帧状态摘要,用于记录失败发生时的现场。
同种子复跑的价值不止是确认问题存在,更在于把两类结论分开下:一类是“换了顺序才暴露”,那是顺序依赖,修用例独立性与资源声明;一类是“本来就坏”,那是功能缺陷,走正常提缺陷流程。分不开这两类,就会把缺陷当不稳定用例反复重跑,也会把顺序依赖当缺陷去改业务代码。种子记录让这条分界线变成一次复跑就能验证的事实,而不是靠人猜。
五、资源锁的粒度与项目分级
资源锁的粒度要按业务对象设计,而不是按文件设计。锁的键应当是“这个账号”“这个租户”“这个配置项”,而不是“文件名里带这批字样的用例”。锁太粗,一批互不相干的用例被摁成串行,并行度直接压回从前,报表上整轮用时全线上涨;锁太细,等于没锁,冲突照旧。
要承认锁有代价:锁住之后,等锁的用例排队,墙钟时间会变长。这不是优化失败,而是买顺序无关性必须付的账。要算的是两笔:锁的持有时间能不能缩短,用例用完就归还,而不是从头占到尾;锁的集合能不能拆细,按真实冲突面划分,而不是按名字相似程度。同时守住一条纪律:锁只治抢资源,不治偷数据。给偷数据的用例加锁,只是让污染按另一种顺序发生,套件看起来更随机了,病一点没少。
项目分级解决的是另一个问题:不是所有用例都该在同一个环境档位上求稳定。核心交易链路、登录与支付这类必须长期稳定的用例,锁进高稳定档位,配专属环境和最严的门禁;长尾的、探索性的、对外部数据敏感的,放低一档,允许波动,不参与合并条件。分级同时约束依赖方向:先跑稳定档位,它的结论作为下一档的输入;低档的噪声不许上灌,去污染高档的门禁判断。
六、进门禁的顺序与三个度量
顺序无关性落进门禁要按节奏来,一上来就全量打乱,只会让合并队列被误报堵死。我们按三步走:
- 先在固定顺序上跑稳,把功能正确性与顺序问题剥开;
- 再打乱连跑若干轮,把“因顺序而失败”的用例集合逐轮统计,看它是否收敛,新暴露的失败一轮比一轮少,说明修复方向对;
- 最后把“打乱后连续通过”设成合并条件,让顺序无关从努力方向变成拦得住的规则。
配套三个度量:打乱通过率,即随机顺序下整轮全绿的比例;因顺序导致的失败占比,即排除功能缺陷之后,归因到顺序依赖的失败比例;同种子复跑一致率,即同一种子下失败用例集合的一致程度。三个数各管一段:第一个看现状,第二个排修复优先级,第三个检验随机执行这套机制本身可不可信。一致率上不去,说明种子没有真正起作用,或者失败里混进了环境因素,这时候谈门禁还太早。
在洹拓给客户做的端到端交付里,下面这张表是我们验收顺序无关性的底稿:
| 问题类型 | 表现 | 修法 | 对应度量 |
| 偷数据 | 打乱后稳定失败在数据缺失类断言上,失败点固定 | 用例自带前置数据,公共夹具只留只读内容 | 因顺序导致的失败占比 |
| 抢资源 | 开并行才失败,报错在冲突与超时之间漂移 | 资源按业务对象登记归属并声明锁 | 打乱通过率 |
| 不可复现 | 同一失败无法复跑还原现场 | 种子与执行序列进报告,同种子复跑 | 同种子复跑一致率 |
| 档位混淆 | 低稳定用例的失败拖垮合并队列 | 项目分级,先跑稳定档,低档不进合并条件 | 分档后的打乱通过率 |
打乱顺序不是万能钥匙,它照出来的债仍要一条条用例去还:数据自带、资源有主、种子可查、锁有粒度、分级有方向。这几件事做完,绿灯才第一次真正代表“每条用例单独也成立”。