
时分秒可写可不写,解析完时区还在不在|洹拓科技
一、会抛异常的解析不算事故,静默补位才是
来自遗留系统和外部报送的数据经常是这副样子:同一份文件里,有的记录只有一个四位数年份的串,有的是带各种分隔符变体的年月串,还有的带毫秒与时区写法,是完整串。年份必填,月、日、时分秒、毫秒、时区或偏移全部可选。
对付这种数据,严格解析反而运气好些:缺字段就抛异常,问题当场暴露、上游被迫去改。真正危险的是容错解析表面成功——补出来的时间合法、能排序、能入库,下游报表照常统计,可它和数据的原意差了一天或者差了几小时。没有任何一处报错,错误已经固化进了数据库,等到对账时才发现整段趋势都是补位补出来的。
洹拓在交付里立过一条原则:这类解析的产物不能只有一个值,必须是“值加一组关于值的说明”。值回答能不能用,说明回答其中哪些部分是我们替数据编的。后面所有的分层、标记、验收,都是从这条原则长出来的。
二、缺失分三种形态,处置不该共用一套代码
缺失的形态决定解析要分层,通常可以分成三类。
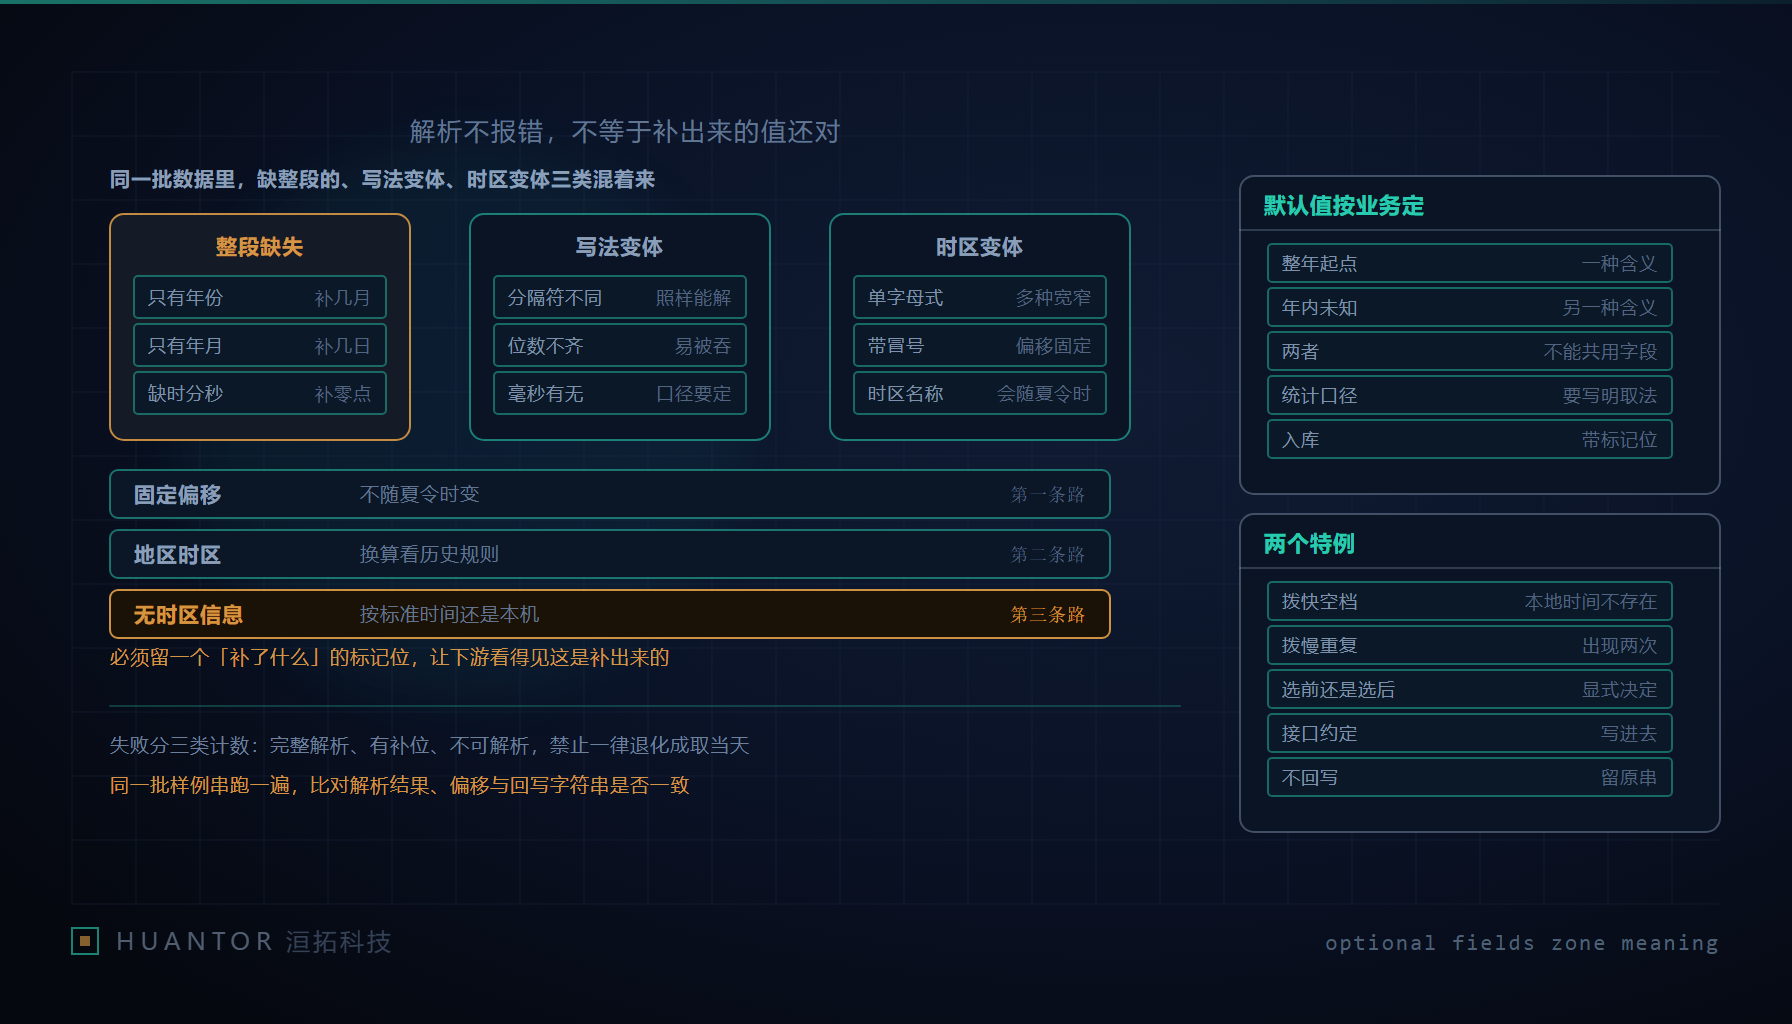
第一类是整段缺失:串里只有年,或者只有年月,后面的成分根本没出现。这类需要的是默认值,不是格式修正。第二类是分隔符与位数变体:同样的年月含义,分隔符不同、位数不同、两者组合起来没完。这类需要的是多分支匹配,仍然轮不到补位。第三类是时区写法变体:偏移有单字母的几种形式、带冒号的数字形式、不带冒号的数字形式,还有地区时区名形式。这类需要的是识别出元数据并把它带进解析结果。
三类混在一起,就是事故现场。拿默认值去解决变体问题,会把两种本有差别的合法写法静默归一成同一个值;拿多分支匹配去解决缺失问题,分支表越写越长,最后没人敢动。分层解析的意思,就是每一类走各自的代码路径,每一类留各自的痕迹,出错时能立刻说出是哪一层塌了。
三、默认值按业务语义定,不按库默认
补位的技术做法是现成的:在格式化构建器里把可选段声明成可选,为缺失部分设默认值,月与日各补成最小合法值,时分秒与纳秒一律补零,解析就能过。技术上成立,业务上未必对。
“只有年份”补到该年第一个时刻,意味着什么?在统计口径里,它可能意味着“整年起点”,是一个区间的开端,理直气壮参与排序和区间计算;它也可能意味着“该年内时点未知”,本质上还是缺失,只是勉强披了一件合法外衣。两种含义不能共用一个字段:前者进时间轴,后者进不了;前者能和别的事件比先后,后者比出来的先后全是编的。库的默认值只告诉你零点合法,不会告诉你零点是对的。
我们的约定是:每一类可能缺失的串,先在数据字典里写死补位的业务含义,再决定补成什么;同一字段两种解释都成立的,拆成两个字段;拆不动的,把解释记录在标记位里跟着值走。补位是一个决策,决策要有署名的人,不能是某个构造器的缺省行为。
四、补位标记位与失败分类计数
比“补值要按语义”再进一步:补出来的值必须能看出来是补的。解析结果要带一份缺失成分清单——哪些部分数据自带、哪些由解析器补成、命中了哪种变体。这份清单随值一起入库,下游随时可读。口径争议时,清单能分清“数据本来如此”和“我们替它补的”;上游要治理数据质量时,清单直接告诉它哪个成分缺失率最高。没有标记位的库,等于把所有补位都洗成了真值,事后无从翻案。
解析的成败也不能只报一个总数,要按三类分别计数,随每批数据回给上游:
- 完整解析:全部成分由数据自带,解析器一位未补;
- 可解析但有补位:格式通过了,但成分清单不为空,入库时补位标记同时落库;
- 不可解析:格式或语义救不回来的,单独留存原始串与失败原因,作为追溯样本。
三类计数是和上游谈判数据质量时唯一站得住的证据;一个笼统的“解析成功率”会把补位的比例整个藏起来。我们还见过不少容错解析最后滑向另一种兜底:凡解析失败,一律换成解析执行时所在的那个日历日。这类兜底必须禁止——补位默认值的含义至少由数据自己圈定,兜底时间连数据这半边都没有,它只是占了时间轴上一个合法的位置,冒充信息。
五、时区语义走三条路,夏令时留两处坑
分层解析先产出一个时间访问器,下一步是决定拿它构造什么类型的值,依据是访问器里实际是否含有偏移量或时区标识:含有偏移的,构造带固定偏移的值;含有地区时区标识的,构造带地区时区的值;两者都没有的,要明确按协调世界时还是按系统默认时区处理——这个选择必须写进接口约定,而不是藏在某个构造方法的缺省行为里,等到换环境部署时才被默认值背刺。
三条路的语义不能互换。固定偏移对那一刻忠实,但对规则失明:它不知道那个地区之后调整过夏令时,拿它换算别的日期会一路错下去。地区时区带完整规则,代价是换算复杂,历史时刻的换算要显式处理。无时区的值最危险,因为它看起来像有位置,实际上没有,跨系统搬运时每个系统都按自己的本地时间认领它,同一个值在三个系统里对应三个瞬间。
夏令时还会造出两类特殊的本地时刻。拨快造出空档:有的一段时间在本地日历上根本不存在,数据里偏落在这段里的时刻,补上一个“存在”的时刻不难,难的是不告诉下游它被动过。拨慢造出重叠:同一个本地时间对应过渡前后两个真实瞬间,选过渡前的偏移还是过渡后的偏移,是一个需要显式决定的选项——选法不同,同名小时里的记录会被合并还是拆成两摊,统计口径跟着变。两类处置都要写进接口约定,由定契约的人签字,而不是留给运行时随机的解析顺序。
六、四类样例串与一张验收表
解析层改完,不接受“单测全绿”这句话,只认四类样例串的对照。每一类各测一遍,检查解析结果的偏移、补位标记与回写后的字符串三项能对上。
| 样例类别 | 检查点 | 常见翻车形态 |
|---|---|---|
| 仅四位数年份 | 成分清单列全缺失项;结果时区按约定走 | 补出的零点被当成精确时刻参与排序 |
| 仅年月(含分隔符变体) | 变体归一后仍留原样记录;日期补位可见 | 两种写法归一成同值后无法追溯来源 |
| 带毫秒与偏移的完整串 | 偏移完整保留;毫秒精度不丢 | 用不带时区的类型解析,时区整段蒸发 |
| 带时区名的串 | 还原成地区时区,重叠时刻能给定论 | 时区名没匹配上,退化成系统默认时区 |
回写这一项要单独说:把解析结果按同一套规则重新渲染成字符串,和原始输入比对,本该一致的位置必须一致,补出来的位置必须带着标记。偏移、补位标记、回写串三项互认,验收才算过。
盲目用带时区的类型去解不完整的串,会因为缺必要字段直接失败;偷懒用不带时区的类型去解完整的串,会把好不容易带来的时区信息丢掉。两头都不对的时候,答案只剩中间那条路:分层解析、按语义补位、给补位留痕。可选组件的解析,难的从来不是格式匹配的技巧,而是“缺的那部分到底算什么”的一次次决策——决策落了纸面、进了数据,容错才是容错;决策留在代码暗处,容错就是含糊。