
十四周多、一百多次发布、一笔 token 费用:机械移植该记哪几本账
一、成本结构变了:一次语言级移植要记五本账
据公开报道,有厂商披露了一次运行时从 TypeScript 到 Rust 的移植:借助模型智能体,历时约十四周半,采用逐个模块更新的方式推进,共完成一百多次发布,并为模型调用支付了费用。这三个数字放在一起之所以有价值,不是因为它们好看,而是因为它们恰好能拆成几本可以核对的账。
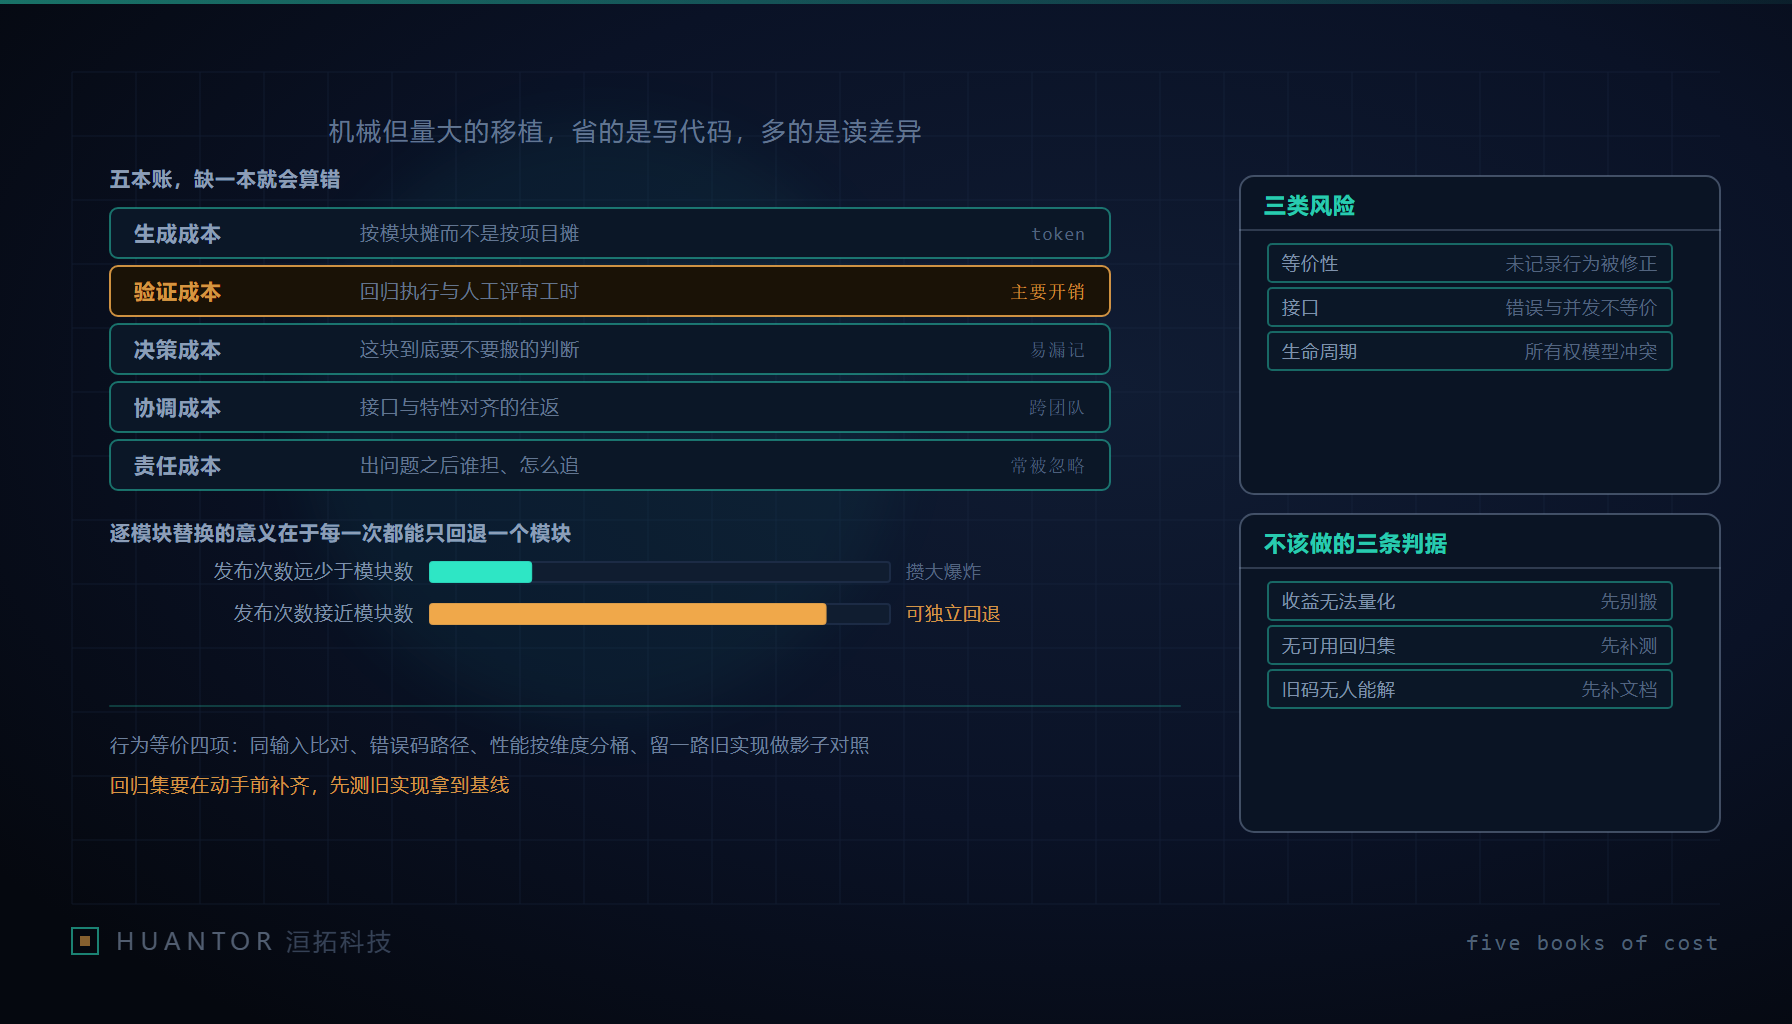
这类项目最容易误算的地方,是把它当成“写代码省下多少人天”的一笔交易。实际的成本结构已经变了:省的是把代码写出来的时间,多的是人读差异、定责任的时间。要记的账至少五本。
| 账目 | 具体是什么 | 谁来记 | 最常被漏的部分 |
|---|---|---|---|
| 生成成本 | 模型调用产生的 token 或算力开销 | 项目侧按用量出账 | 反复重跑与调试提示词的隐性消耗 |
| 验证成本 | 回归测试执行、人工评审差异 | 测试与评审人各自计时 | 评审读差异的时间被当成“顺手看一眼” |
| 决策成本 | 判断这块到底要不要搬、怎么搬 | 技术负责人 | 每次决策的等待时间与来回讨论 |
| 协调成本 | 接口对齐、特性差异的取舍确认 | 各模块负责人 | 跨语言语义不等价时的临时约定 |
| 责任成本 | 出问题后谁担、怎么定位到某次替换 | 运维与值班 | 归属不清导致的全员反复排查 |
五本里最容易被漏记的是验证成本和责任成本。前者因为不产生代码量,在按提交统计的团队里几乎不可见;后者因为发生得很分散,每次只是十几分钟,攒起来却很可观。机械移植项目的真实开销往往落在这两本上,只报生成成本的项目,事后复盘一定会失真。
二、逐模块替换为什么更适合模型代劳
模型擅长的是有明确输入输出契约、失败范围可界定的一段工作。整体重写把这两条都丢掉了:一次改一大片,出错时说不清是哪一处引入的,回退只能整体退。
逐个模块替换正好相反。每个模块有自己的边界和行为约定,替换失败只回退这一个模块,其余继续推进。这种形态下,一百多次发布的意义不在“勤快”,在于每一次都可以独立回退。
切分粒度要按可独立验证的行为切,不是按文件切。按文件切会出现两种坏情况:一个文件里同时装着已迁移和未迁移的逻辑;几个文件合起来才构成一个可验证行为,单独换其中一个跑不出证据。正确的判定标准很朴素:这个单元能不能给出“替换前后跑同一套测试都通过”的证据。给不出证据的单元,就不是一个合格的切分单元。
按这个标准,一个模块的替换至少要留下四样:本次替换的范围说明、跑过的测试集标识、比对结果、以及未能覆盖的行为清单。第四样最关键,未记录行为恰恰是最容易出问题的地方。
三、三类真实风险,以及各自的对策
第一类是等价性风险。原实现里存在没有被文档记录的行为,模型在重写时把它当“明显的错误”顺手修正了。这类改动测试通常测不到,因为它本来就不在预期里,只有下游依赖它的调用方会在某天踩到。对策是:凡是原实现里看起来多余、奇怪、说不清用途的分支,一律先记录成“待确认行为”,迁移时保持原样,是否修正作为独立决策提出来,绝不允许夹在替换提交里。
第二类是接口风险。不同语言在错误处理和并发语义上并不等价,一侧用返回值传错误、另一侧用类型化错误;一侧的共享状态默认允许并发访问、另一侧要求显式同步。这些差异不是语法翻译问题,硬翻过去会把错误吞掉或把竞态藏起来。对策是给每个模块的接口层单独做一次语义对照,写明错误路径怎么映射、哪些调用点是并发入口,并把对照结果放进评审记录。
第三类是生命周期风险。所有权模型不同的语言里,原来的回调注册、共享可变状态、跨对象引用这些写法可能直接失效,或者变成运行时才暴露的问题。对策是先做一次写法普查,把依赖共享状态与回调存续期的地方集中列出来,这部分不允许自动改写,必须人工重写并单独提交。
三类风险的共同点是:都不是“代码写得对不对”的问题,而是“原意有没有被完整搬过来”的问题。所以移植项目的评审重心要放在差异上,而不是放在新代码的风格上。
四、“行为等价”怎么定义、怎么测
等价不是一个可以靠感觉承认的词,要写成能执行的四种测法。
其一,同一输入集的字节级或结构级比对。输入集要覆盖正常路径与边界值,输出比对应分两层:结构化的字段做结构比对,涉及序列化文本的做字节比对,两种各有能发现的问题。
其二,错误码与异常路径也要比。绝大多数等价性事故出在失败分支上,因为正常路径大家都测,失败路径只有原实现的作者知道。要把原实现能抛出的错误枚举出来,逐条验证新实现返回的映射结果。
其三,性能基线按维度分桶,不取总均值。总均值会把“一部分场景变快、另一部分明显变慢”平滑掉,看上去持平。要按调用规模、按数据类型、按并发档位分桶,桶内比较才有意义。
其四,保留一层用旧实现跑的影子流量做对照。灰度期间把同一份请求同时送给旧实现,只对比不返回,是最直接的兜底。这一层的成本不低,但它是唯一能在真实负载分布下发现差异的手段。
还有一个顺序问题必须在项目开头就定死:回归测试集要在移植之前补齐,而不是移植之后补。先对旧实现跑一遍拿到基线,再动代码。反过来做,等于拿一份从没验证过的测试集去证明新实现是对的,逻辑上不成立,实践中也确实测不出问题。
五、发布节奏与成本摊法这两本账怎么读
发布次数是一个可以读的数字。发布次数与模块数量大致相当,说明切分有效,每个单元都能独立上线与回退。如果发布次数远少于模块数,说明它在攒一个大爆炸:中间结果没有落地,问题会在最后一次集中出现,而那时最难定位。
成本要按模块摊,不按项目摊。按项目摊只能得出“这次移植花了多少”这个对下次毫无用处的结论。按模块摊能看出哪一类代码的生成成本最高:通常是那种上下文长、契约描述含糊、测试覆盖薄的模块。这个信息直接决定下一轮值不值得继续用模型代劳,也决定该先补哪一块的测试。摊法上建议固定三列:模块名、替换前后各自的验证耗时、生成用量。三列齐了,才谈得上比较。
责任成本要用记录来压。每个模块的替换提交都要带一条归属信息:谁批准的、跑过哪套测试、哪些行为未覆盖。事故定位时先看这三项,能省掉大量全员排查的时间。
六、六周观察期、三条不该做的判据,以及对客户的处置建议
上线之后不要立刻宣布完成。建议留一段约六周的观察期,盯四件事:新增缺陷的分布是否集中在被替换的模块上(如果散落在各处,说明问题不来自移植本身);性能回归是否出现在分桶后的某些桶里;异常率的走势有没有台阶;回滚次数与回滚原因。四件事里最该先设好告警的是异常率,因为它是唯一能在用户投诉之前给出信号的。
有三条判据命中任意一条,这类移植就先别做。一是没有明确的性能或运行时收益,只是“这门语言更现代”;二是没有可运行的回归测试集,等价性无法证明;三是旧代码没人能解释,此时搬过去的不是实现,是一堆没人读懂的行为。三条的共同点都是“验证面缺失”,这也印证了前面的判断:这类项目真正稀缺的资源不是生成能力,是验证能力。
客户提出这类需求时,洹拓的处置方式很固定:先要求三件齐了再开工——收益量化、验证基线、回退单元。收益量化说明为什么值得做;验证基线说明怎么证明没搬坏;回退单元说明出问题怎么退。三件缺任何一件,项目会变成一场没有终点线的长跑,钱花在生成上,问题出在验证上,最后谁也说不清这次替换到底对不对。