
投研智能体的第一道门槛不是会分析,是每句话能回指到哪份材料
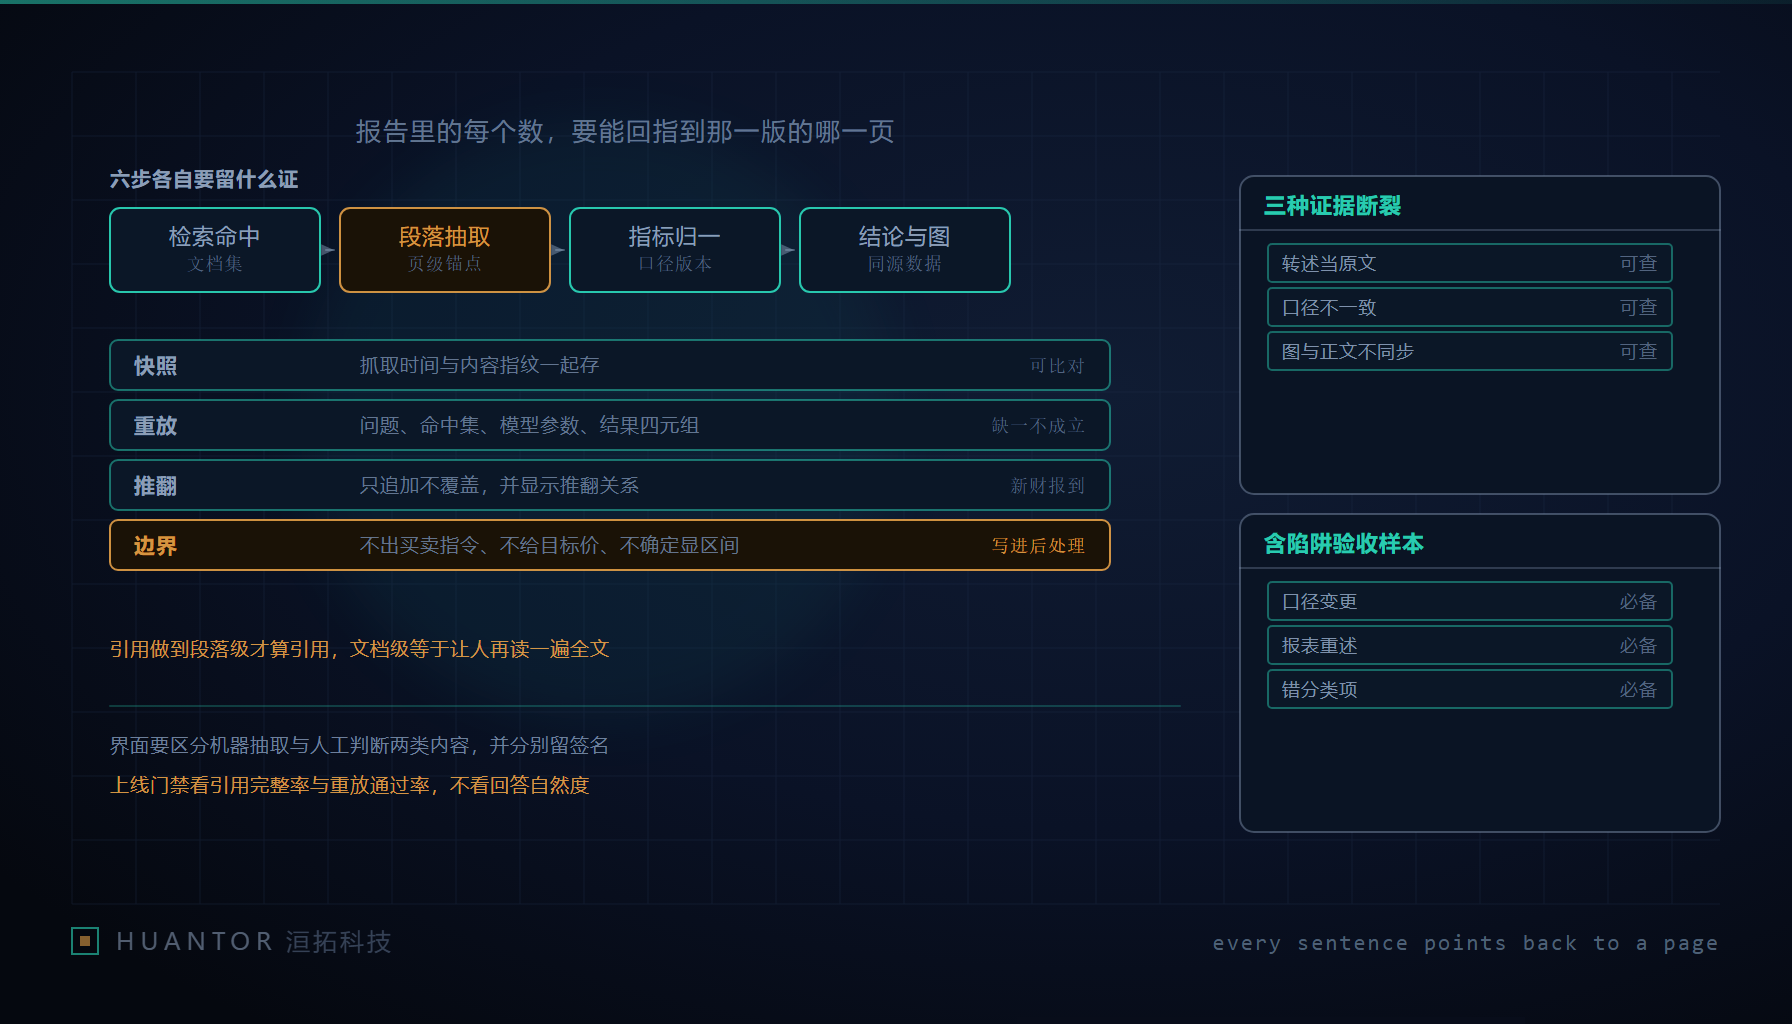
一、把“读材料生成分析”拆成六步,逐步定留证要求
据公开报道,有云厂商在测试面向专业个人投资者开放的投研智能体:按问题调用金融数据,读取财报、公告和研究资料,生成分析与投研报告,再把结果保存到持续跟踪的研究空间。这条能力链里,生成质量是最容易被拿来宣传的一段,却是最不该先看的。真正决定它能不能用的,是每一步留下的证据。
六步要分开定要求。
第一步,检索到候选材料。这一步要留的是命中集合本身,不只是最终用了哪几份:哪些被检索到、按什么条件排序、哪些被丢弃。丢弃记录尤其重要,因为漏检比错引更难被发现。
第二步,抽取到具体段落或表格。要留下抽取的定位信息,材料标识、版次、页码或段落锚点、命中原文的起止,缺一项下一步就接不上。
第三步,归一化成指标。原始报表里的字段名和单位在各份材料间并不统一,折算规则要落成可导出的映射说明:为什么这一项被并进了那个指标,分母取的是哪个口径。这一步最容易出“看不出错但算错了”的结果。
第四步,下结论。结论必须能指回第二或第三步留下的证据标识,不能只有一句自然语言判断。
第五步,生成图表。图表要绑定数据来源标识和取数时间,图上的每个数值要能追到一张表,不然图会比文字更容易造成误导。
第六步,落进研究空间。落库时要连同前五项的标识一起写入,只存最终文本等于把证据链在最后一公里剪断。
六步的留证项汇总成一张表,可以直接当验收清单用。
| 步骤 | 必须留下的证据 | 最常见的断裂点 |
|---|---|---|
| 检索候选材料 | 完整命中集合、排序条件、被丢弃项及原因 | 只留最终引用的几份,漏检无法发现 |
| 抽取段落或表格 | 材料标识、版次、页码或段落锚点、原文起止 | 只有文档级出处,核对要重读全文 |
| 归一化成指标 | 口径映射说明、分子分母来源栏位 | 按名称对齐而非按定义对齐 |
| 下结论 | 结论与证据标识的对应关系 | 结论成了一句无源的自然语言 |
| 生成图表 | 取数批次标识、每个数值的来源表 | 图文用了不同批次,数值互相矛盾 |
| 落进研究空间 | 上述标识随正文一并写入、状态字段 | 只存文本,历史状态无法回看 |
二、段落级回指是最低标准,不是加分项
很多产品的“引用”做到文档级:点一下出处,跳到那一份财报的首页或整篇公告。这等于要求核对的人把全文再读一遍,而实际不会有人读。文档级引用只在两种情况下有价值:材料本身极短,或者引用者是专门为核查而坐在那里的人。这两种情况都不成立。
段落级回指的可执行标准是三个:能定位到具体段落或表格、能显示被引的原文本身而不是摘要、能显示这份材料的版次。三条同时满足,一个不熟悉这家公司的人可以在十几秒内判断这句话有没有被歪曲。少掉任何一条,核查成本都会跳回“整篇重读”。
这里有一个实现上的取舍要写清:锚点用什么。用页码会因排版变化而失效;用文本片段做匹配则原文一旦有别名、有单位差异就匹配不上。稳的做法是两者都存,以材料标识加段落序号为主键,文本片段作为校验指纹,对不上时报“引用可能失效”而不是静默跳过。
三、三种最常见的证据断裂
第一种,结论引用了材料,但材料里那句话是转述而非原文。模型在中间把陈述改写了,改写方向恰好把限定条件抹掉,比如把“剔除某类项目后”这一层意思丢了。判据是:被引段落里必须存原文串,与结论里出现的说法做字面或近似比对,匹配不上就标记为“需人工确认”。
第二种,指标口径与原始报表口径不一致。同一个名称在不同报表里有不同范围,或者公司改了列示方式,智能体按名称对齐而没按定义对齐。这类错误从文本上完全看不出来,只有在第三步的映射说明里才能暴露。对策是给关键指标建一张口径登记表,登记它的分子、分母、来源栏位和历史上改过的列示口径,归一化时必须命中登记表里的一条,命不中就不许生成数字。
第三种,图表数值与正文结论不同步。正文是先写的,图是后算的,两者用了不同批次的取数结果。对策是把图和文绑在同一个取数标识上:同一份报告里所有数值必须来自同一次取数批次,批次不同的要在页面上显式提示。
四、数据快照与重放能力
同一份财报,在不同数据服务里解析出来的结果可能不一样,表格切分方式、合并单元格处理、单位换算都会造成差异。所以落库时要存快照,快照至少四要素:材料来源标识、抓取时间、材料版次、内容指纹。四要素齐全,将来出现分歧时才能回答“当时看到的是哪一份、和现在的哪一份不同”。
重放能力是另一件事,实现方法是保存四元组:输入的原始问题、检索命中的材料集合、模型版本与生成参数、最终生成结果。这四项缺任何一项,一次错误结论就没法复盘。最容易缺的是第二项:命中集合往往只留了被引用的那几份,没留当时可见的完整候选,于是无法判断是模型选错了还是根本没有正确的材料进来。
重放还要留一条工程约束:不允许只靠“当前模型加当前数据”复现。模型换了版本、材料重新解析过,重放出来的结果和当初不一样,但报告文本没有变,这会造成“我复核过了没问题”的错觉。所以重放页面必须同时显示“当初结果”和“现在重放结果”,不一致要显式标注差异。
五、持续跟踪的研究空间会带来旧结论被推翻的问题
把结果保存成可以持续跟踪的空间,看起来只是存储功能,实际引入了一类新问题:新的财报来了,旧结论被推翻,怎么处理。
删除是最坏的选项,它把“我曾经判断错”这件事抹掉了,而这个信息本身是后续判断的基础。就地覆盖同样不可取,它让历史版本无法回看。可行的策略是只追加不覆盖:旧条目保留,新条目引用旧条目并显示推翻关系,说明是哪一份新材料、哪一项指标变化导致了推翻。界面上要能一眼看出哪些结论是当前有效、哪些已被推翻、哪些因材料更新而处于待复核状态。
这套状态要能导出。一份持续跟踪的空间如果只能在线看,等于没有证据价值;导出时要连同快照标识和推翻关系一起出来,只导出文字会把状态信息全丢掉。
六、三条硬边界、人机分工,以及验收怎么测
面向个人投资者的产品有三条边界要写进生成约束与后处理过滤,而不是靠页面底部一句免责声明:不输出买卖指令;不给目标价与收益承诺;不确定的地方显示为区间,或者干脆不显示。三条里最后一条最难落实,因为模型天然倾向于把不确定说成确定,过滤规则要能在生成前后两头做:前头约束它必须标注依据与置信范围,后头扫描出现承诺式措辞就整段撤回并显示为“该项不输出”。
人机分工的落点要说清楚:智能体负责把材料聚合成结构,人负责给结论定调。界面上要区分“机器抽取”与“人工判断”两类内容,并且分别留签名与时间。这一条不是为了好看,是为了出问题时能界定是哪一环的责任:如果所有文字看起来都像机器写的,人复核过也没有痕迹,复核就等于没做。
验收方法上,要准备一组已知含陷阱的样本,看智能体是不是照抄了错误口径。三类样本最有效:口径变更(同一指标换了定义)、重述(前期数据被重新列报)、非经常性项目被错分类。这些样本的意义在于,它们无法靠“多读几份材料”避过,只能靠口径登记表和段落级证据拦住。
对做企业级问答与知识型智能体的我们来说,最可迁移的一条是把上线门禁换掉:不看回答自然度,看两个指标——引用完整率(结论里能回指到段落级证据的比例)和重放通过率(抽样的历史结论能否用保存的四元组复现出来)。洹拓在给内部资料问答类项目定验收标准时,这两个指标不过关就不允许对外放量,因为一个不能回指的答案,比没有答案更容易造成损失。