
分块大小调到十条,外部接口还是被逐条调用|洹拓科技
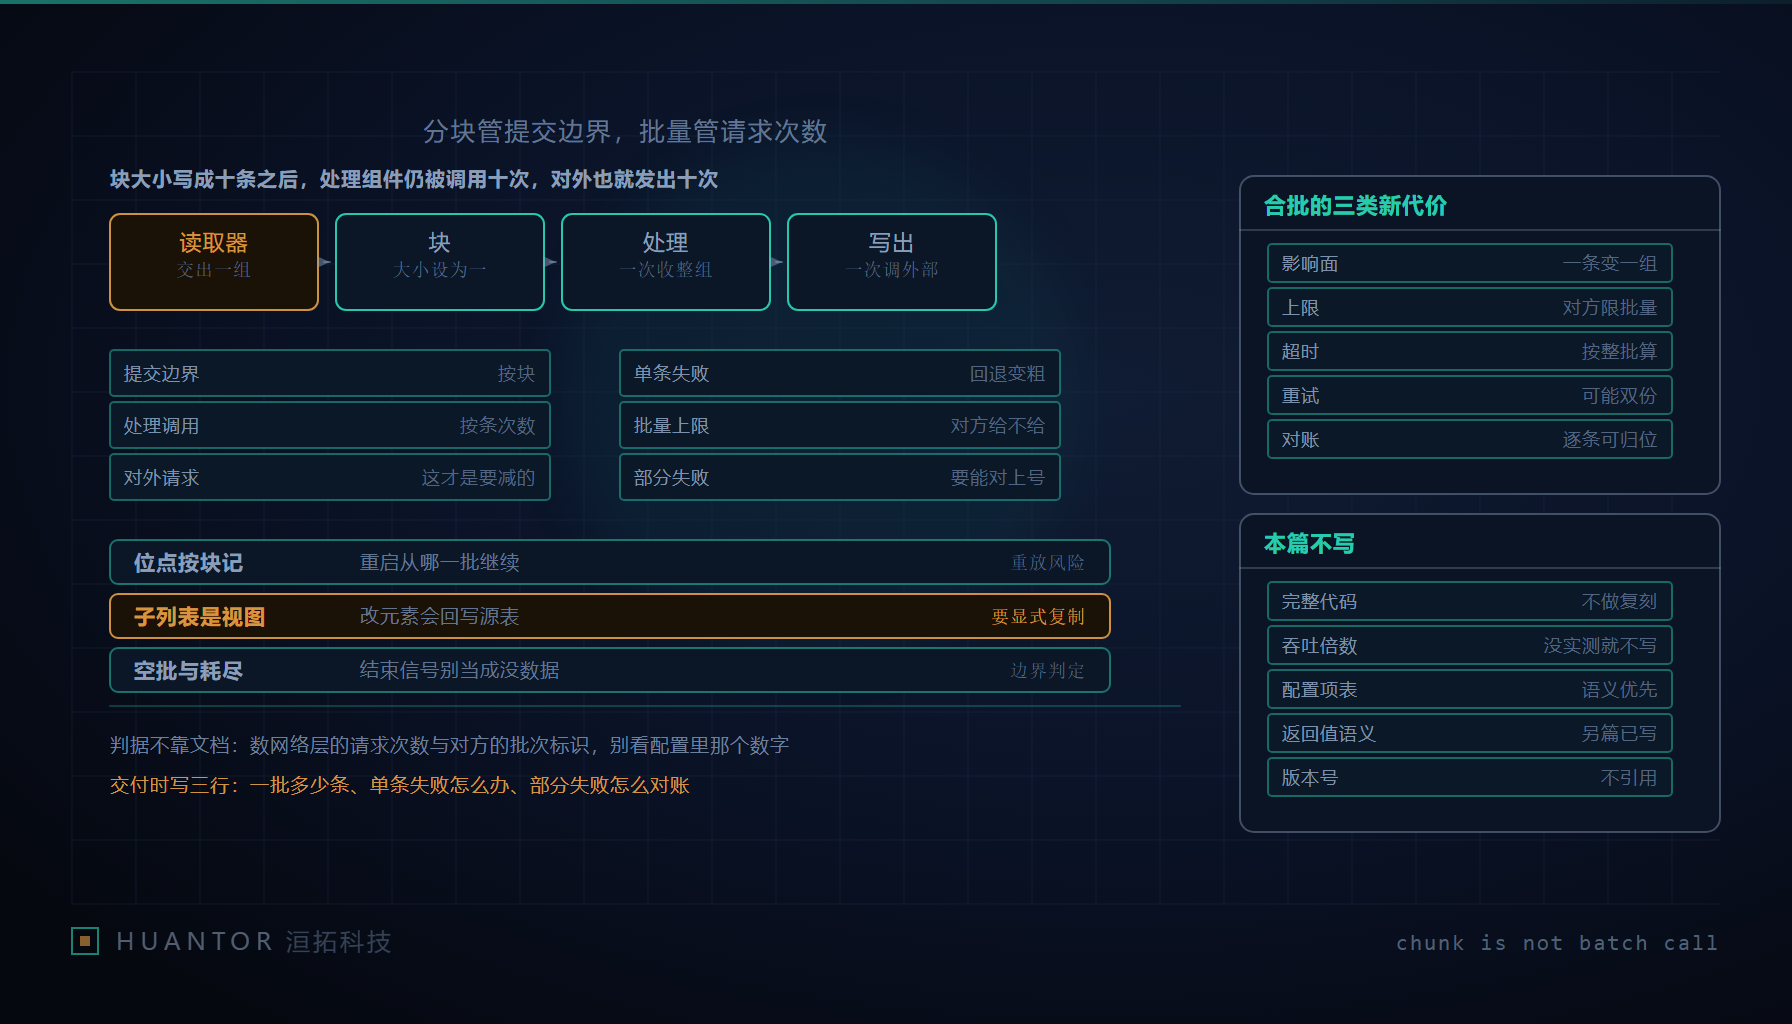
一、一个配置数字,管不着另外两个数
先说现象。有人提出把对外接口的逐条调用合并成批量提交,负责人回应批处理大小早就配成了十;可是翻监控一看,外发请求数和数据条数依然一比一,一次合批都没发生。这不是框架出了 bug,而是两个词被混用了:框架里的“分块”指的是提交边界,业务里的“批量”指的是一次外部调用,它们从来不是同一个数。
在这类 Java 批处理框架的默认分块模式里,块大小参数这样起作用:处理组件以单个元素为单位被调用,框架数够配置的条数之后提交一次事务。也就是说,即使块大小配成十,处理器仍然会被逐条调用十次;下游如果是一个支持批量提交的对外接口,这十次调用就发出十次请求,既浪费了合批能省的性能,又给对方服务叠了压力。
优化动手之前,先把三个数分开。
| 名称 | 它管什么 | 认错之后的表现 |
|---|---|---|
| 提交边界 | 处理多少条之后落一次事务 | 配小了频繁提交,配大了回滚拖累一整段 |
| 处理组件被调次数 | 一个块里处理单元进场几回 | 仍等于条数,说明框架还在自动分块 |
| 对外请求次数 | 真正发出去几次网络调用 | 只有它降下来,合批才算发生 |
第一个数是块参数能直接控制的,后两个数取决于组件怎么接参数。很多“合批优化”停在配置里,就是因为改的人只动了第一个,以为另外两个会跟着降。对洹拓做交付来说,这个区分不写进方案,验收时一定翻车。
二、职责反转:让读取器交出一整组
真正批处理的做法是反转职责:不再依赖框架对单条元素自动分块,而是自定义读取器,让它主动返回预组装好的一整组数据,一个列表;同时把块大小设成一,使每个块本身就是一批。这个结构下,处理与写出组件接收的都是列表而不是单条元素,进场次数从“每块十条”变成“每块一次”,调用类型和调用次数一起变了。
配套的语义要一起想清楚。其一,数据耗尽时读取器返回空值,这是整个作业的结束信号,框架靠它判断跑完没有,而不是靠计数或比对总数。其二,块大小同时决定事务提交边界和跳过策略的计数粒度;设成一之后,提交按“批”走,跳过策略也以“批”为计量单位,原来配好的跳过额度含义全变。所以这不是改一个数字的小事,读取器、处理器、写出器和失败策略要作为一个整体重新评审。
三、合批买到的三张新账单
合批换来请求数下降,但有三类新代价必须在动手之前重算。
第一类是影响面。单条失败过去只影响一条,回退粒度按条;合批之后一条坏记录把整组一起拖进回退或重试,粒度从“条”变“批”。对下游是消息通道的场景,还要先定规则:空批次要不要投递,把空列表照发出去等于给对方制造无意义的唤醒。我们要求在作业说明里写明影响面变化,因为一批的体量一定比一条大,运维处置的节奏跟着变。
第二类是外部接口的批量上限与部分失败语义。能收批量的接口通常限制单次条数,超上限直接拒;返回结果必须能逐条对上号,哪些算成功、哪些算失败要各自可查。批量写入的返回值到底该怎么解读,站内已有一篇专文讲这个轴,本篇不重复,只把结论摆在这里:合批之前必须先在契约里锁死“一批最多带多少条”和“部分成功的结果按什么粒度返回”,否则后面所有重试与续跑逻辑都建在软地面上。
第三类是超时与重试预算。过去超时按单条请求的尺度算,重试预算也按条留;合批后整批的处理时长取代了单条时长,超时阈值、重试次数与总预算都要按整批重算。最常见的事故形态是配置还留着单条时代的数字,一批发出去整批超时,重试又整批重放,外部系统看到的不是省了调用,而是被反复砸同样的大请求。
四、位点与续跑:进度从按条记变成按批记
读取器交出整组数据之后,位点语义要重写。过去作业进度记“读到第几条”,重启接着往下读即可;现在处理进度按块记,检查点里写的是“提交到第几批”。
进程重启从哪一批继续,取决于每一批能不能被唯一确定。如果读取器按稳定顺序切分源数据,并且把每一批的序号或内容指纹写进位点,续跑才能精确落在未提交的批次上;要是切组结果依赖查询返回顺序,而查询本身不稳定,那“续跑”就只是碰运气。重放是否重复投递是另一道硬边界:写出成功但检查点回写失败,重启后同一批会被再处理一次,对外部接口而言就是重复投递。所以合批要和幂等键配套,把批次标识随请求带出去,对方才能拒绝同批二次入库。
结束信号还留下一个边界情形:数据耗尽靠读取器返回空值来宣告,那最后一批不满整批怎么办?一批里只有两三条,仍然是合法的一批,必须正常处理完再走结束,不能凑不齐就丢弃。坑更深的一层在空批:如果读取器收尾时返回的是空集合而不是空值,框架可能收不到结束信号,作业空转或者直接报错。空值、空集合、不满批三者语义不同,要在代码评审里逐一约定,别让它们在实现里互相冒充。
五、子列表是视图:批处理里最容易踩的一脚
读取器把大列表切成组时,惯常做法是用那个取子列表的方法。这里有个必须写进评审清单的事实:该方法返回的是原列表的视图,不是独立副本。落到批处理里,后果有两条。一条是下游改了子列表里的元素,修改会回写源列表;如果读取器还拿着源列表继续切后面的组,它拿到的已经是被污染的数据。另一条是多线程共享时更隐蔽:一个线程握着视图,另一个线程动了原列表,前者读到的就是改过一半的状态,这类问题在测试环境几乎复现不出来,只在生产以“偶发数据错乱”的形态出现。
哪些位置必须显式复制一份?我们的判据是两条:列表交给可能修改元素状态的下游组件之前,必须复制;数据要跨线程或异步边界传递之前,必须复制。全程只读且单线程的路径可以留视图,但要把这个前提写进注释,让下一个改代码的人知道边界在哪。复制一份的代价是内存和一次拷贝,视图被共享污染的代价是查不清的脏数据,两笔账怎么算都该选前者。
六、不靠文档的判据与交付三行
合批到底发生没有,不看配置里的数字,也不听组件自述,去数两件外部的事。第一,数网络层的请求次数:一次作业运行里,对外调用总次数与处理数据量的比例应当接近“一批一次”;如果仍与条数相等,合批就没发生。第二,看对方返回的批次标识:外部接口真收到批量调用时,每次应答应当带着一个可对应的批次号或整体回执;拿回来的是逐条应答结构,说明对方看到的还是逐条调用。这两条判据都不依赖框架文档怎么描述自己的参数,属于能当场验证的事实。
交付层面,这项工作最后要落成三行字,写进接口约定与作业说明书:
- 一批多少条:上下限都写明,包括最后一批不满额时的处理约定;
- 单条失败怎么办:批内一条出错,是整批回退、跳过单条,还是靠幂等键整批重放,三选一并写死;
- 部分失败怎么对账:对方按什么粒度返回逐条结果,回查用什么键、允许重放几次。
块参数管提交,组件职责管调用,这条分界线写不清,配置数字改得再大也只是心理安慰。把三张账单算完、把位点改成按批、把视图的坑填上,最后用网络层的计数验收,“分块大小调到十条”才不会停在口号上。