
投机解码的提速卡在批改规则上:严格与近似之间选哪条|洹拓科技
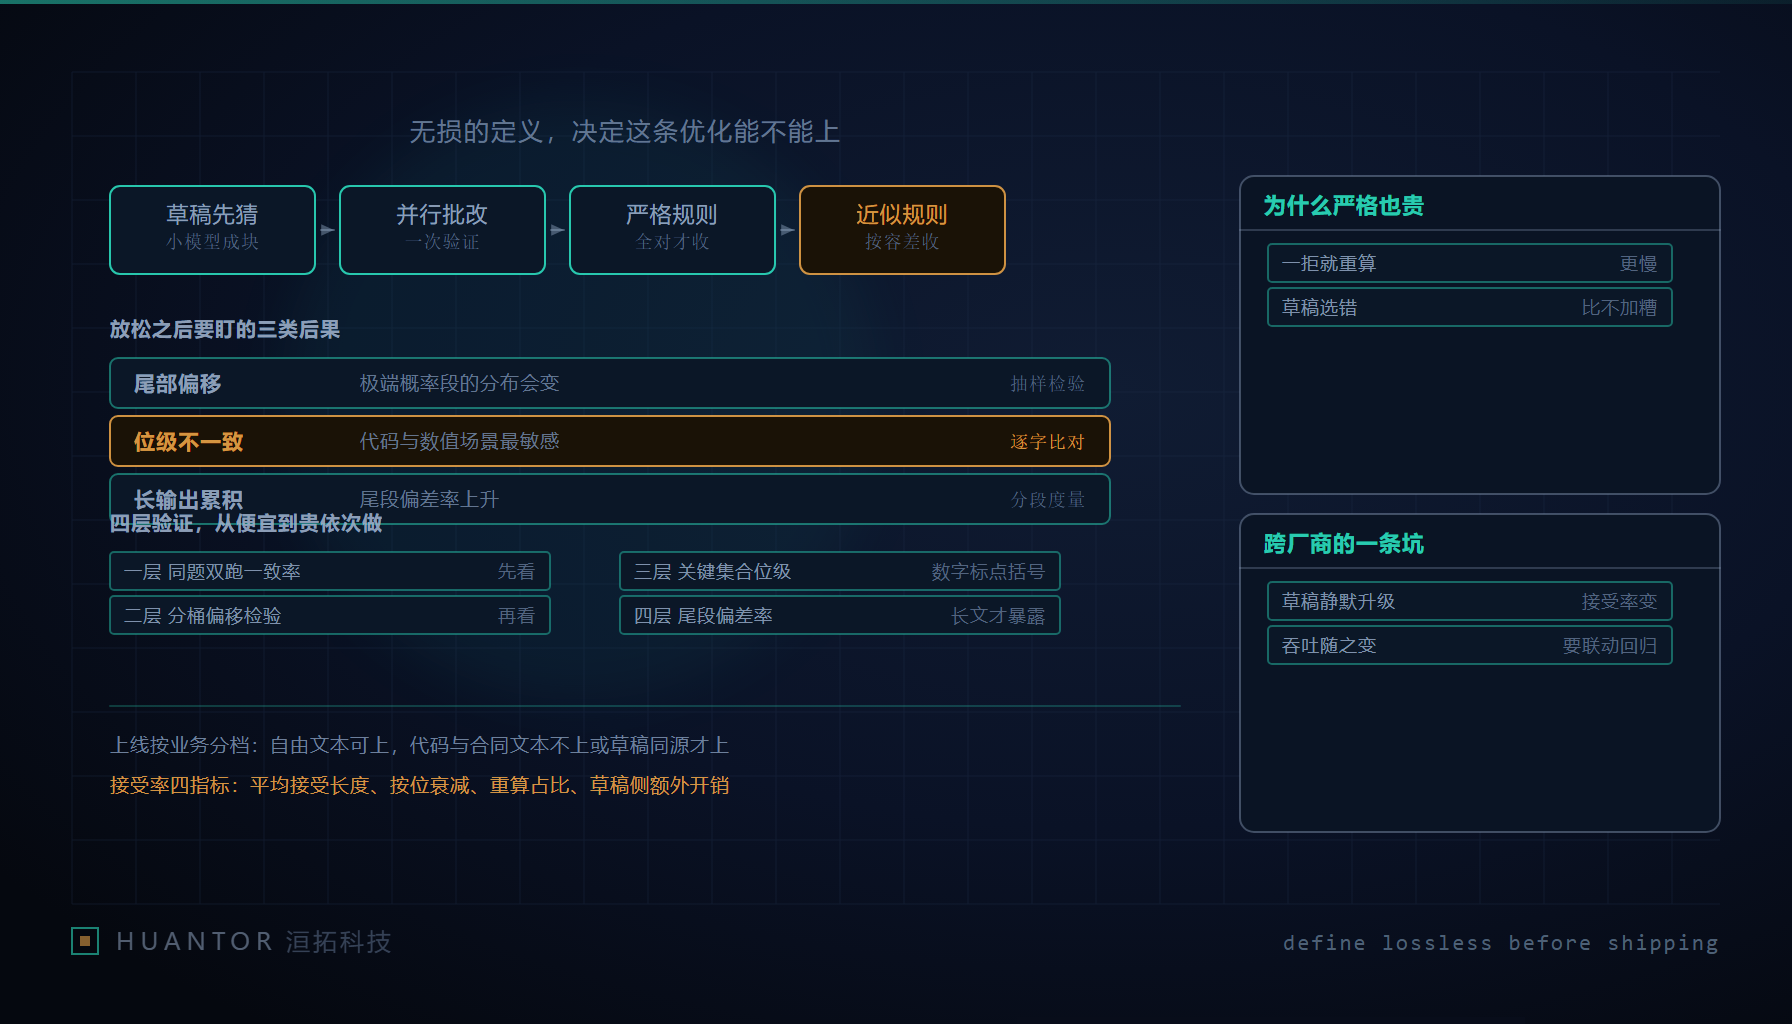
一、严格批改贵的不是算力,是回退
投机解码的机制并不复杂:一个轻量的草稿模型先连着猜出一块词元,大模型在一次并行前向里把这块候选全部批改一遍。据公开报道,这条路径已经被主流推理框架广泛采用,是少见的、不必重新训练就能提速的做法。但它的提速上限不由草稿模型猜得多快决定,而由一条批改规则决定:严格判据要求每个候选位置都与目标分布对齐,一旦被拒,就要从那个位置起重算,后面已经猜好的部分全部作废。
严格规则的价值是它带有分布层面的保证——批改完的输出分布与不加草稿时一致。这条保证的代价落在三个地方:
- 接受率低时是负收益。草稿每被拒一次,那一次并行前向的算力就白花,还要从拒绝点自回归跑出一两个词元才能重新起批,端到端延迟反而比不开更高。
- 草稿模型选错比不选更糟。同源、同分词器、同域数据的草稿接受率高;跨家族、跨分词器的草稿在逐位置对齐上先天吃亏,候选一长衰减越快。
- 收益强依赖任务与长度。口语化的长段落接受率高;代码、数值、结构化字段里一个符号不对就整段回退。
在洹拓做推理侧优化时,我们习惯先把“一次平均能接住几个词元”在自家负载上测出来,而不是先信外部给的倍数。公开场景的提示词分布通常比业务数据干净,同一个开关在两类流量上的表现能差出一截,这个差别只能在自家流量上看。
二、近似验证放松了什么,会看到三类后果
所谓近似验证,公开工作的做法是免训练、即插即用:把逐位置的严格比对放松成按概率或按容差的批量判定,不再要求每个候选都严格满足那条判据,允许一部分“差一点”的候选直接通过。省下来的正是回退次数,这也是提速的全部来源。放松的代价是那条分布一致的保证没有了——输出分布不再严格等于原模型,只是接近。
没有理论保证时,工程上要盯的是三类可观察后果。
- 极端尾部词元的分布偏移。严格规则会拒绝低概率候选,近似规则更容易留下它们;在长尾选项上,模型会被推向它本不常走的那一支,外在表现是措辞风格漂移、专有名词与名称类字段更容易写错。
- 代码与数值场景的位级不一致。小数位数、指数写法、进制前缀、标识符大小写,这类位置差一个字符,语义上就是另一个值。近似通过一次是正确性事故,不是质量瑕疵。
- 长输出尾段的偏差累积。前面放松的量在小范围里看不出来,但格式化输出、长复读、表格填充这类强约束段落,偏差会沿位置累积,越靠后越容易把格式崩掉。
据公开报道,这类放松换来的提速在百分之十五量级。这个数字不作为本篇的判断依据,我们关心的是它换来的是什么形态的风险,以及这种风险在你的业务里值不值。
三、没有理论保证时,用四层验证把它测出来
近似验证缺的是先验保证,那就得用后验证据补上。给推理链路做质量回归时,我们把验证固定成四层,从最容易做到最不容易做排:
第一层,同一提示词双跑的完全一致率。同一批提示词,关掉投机解码跑一遍作基线,开着近似验证再跑一遍,统计两条输出在字符串层面完全相同的比例。这一层给出的是粗糙下界:不一致的比例就是需要往下查的量。做之前必须把采样温度归零、把解码固定成贪心,否则测的是随机性而不是验证规则。
第二层,按任务分桶的分布偏移检验。把线上流量按业务切成自由问答、摘要、抽取、代码、格式化输出若干桶,每桶单独看输出长度、词汇分布与关键槽位填充率的差异。整体平均值常常被自由文本桶稀释,真正出事的那一桶就在平均线下面看不见。
第三层,关键词元集合的位级比对。只比字符串还不够,要专门把四类位置抽出来做位级检查:数字与小数、标点、标识符、代码括号与缩进。这四类是“错一个就废”的位置,也是近似通过最爱留在原地的位置。单独统计它们的通过率,比看整体一致率灵敏得多。
第四层,长输出尾段的偏差率。按输出位置分桶,统计前段、中段、末段的差异密度。放松规则的偏差通常在末段更明显;只看整段一致率的话,三千字里前两千字的稳定会把后一千字的问题平均掉。
四层跑完,能得出一个可以交付的结论:哪一类任务上近似与严格的差异低于测量精度,哪一类必须保留严格规则。这份结论本身就应当写成上线门禁的一部分,而不是留在实验记录里。
四、接受率要做成四个可运维指标
“接受率高”这句话没法告警,要拆成四项采得到数的指标:
- 平均接受长度:一次批改里被通过的候选个数均值,并按中位数与高分位分开看。只看均值会被长段自由文本抬起来。
- 按位置的衰减曲线:第几位候选各自的通过率。这条曲线比均值有用——如果第三位之后通过率就掉得很低,草稿长度拉到八只是把算力浪费在被拒的那一半上。
- 被拒后重算耗时占比:回退造成的额外解码时间占总延迟的比例。这一项直接决定近似验证在自家负载上是不是真的省时间。
- 草稿侧显存与延迟占比:草稿模型自己占的那份显存,以及它串行贡献的延迟。小显存多租户的机器上,这一项常常才是决定能不能开的那个门槛。
告警阈值不要用绝对值定,用自家基线的相对偏移定。做法是在一个稳定周期内按任务桶各采一条分布,把“平均接受长度跌到基线的某个分数”“重算耗时占比涨到基线的某个倍数”设成告警线,并且把草稿模型版本、目标模型版本一起写进指标标签。否则下次接受率突变,你分不清是规则改了还是模型换了。
五、按业务线分档上线,请求级要能关
我们的建议不是一次全开,是按后果分档:
| 业务形态 | 严格验证 | 近似验证 | 说明 |
|---|---|---|---|
| 自由文本问答、改写、摘要 | 可用 | 可开,需过第三层 | 单点措辞差异不影响下游判定 |
| 结构化抽取、字段回填 | 可用 | 需按槽位单独回归 | 一个槽位错,下游整条记录作废 |
| 代码、配置与脚本生成 | 建议保留 | 默认不开 | 位级不一致即功能错误 |
| 合同、票据、条款类文本 | 建议保留 | 不开 | 输出要作为凭证留存,前缀被改写不可接受 |
| 数值、单位与时间相关输出 | 建议保留 | 不开 | 近似通过最容易留在这一类位置 |
表里“前缀被改写不可接受”这句要单独解释。无损加速这四个字得看清无损的定义:分布一致是一种无损;把已经生成的前缀改掉、或者让同一提示词两次跑出不同结果,是另一种事情。它对凭证类、审计类文本就是实质损失,哪怕平均质量分数一点没掉。所以对外承诺里我们更倾向写成“该业务线保持严格验证”,而不是笼统地说已开启加速且无损。
另有三条上线纪律:
- 请求级可关。加速开关必须能按单次请求关掉,而不是只有全局配置。排查一个疑难问题时,第一件事是把它关掉再复现一次。
- 灰度期双写留证。同一提示词在严格与近似两条路径上各留一份,按抽样比例落库,出争议时才有比对口径。
- 分档写进变更单。哪条业务线开了哪一档、谁批的、对应的回归结论是哪一份,这些要能被查出来。
六、成本算两条线,草稿版本要联动回归
成本核算最常见的错误是把每千词元成本当成唯一指标。开了投机解码以后要分开看两条线。一条是每千词元的算力与计费成本,这一项通常真的降。另一条是同一服务水平下需要的实例数,这一项取决于长尾延迟有没有被回退拖累。如果近似验证让均值变快、却让尾部变慢,为了守住承诺的响应上限,你可能要留更多副本,或者把草稿长度调短,账面收益就又回去了。两条线一起看,才能判断一个提速方案在自家负载上省的到底是什么:有些场景省的是账单,有些省的是高峰排队,还有些其实只省了运维的心理安慰。
最后一件事容易被忽略:草稿模型和大模型不是同一家、也不是同一版训练出来的时候,版本变更要联动做回归。草稿侧一次静默升级,哪怕对外只说修了个小问题,都可能改变接受率的整条衰减曲线,进而改变吞吐与近似通过位置的分布。我们的处置是把草稿模型版本号作为推理服务配置里必须显式登记的字段,与大模型版本号同级;任何一方变更都要触发第三层和第四层回归;发布窗口里两侧不同时改,免得出了问题分不清是哪一侧带来的。
据公开报道,这类免训练的近似验证已经能即插即用地再往上推一档速度。我们要的是另一份东西:一张写清楚哪条业务线可以开、开到哪一档、用哪套回归证明它没坏、版本变更时由谁重新证明的表。批改规则放松之后,加速就不再是免费的,它只是把代价从延迟账单挪到了质量风险上;开关在谁手里、证据留不留得住,才是这套方法能不能进生产的真门槛。