
垂直场景的检索智能体,第一件事是把判分口径写出来|洹拓科技
一、值得抄的不是模型,是模型和判分一起发
有团队开源了一款行业增强的检索模型,同时发布了配套的行业检索评测集。据公开报道,它标注了总参数与激活参数两个口径,可本地部署,工具面接入网页搜索、文件解析、代码执行、数据库和电子表格五类。这些数字和配置不作为本篇的判断依据;我们要抽出来的是另一件事:能力与判分被当作一份交付物发出来了。
行业智能体项目里最常见的僵局不是模型不好,是没人能说清“好”是什么。甲方拿着一个模型跑了几十个自己觉得难的问题,答对了就通过;乙方按自己的理解准备题目,答对了也算通过。两边题不一样、判法不一样、参考答案的口径不一样,最后上线与否靠的是演示现场的感觉。要破这个局,先把判分口径写成一份能执行的文档,再谈模型选型。
二、行业检索为什么比通用检索难判
三个原因让行业检索的判定天生复杂。
- 答案随时间变化。同一个提问,在不同的参考日期下正确答案不同;上周的对冲比例、上季度的口径术语,过了期限就成了错的。通用检索的题可以长期复用,行业的不行。
- 口径由行业惯例或外部规则定义,不由语料频率定义。文档里出现最多的写法未必是合规写法,一个词在行业文本里有两个含义,检索系统按字面命中反而是错的。这类判定无法从“内容看起来相关”推出来。
- 多跳要跨表格与文档。真实问题常常是“从年报的表格里取基数、从监管口径文档里取定义、再算一个比值”,链路里任何一步取错行列,最后数值仍然长得很像正确答案。单看输出的合理性发现不了,只能靠中间留痕。
正因为这三条,行业项目的验收不能引用别人的榜单结论:别人的题里没有你的口径,你的口径里没有你的时间窗。
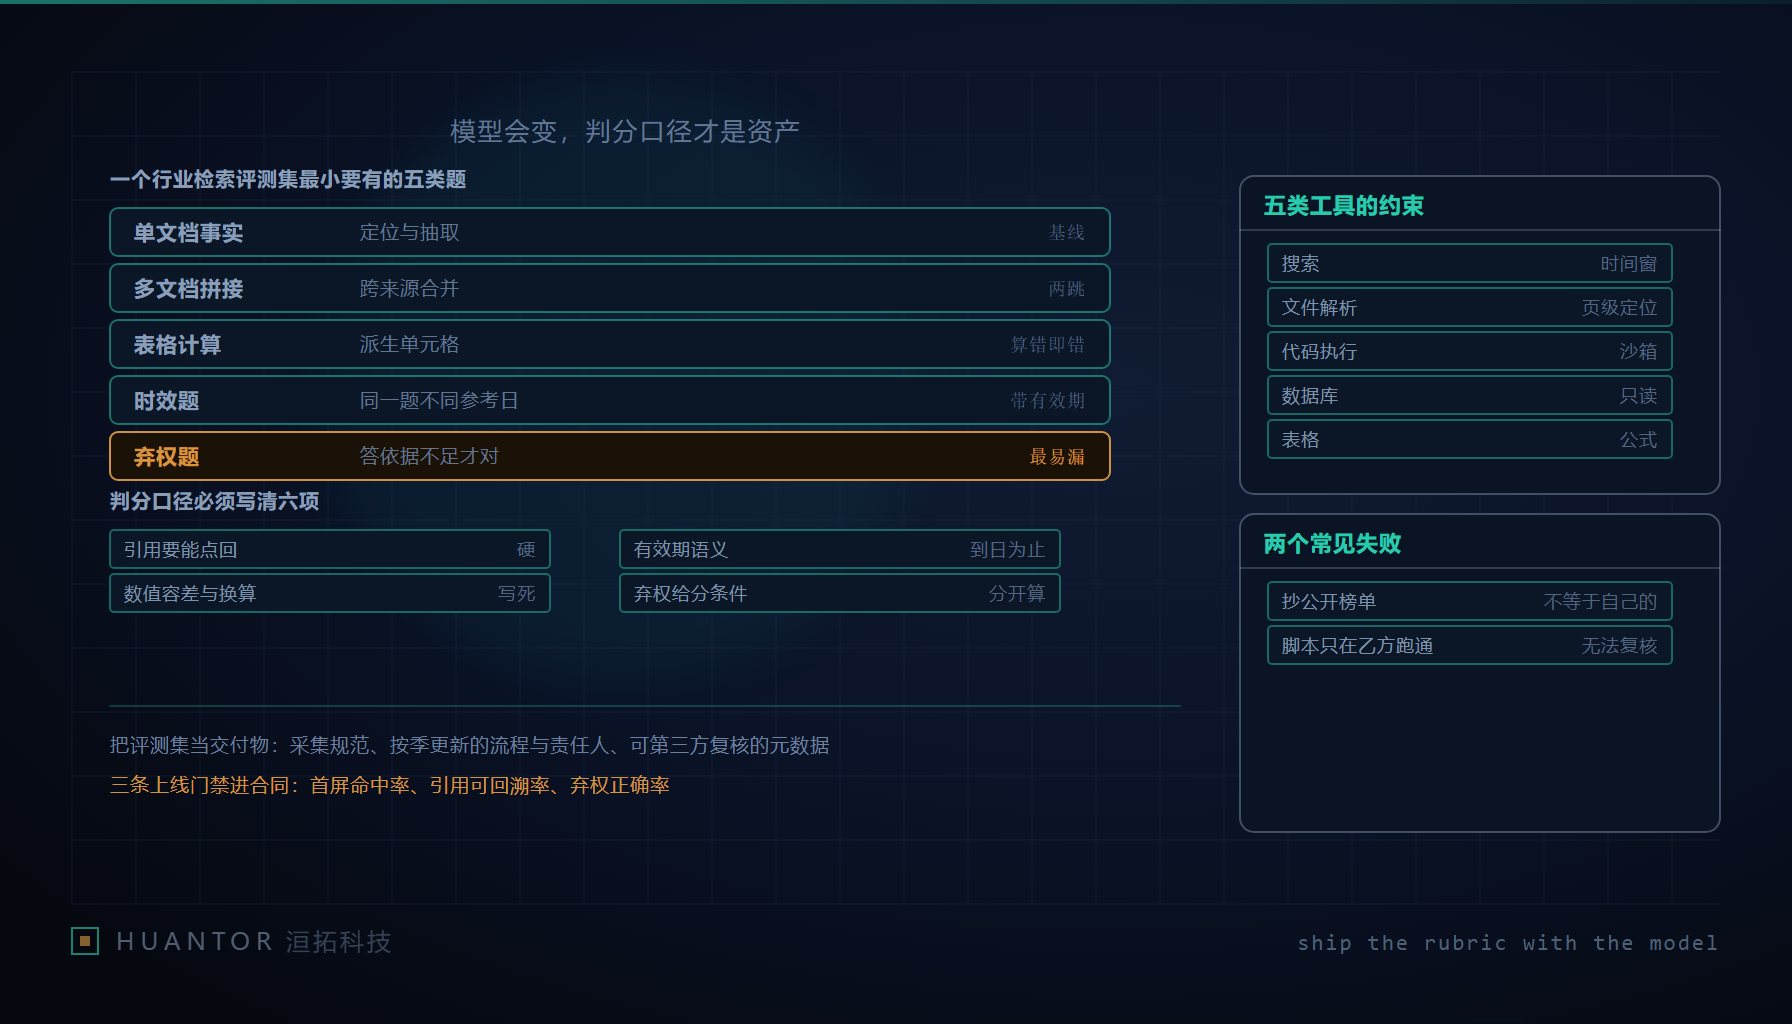
三、评测集最小可用的五类题
一个行业检索评测集不要从大而全开始,先从五类题起步,每类都要有明确的判定意图。
- 单文档事实题。答案在一份文档里唯一存在,考的是定位与取准。这类题用来验证最基础的检索召回,也用来排除解析层故障。
- 多文档拼接题。答案需要两三份文档的信息合并,考的是链路而不是单次命中。出题时要写下合并逻辑,判分才能区分“猜对”和“算对”。
- 表格计算题。需要读表、取列、做一步算术。这类题最能暴露表格还原度问题,也是答案唯一性最好保证的一类。
- 时效题。同一题目在不同参考日期下答案不同,题目里必须带一个明确的判定基准日,并且答案有效期要写字段里。没有基准日的时效题只能作废。
- 弃权题。正确行为是回答“依据不足”或“当前资料无法支持结论”。这一类是行业项目里最常被漏掉的,而它恰恰是最能看出系统成熟度的:不会说不知道的系统,在受控业务里是负债。
题量不重要,五类的比例才重要。我们的做法是把弃权题和时效题当成一票否决项来配比,因为这两类答对的比例最能预测上线后的事故率。
四、判分口径要写死的六项
判分脚本是评测集的一部分,不是附属品。口径文档至少要覆盖六项,缺一项就没法复现分数。
- 引用来源是否必须可点回,以及点回的最小定位单位:文件名、页码、段落还是表格单元格。只写“要有出处”是无效的判定。
- 数值题的容差与单位换算规则。允许几位小数的偏差、百分数与小数是否等价、金额单位换算是否算对、四舍五入方向。这些不写,同一份输出能判出两个分。
- 时效题的答案有效期与判定基准日,以及过期后该题是重做还是下线。
- 弃权题的给分条件:什么措辞算正确弃权,答“不确定但倾向于某值”算对还是算错。这条最容易和人类直觉冲突,必须先定死。
- 格式错误是否扣分。结论正确但字段错位、单位漏写,在演示里像成功,在下游系统里是失败,判定要按下游而不是按可读性。
- 同义改写是否算对。行业术语表要作为判定依据之一:术语表内的等价写法算对,表外的改写按语义判定并记录成待裁决项。
判分口径里最费口舌的通常是弃权题和同义改写两项。它们的共同点是人都能看懂,脚本判不出来。所以口径文档要写成“能翻译成代码的句子”,写完拿十条样本来回判一次,人和脚本不一致就说明这条写得不够硬。
五、五类工具接入面各自要定的约束
工具编排的约束要写在接入规格里,而不是等联调时口头约定。五类工具各有各的坑:
| 工具面 | 必须定的约束 | 不定会发生什么 |
|---|---|---|
| 网页搜索 | 时间窗上下界、来源白名单与黑名单、快照留存 | 结论引用到过期公告,事后无法回溯当时看到的内容 |
| 文件解析 | 页级定位粒度、表格还原度要求、扫描件与图文混排的处理 | 引用只能指到文件,指不到位置和行列 |
| 代码执行 | 沙箱边界、是否可出网、依赖白名单、资源上限 | 计算脚本碰到生产数据或把结果发出去 |
| 数据库 | 只读账号、行级与字段级权限、可查表清单、单次扫描上限 | 一次检索把不该看的数据取进上下文 |
| 电子表格 | 公式与派生单元格如何处理、取计算值还是取公式、跨表引用 | 把空公式结果或过期缓存当成原始事实 |
这五项里,页级定位与派生单元格处理最容易被低估。定位粒度决定了引用可回溯率能不能测,派生单元格处理决定了表格计算题的参考答案是否唯一。评测集要在约束定下来之后再冻结,否则同一批题在不同解析配置下答案会漂。
六、评测集作为交付物:三份配套、两条纪律
把评测集当成资产交付,除了题目本身还要三份配套。第一份是题目与答案的采集规范:题目从哪些真实工单与咨询里来、参考答案由谁核定、争议题怎么仲裁、口径变化后哪些题要重做。第二份是按季度的更新流程与责任人:谁出题、谁复核、谁下线过期题,没有责任人的评测集半年后就没人敢用。第三份是第三方复核所需的元数据:题目来源、判定基准日、有效窗口、判定依据条目号、上次复核时间,让外部的人能不看脚本就重算一遍。
两条纪律对应行业项目最常见的两个失败。
其一,评测集是从公开榜单抄来的。抄来的题里没有你的口径、你的时间窗和你的弃权场景,分数再高也只做了一件事:证明模型在别人的题上表现不错。这类项目上线后出问题的位置,几乎都落在时效与弃权两类题上。在洹拓接的行业检索项目里,我们坚持把第一版评测集的题目量压小,但五类题一类不缺,宁可每类只有很少的题,也不要一个只有事实题的大集合。
其二,判分脚本只在乙方手里跑得过。环境、依赖、内部字段名没交代,甲方接手后跑不出同一个分数,验收当天变成远程调试。处置办法很朴素:判分脚本随题目一起交付,用样例数据跑通一次给甲方看,输出口径写成文件,并把“甲方独立复跑得到同样结论”写进验收条款。
三条上线门禁建议直接写进合同而不是留作内部指标:首屏命中率——目标内容出现在返回前几位;引用可回溯率——每条结论能点回具体位置;弃权正确率——该说依据不足时说了,不该弃的时候没乱弃。这三条可测、可复核、可反查,且都不依赖模型厂商的自述数字。把它们写进合同的意义在于:一旦某条连续几次不达标,触发的是重新回归而不是重新谈判口径。
行业模型的选型还会继续变,接入的工具也会换。真正沉淀在客户手里的,是那套题目、口径和留痕格式——这也是能力与判分一起发这个动作给行业交付的真正提示。