
同一组层反复跑:循环深度换的不是显存是延迟|洹拓科技
一、旧经验为什么成立过
公开讨论里有一种架构走向:让同一组 Transformer 层反复运行,在不增加同等规模参数量的前提下把计算做深,对外叙述的卖点是模型不必继续”长肉”,输出的思考词元也随之减少;这种循环深度此前也被其他团队用在别的方向上。机制描述到这里就是全部,深度轮数、时延与显存表现都没有公开数据,所以本篇一个数字也不引用,只把这套机制放到部署侧去问它会改动什么。
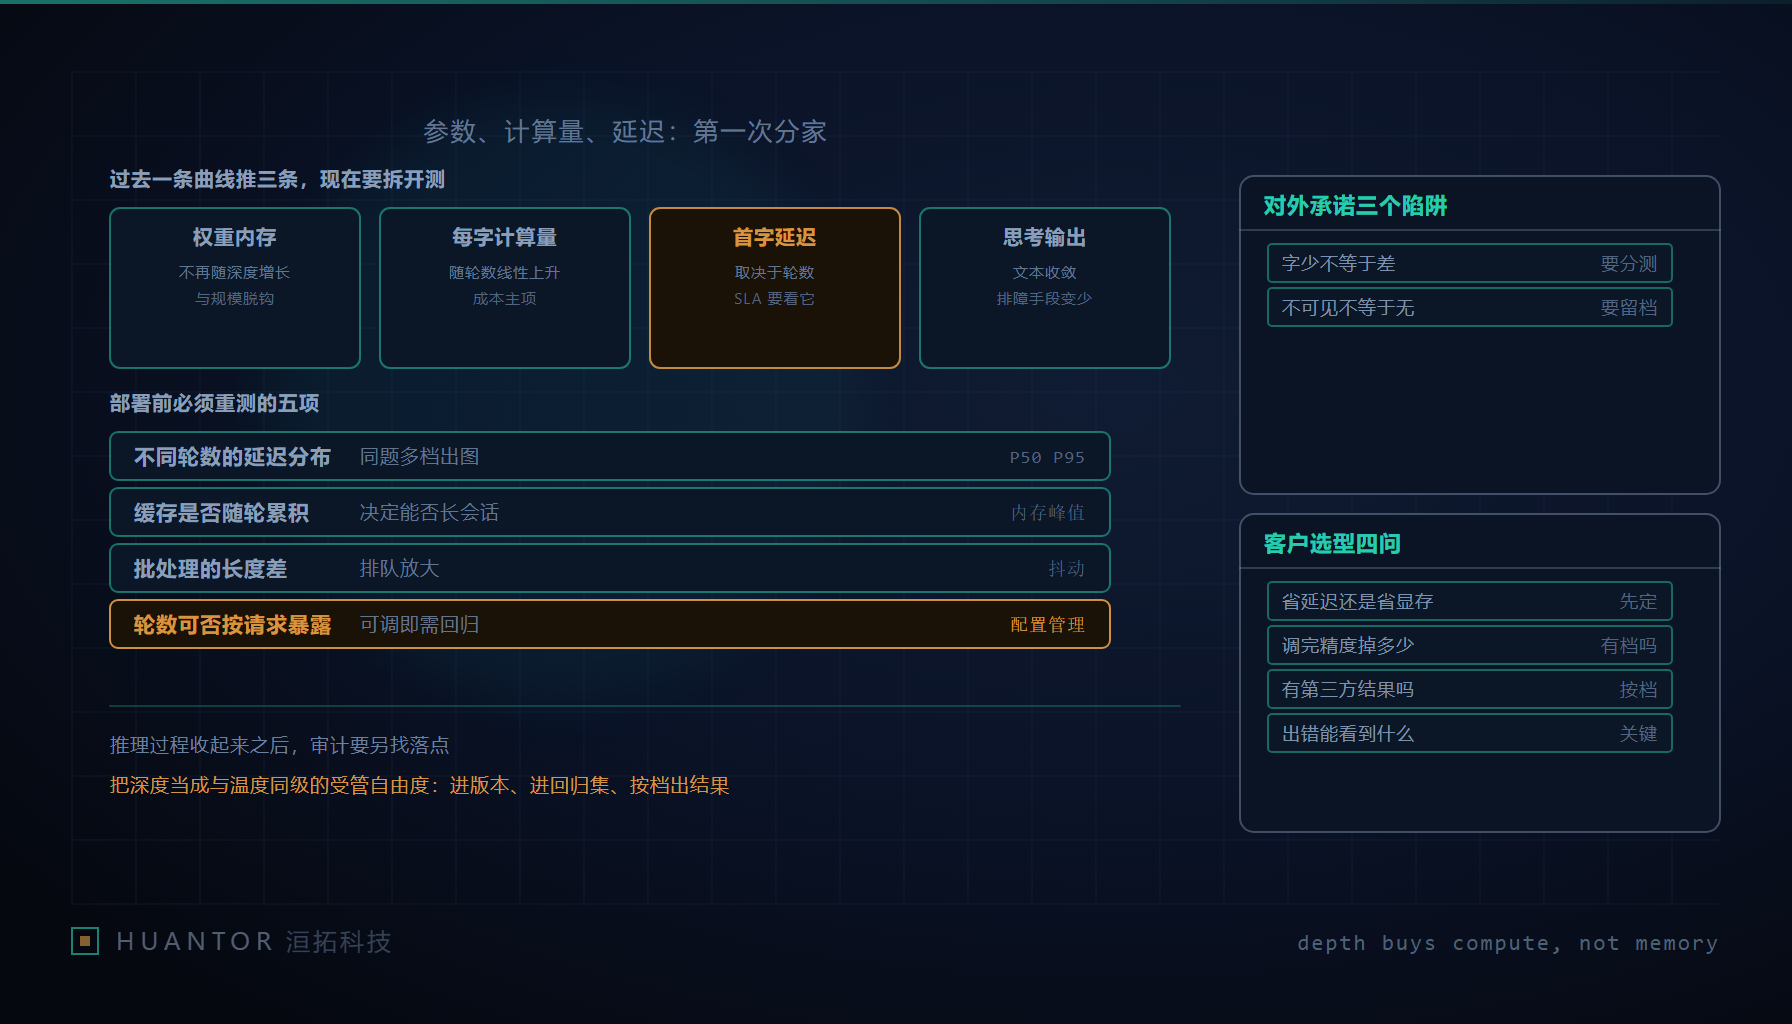
过去几年按参数量估成本是有效的,原因有两条。一是权重占用主导显存:模型加载后,常驻的那部分基本由参数规模决定,缓存和中间激活是加数而不是被加数。二是每词元的计算量与参数量近似同步:层数与隐藏维一起长,一次前向的算量就跟着规模走。这两条同时成立时,一条曲线就能推出另外两条——知道参数量,就能粗估显存占用、单卡能否装下、批大小上限和单位吞吐。整套报价、容量规划、SLA 承诺都建在这个近似上。它不是自然规律,是特定架构形态下的巧合。
这条巧合撑着的是一串很具体的日常动作:售前按标称规模报单位成本,运维按规模决定卡数与并发上限,测试按规模判断回归集需要跑多大。三段用的是同一个入口数字,所以过去即使没人实测,误差也不会大到出事。循环深度把这串动作的公共入口拆掉了:规模报出去,既推不出该配几张卡,也推不出首字延迟落在哪一段,更推不出回归集该怎么分层。此时如果还沿用旧报价表,误差方向是不确定的,可能高估也可能低估,这比系统性偏高更难处理。
二、三项第一次分家
循环深度动的正是这个巧合。同一组权重多跑几遍,参数不涨,但每次生成的算量涨;算量涨了,延迟跟着涨;显存里权重那部分不变,变的是中间状态的留存方式。
| 被拆开的三项 | 由什么决定 | 为什么不能再由另两项推出 |
|---|---|---|
| 权重内存占用 | 参数规模与精度位宽 | 深度轮数不增加这一项,所以看到”参数量没变”就断言”机器成本没变”是错的 |
| 每词元计算量 | 单次前向的算量乘以重复运行的轮数 | 它与参数量脱钩后,规模相同不代表算量相同,吞吐与延迟不能按老档位查表 |
| 端到端首词元延迟 | 轮数、批处理形状、调度排队、中间状态的读写次数 | 它同时受算量与并发影响,与显存占用没有稳定的对应关系 |
麻烦的地方在第三行。首词元延迟不是算量的线性放大:批里长短不一时,一个长请求会把同批的其他请求一起拖住;中间状态如果按轮数累积,显存的峰值会远高于稳态,调度器为了留余量只能压批大小,压批又推高排队。这几项互相咬合,任何一项用旧经验代推都会算错,只能实测。
三、部署侧要重测的五项
- 同一提示在不同深度轮数下的延迟分布。要看的是分位数而不是均值,均值会把轮次带来的整体平移掩盖掉。
- 中间缓存是否随轮数累积。判法是固定输入长度、只改轮数,观察显存曲线的斜率;如果斜率明显,容量规划要按最坏轮数做而不是按标称轮数做。
- 批处理的长度差异带来的排队放大。循环结构对批内不齐更敏感,长尾请求会占用更多重复计算时间,进而放大整个批的等待。
- 显存峰值与稳态的差。峰值决定单卡能不能装下并发,稳态决定你能开多大并发,用同一个数字规划会两头出错。
- 深度轮数能不能作为请求级参数暴露。这决定了你能否在同一套权重上按业务分档:简单题走浅档、复杂题走深档。暴露不出来,就等于只有一个档位,成本曲线失去了可调性。
这五项的测法也要统一口径,否则不同人测出来的数没法比:固定同一组提示与同一硬件,一次只改一个变量,每档轮数至少跑满一个批处理周期,把均值、分位数、显存峰值与稳态一并记进同一张表,并把测试时的批形状一起留存。只在单请求空载下测出来的延迟分布,上线后一定对不上。
四、”思考词元变少”翻译成对外承诺时的三个陷阱
对外叙述里最容易被接走的是”输出的思考词元减少”,因为字数是用户看得见的。三个陷阱都藏在这里。
其一,用户看到的字数减少,不等于结论更好,也不等于更差。字数是表意通道的产物,深度是计算量,两者在循环架构里已经不同步。承诺里写”回答更短”,验收时就会变成对长度的约束,而客户真正要的是同等长度下的正确率。
其二,内部隐式计算不可审计。文本化的推理过程哪怕粗糙,也留下了”它在哪一步开始偏”的线索;计算收进重复的层里之后,外部只能看到输入和最终输出,中间没有可指认的对象。这在有合规要求的行业不是小问题:审计要的是过程证据,不是结果一致。
其三,排障手段要另建。很多团队现在处理疑难样本的方式,是把推理过程贴进工单一起看。过程不可见之后,工单里就只剩下输入、输出和复现条件,定位质量下降是即时的。这一条要在承诺里主动写清楚,等客户遇到第一个难案再解释,就会被读成掩饰。
五、可观测性退化的三条对策
- 暴露可控的深度档位,并按档做回归。每个档位是一条独立的能力曲线,也要有独立的评测结果与独立的告警阈值;只给”低中高”三个名字而没有按档数据的,等于没暴露。
- 保留按请求抽样的展开模式输出。即对一部分请求(按抽样比例或按客户显式申请)让模型把中间判断重新以文本形式给出,用来对照隐式计算的结果。要写清展开模式与常规模式的差异边界,否则会被当成同一回事比较。
- 在评测里加”同一题两次采样答案是否一致”这一稳定性判据。深度收起来之后,最典型的退化不是平均准确率下降,而是同题摆动变大,而这类退化在只跑一次的评测集上是看不见的。
六、客户选型四问,以及把深度当成受管自由度
面对这类架构,客户方的四个问题应该按顺序问:这个架构在你的负载形状上是省延迟还是省显存——离线批量与在线交互的答案可以完全相反;深度能不能调,调完之后精度掉多少,掉在哪类任务上;有没有按档位的第三方结果,只有单一档位结果的说明没做过分档回归;出问题之后你能看到什么,看得到的是中间状态、还是只有输入输出。四个问题里第三个最容易得到空答案,也是验收时最该写进合同的一条。
给自研团队的建议只有一句,但要执行得很硬:把深度当成一个进配置管理的自由度,和温度、采样数同级对待。它进版本号、进变更记录、进回归集,任何一次默认值调整都要重跑按档回归,并按档位保留可回滚的历史。把深度写成代码里的常量,等于把一个会改变成本与能力分布的变量藏进了实现细节,出了事故没人能复盘。这一条在洹拓自己的训练与推理配置规范里,我们把它列进了和采样参数同一张表:可调、可追、可按档复现,缺一项就不许进生产。